Tűzifa vásárlása és tárolása: mire figyeljünk a fűtési szezonban?
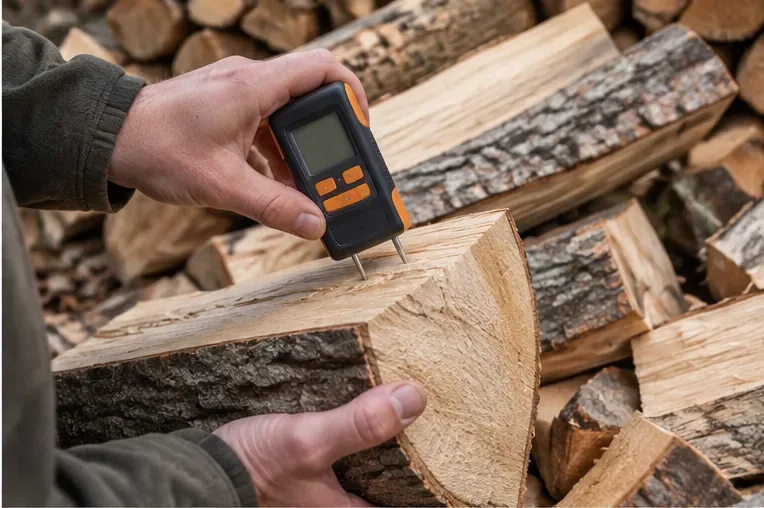
Gyakorlati útmutató kezdőknek tűzifavásárláshoz: eladó ellenőrzése, mennyiség és nedvesség, átvétel, szellős tárolás és biztonságos fűtés.
A rövid válasz: a felhőplatformok széles körű leállása általában hibák láncolatából ered, nem egyetlen elszigetelt, meghibásodott szerverből. Egy kockázatos konfiguráció vagy szoftvermódosítás befolyásolhat egy megosztott függőséget, például az identitást, a DNS-t, az engedélyezést vagy egy vezérlősík API-t. Az első hiba ezután újrapróbálkozásokat, forgalomeltolódásokat vagy automatikus skálázást vált ki, ami növeli a terhelést, és a hatást régiók vagy termékek között elosztja. A gyenge megfigyelhetőség és a nem tesztelt helyreállítási útvonal meghosszabbíthatja a leállást.
Ez a minta azért fontos, mert megváltoztatja, hogy mire kell felkészülni. A „felhő” nem egyetlen gép, és a „szolgáltató leállt” nem teljes diagnózis. Az alkalmazás több szolgáltatói szolgáltatástól, a saját konfigurációtól, külső API-któl és egy olyan helyreállítási folyamattól függhet, amely csak akkor működik, ha tesztelték. Ez az útmutató ismerteti a fő okokat, azt, hogy mit kell először ellenőriznie egy kezdőnek, és azokat a hibákat, amelyek megnehezítik a széles körű leállások kezelését.

Az elérhetőség azt jelenti, hogy egy szolgáltatás sikeresen képes-e válaszolni egy kérésre. A teljesítményromlás azt jelenti, hogy túl lassan vagy magas hibaszázalékkal válaszol. Egy szélesebb körű incidens befolyásolhatja az adatsíkot – az alkalmazásforgalmat kiszolgáló rendszereket – vagy a vezérlősíkot – az erőforrások létrehozásához, konfigurálásához, hitelesítéséhez és kezeléséhez használt API-kat és belső rendszereket. A vezérlősík leállása megakadályozhatja a telepítéseket vagy a skálázást, még akkor is, ha a már futó munkaterhelések továbbra is kiszolgálnak bizonyos forgalmat.
A megosztott függőség egy olyan szolgáltatás, amelyre számos termék vagy kérésútvonal támaszkodik. Gyakori példák erre a DNS, az identitás- és hozzáférés-kezelés, a tanúsítványérvényesítés, az útvonalválasztás, a metaadatok, a kvóták és a megfigyelhetőség. Ha ez a függőség központosított vagy közös hibamóddal rendelkezik, egy kis hiba sokkal nagyobb hatótávolsággal rendelkezhet – az egyetlen hiba által érintett ügyfelek, régiók vagy szolgáltatások halmazával.
A változtatások a nagyszabású incidensek egyik vezető forrását jelentik, mivel az egyik kontextusban helyesek lehetnek, míg platformszinten nem biztonságosak. Egy engedélyszerkesztés, útválasztási szabály, funkciójelző, sémamódosítás vagy automatizált kapacitásművelet minden régiót vagy minden ügyféllel kapcsolatba kerülő gépet érinthet. Az automatizálás felerősítheti az eredményt, mielőtt egy ember látná.
A Cloudflare 2025. november 18-i hivatalos utólagos elemzése jól szemlélteti ezt a hibaosztályt. Egy adatbázis-engedélyek változása duplikált sorokat okozott egy Bot Management funkciófájlban. A fájl nagyjából kétszer akkora lett, világszerte elterjedt a gépeken, és meghaladta az útválasztó szoftverekben megengedett korlátot. A Cloudflare szerint az incidenst nem kibertámadás okozta; a hiba konfigurációs és szoftveres interakcióból eredt. A vállalat leállította a terjedést, és egy ismert, jó fájlt telepített. A szolgáltató részletes beszámolójáért olvassa el a Cloudflare 2025. november 18-i leállás utólagos elemzését .
Az alapvető szolgáltatások gyakran számos, látszólag egymással nem összefüggő termék mögött helyezkednek el. Az identitás, az engedélyezés, a belső DNS, a monitorozás, a metaadatok és az erőforrások kiépítéséhez használt API-k gyakori hibaforrássá válhatnak. Az ügyfelekkel kapcsolatos tünetek eltérőek lehetnek – bejelentkezési hibák, telepítési hibák, időtúllépések vagy hiányzó metrikák –, de az alapul szolgáló függőség ugyanaz lehet.
A 2021. december 7-i US-EAST-1 esemény utáni összefoglalójában az AWS egy váratlan interakciót írt le, amely az automatizált skálázási tevékenységet és a belső hálózati eszközöket érintette. Az AWS szerint az érintett hálózat alapvető szolgáltatásokat üzemeltetett, beleértve a monitorozást, a belső DNS-t, az engedélyezési szolgáltatásokat és az EC2 vezérlősík egyes részeit. A csatlakozási kísérletek és az újrapróbálkozások ezután hozzájárultak a torlódáshoz. Az AWS arról is beszámolt, hogy a Support Contact Center és a szolgáltatás-állapot kommunikációs útvonalának egyes részei érintettek. Az AWS esemény utáni összefoglalója hasznos példa arra, hogy miért okozhat nehézséget egy szolgáltatónak a szolgáltatások helyreállítása és egyidejű diagnosztizálása.
Amikor egy kérés sikertelen, az ügyfelek gyakran újrapróbálkoznak. Újrapróbálkozási vihar akkor fordul elő, ha sok ügyfél egyszerre próbálkozik újra, különösen exponenciális visszatartás – egy olyan stratégia, amely növeli a kísérletek közötti várakozási időt – és időzítés (jitter) nélkül, amely kis véletlenszerű késleltetést okoz. Ezek az újrapróbálkozások ugyanazt a szűkös kapacitást fogyasztják, és egy részleges hibát nagyobb kieséssé alakíthatnak.
További terhelési szorzók lehetnek a túl gyakran futó állapotellenőrzések, az automatikus feladatátvétel, amely egy már amúgy is forgalmas régióba küldi a forgalmat, a várakozó feladatokat egyszerre feloldó várólisták, valamint az olyan automatikus skálázási szabályzatok, amelyek a tünetekre reagálnak, nem pedig az okra. Egy szolgáltatás ezért akkor is meghibásodhat, ha a szerverei fizikailag nem hibásodtak meg. A fontos kérdés nemcsak az, hogy „Tud-e a szolgáltató kapacitást növelni?”, hanem az is, hogy „Vajon az ügyfeleink és az automatizálás további munkát adnak-e a meghibásodási útvonalhoz?”
A felhőplatformok továbbra is függenek a fizikai adatközpontoktól, energiaellátó rendszerektől, hűtéstől, optikai kábeles kapcsolatoktól, útválasztóktól, tárolóeszközöktől és regionális hálózati útvonalaktól. A redundancia csökkenti a kockázatot, de nem tesz minden hibát láthatatlanná. Egy megosztott létesítmény, rendelkezésre állási zóna, régiók közötti kapcsolat vagy útvonalhatár egyszerre számos szolgáltatást érinthet.
A regionális helyreállítás egyenetlen is lehet. A Google Cloud 2025. június 12-i incidensnyilvántartásában arról számolt be, hogy több termékben is API-problémák jelentkeztek egy mögöttes függőséghez kapcsolódóan, és a helyreállítás helyszínenként eltérő volt; a nyilvántartás konkrétan megjegyezte a lassabb helyreállítást az us-central1, valamint az US és a több régióra kiterjedő szolgáltatásokban. A Google Cloud Service Health incidensnyilvántartása rámutat, hogy miért nem elegendő egyetlen régió vagy egyetlen termék ellenőrzése a teljes körű probléma megértéséhez.
Egy platform lehet egészséges, amíg váratlan bemenetet nem kap: egy olyan fájlt, amely nagyobb, mint az elemző korlátja, egy duplikált rekordot, egy szokatlan API-választ vagy egy olyan adatmigrációt, amely egy régebbi kódban található feltételezést tesz elérhetővé. Ezek a hibák különösen veszélyesek, ha ugyanaz a kiadás vagy konfiguráció globálisan terjed.
A kemény korlátok nem mindig nyilvánvalóak a normál tesztelésből. Egy konfigurációs fájl érvényes lehet, de túl nagy egy downstream komponens számára. Egy kérési arány elfogadható lehet egy régióban, de a feladatátvétel után meghaladhatja a kvótát. Egy helyreállítási feladat egyszer biztonságos lehet, de ismétléskor duplikált munkát okozhat. A tesztelésnek ki kell terjednie a hibás adatokra, a részleges függőségi hibákra, a regionális evakuálásra és az ismételt végrehajtásra – nem csak a boldog utat.
Az elosztott szolgáltatásmegtagadási támadások, az ellopott hitelesítő adatok, a visszaélések és a rosszindulatú konfigurációs változtatások okozhatnak szolgáltatáskimaradásokat. A forgalomcsúcs vagy a hitelesítési hiba azonban nem bizonyítja a támadás megtörténtét. Ha minden incidenst biztonsági eseményként kezelünk, az rossz irányba terelheti a választ, és késleltetheti a konfiguráció visszaállítását.
Használjon bizonyítékokat: hasonlítsa össze a kérésmintákat, a hitelesítési naplókat, a változásrekordokat, a szolgáltatók állapotfrissítéseit és a független vizsgálatokat. Tartsa elérhetővé a biztonsági eszkalációt, de válassza szét az „amit tudunk” és az „amit gyanítunk”. A Cloudflare 2025-ös utóelemzése konkrét emlékeztető arra, hogy egy kiesés kezdetben támadásnak tűnhet, és mégis más kiváltó oka lehet.
Egy leállás nehezebben kezelhetővé válik, ha a monitorozó rendszer ugyanattól a hibalehetőségtől függ, mint az alkalmazás. Egy irányítópult megmutathatja, hogy egy virtuális gép fut, miközben az ügyfelek nem tudnak végrehajtani egy tranzakciót. A Google Cloud ügyfélközpontú SLO-kra és egyéni mérőszámokra vonatkozó útmutatója elmagyarázza ezt a különbséget: az infrastruktúra üzemideje nem ugyanaz, mint egy sikeres ügyfélművelet.
Használjon legalább egy független szintetikus ellenőrzést – egy ütemezett tesztet, amely biztonságos, ügyfél-szerű tranzakciót hajt végre – az érintett környezeten kívülről. Tartson fenn egy második módot az incidensfrissítések eléréséhez, és rögzítse a szolgáltató állapotoldalait, a belső riasztásokat és az ügyféljelentéseket egyetlen idővonalon. Ne feltételezze, hogy egy állapotoldal tévedhetetlen: A Cloudflare arról számolt be, hogy a saját állapotoldala sem volt elérhető a 2025. novemberi incidens során, bár a Cloudflare infrastruktúráján kívül tárolták.
Kezdj egy egyszerű függőségi térképpel. Tartalmazd a DNS-t, az identitást, a titkos kódokat, a tanúsítványokat, a várólistákat, az adatbázisokat, az objektumtárolást, a harmadik féltől származó API-kat, a tartalomszolgáltatást, a monitorozást és a szolgáltatói régiót. Jelöld meg, hogy mely komponensek szükségesek minden kéréshez, és melyek csökkenthetők vagy megkerülhetők. Ez a gyakorlat gyakran azt mutatja, hogy két „független” régió továbbra is megosztja az identitást, a DNS-t, a telepítési eszközöket, vagy egyetlen külső szállítót.
Határozza meg az RTO-t (helyreállítási idő célkitűzés, a szolgáltatás helyreállításának célidő) és az RPO-t (helyreállítási pont célkitűzés, az adatvesztés elfogadható mértéke időben mérve). Ezután válassza ki az üzleti igényeknek megfelelő vezérlőket. Egy kis belső irányítópult elfogadhatja a manuális helyreállítást. Egy fizetési vagy vészhelyzeti munkafolyamathoz több régióra kiterjedő szolgáltatásra, tesztelt adatreplikációra és dokumentált feladatátvételi tulajdonosra lehet szükség.
| Korai nyom | Valószínű ok | Előkészítés vagy ellenőrzés |
|---|---|---|
| A hibák azonnal megjelennek a telepítés vagy a szabályzat módosítása után | Konfiguráció vagy szoftvermódosítás | Canary kiadások, jóváhagyások, verziókövetés és gyors visszagörgetés |
| Több termék sem hitelesíti vagy oldja fel a neveket | Megosztott identitás, engedélyezés vagy DNS-függőség | Függőségi leképezés és független hozzáférési útvonal |
| A késleltetés az újrapróbálkozások számának növekedésével nő | Túlterhelés vagy újrapróbálkozás vihar | Visszacsapódás, időzítés, megszakítók és terheléscsökkentés |
| Az egyik régió felépül, míg a másik károsodott marad | Regionális kapacitás- vagy függőségi különbség | Tesztelt több régióból álló feladatátvétel és regionális runbookok |
| Az infrastruktúra egészségesnek tűnik, de a tranzakciók kudarcot vallnak | Megfigyelhetőségi rés vagy downstream függőség | Ügyfélszintű SLO-k és szintetikus tranzakció-ellenőrzések |
A széles körű felhőleállások fő okai az egymással kölcsönhatásban lévő rendszerek: nem biztonságos változások, megosztott függőségek, túlterhelés és újrapróbálkozások, regionális infrastruktúra-hibák, szoftver- és adatformációs hibák, biztonsági vagy forgalmi események, valamint a vakfoltok az észlelésben. Nem lehet minden szolgáltatói kiesést kiküszöbölni, de korlátozni lehet a robbanási hatókörét. Térképezze fel a függőségeket, mérje az ügyfelek eredményeit, tegye udvariassá az újrapróbálkozásokat, tartsa visszafordíthatónak a változtatásokat, tesztelje a feladatátvételt, és vezessen olyan incidensnyilvántartást, amely megkülönbözteti a tényeket a hipotézisektől.
Forrásmegjegyzés: Ezt a cikket 2026. szeptember 16-án ellenőriztük. A szolgáltatói incidensek dokumentált példák, nem teljes lista, és a szolgáltatói utólagos elemzések nem feltétlenül fednek fel minden belső részletet. A terméknevek, architektúrák, állapotoldalak és a helyreállítási viselkedés idővel változhat.
Gyakorlati útmutató kezdőknek tűzifavásárláshoz: eladó ellenőrzése, mennyiség és nedvesség, átvétel, szellős tárolás és biztonságos fűtés.
Mire használható ma a mesterséges intelligencia? Gyakorlati példák, ellenőrzési szabályok, adatvédelmi szempontok és az EU AI Act aktuális ütemezése.
Tekintse át a 2025-ös jelentős Salesforce-kimaradásokat, a meghibásodás okát, a kiválasztott incidensek időtartamát, és a gyakorlatban alkalmazható rugalmassági tanulságokat, amelyeket a csapatok alkalmazhatnak.
Készítsen egy praktikus Salesforce leállás-folytonossági tervet hatáselemzéssel, RTO/RPO célokkal, manuális megkerülő megoldásokkal, integrációs vezérlőkkel és helyreállítási ellenőrzésekkel.
Ismerje meg, hogyan veheti fel a kapcsolatot a Salesforce ügyfélszolgálatával nagyobb kimaradás esetén: ellenőrizze a megbízhatósági állapotot, válassza ki a megfelelő csatornát, nyisson egy erős esetet, és kövesse nyomon a helyreállítást.
Elháríthatja a Salesforce Workbench bejelentkezés, REST Explorer, időtúllépés, 503-as hiba és API-verzió hibáit, és korlátozhatja a leállás során fellépő hibákat egy praktikus diagnosztikai ellenőrzőlista segítségével.
A StoreForce problémák megzavarhatják az ütemezést, az időbeosztást és az alkalmazottak munkafolyamatait. Ismerje meg, hogyan értékelheti a hatásokat, hogyan tarthatja fenn az üzletek működését, hogyan ellenőrizheti a helyreállítást, és mikor kell eszkalálni.
Ismerje meg a széles körű felhőszolgáltatás-leállások fő okait, a hibák kaszkádszerű terjedését, a legfontosabb ellenőrzési szempontokat, és a rugalmasabb helyreállítási terv kidolgozásának módját.
Ha a Datorama vagy a Marketing Cloud Intelligence működési zavart mutat, használja ezt a bizonyítékokon alapuló ellenőrzőlistát a kimaradás ellenőrzésére, a jelentéskészítés minőségének védelmére, és annak megállapítására, hogy mikor megbízhatóak ismét az adatok.
Gyakorlati áttekintés arról, hogyan befolyásolhatják a Heroku leállásai a telepített alkalmazásokat, a dinamométereket, az útvonaltervezést, az adatbázisokat, a telepítéseket, a Heroku Connectet, a naplókat és a helyreállítást.