Xbox Series X vs. PlayStation 5: kterou konzoli vybrat v roce 2026?
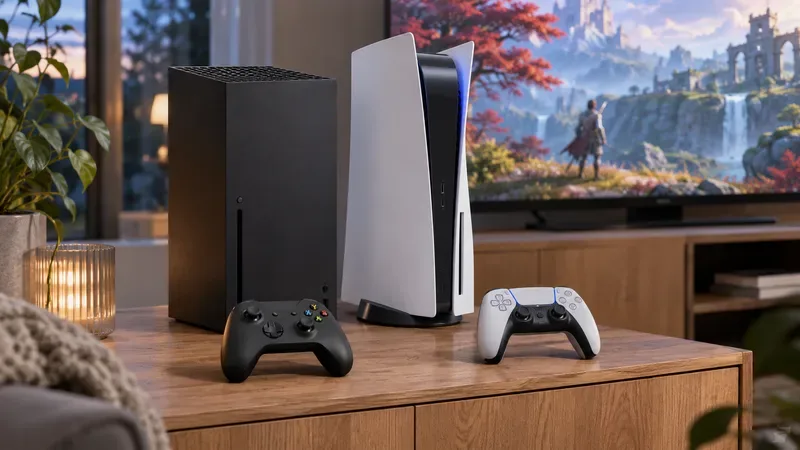
Srovnání Xbox Series X a PS5 pro české hráče: výkon, hry, ovladače, disky, úložiště i to, co zkontrolovat před nákupem.
Stručná odpověď: rozsáhlé výpadky cloudové platformy obvykle pramení z řetězce selhání, nikoli z jednoho izolovaného nefunkčního serveru. Riziková konfigurace nebo změna softwaru může ovlivnit sdílenou závislost, jako je identita, DNS, autorizace nebo API řídicí roviny. První selhání pak spustí opakované pokusy, přesuny provozu nebo automatické škálování, což zvyšuje zátěž a rozkládá dopad napříč regiony nebo produkty. Slabá pozorovatelnost a neotestovaná cesta obnovy mohou výpadek prodloužit.
Tento vzorec je důležitý, protože mění to, na co byste se měli připravit. „Cloud“ není jeden stroj a „poskytovatel je nefunkční“ není úplná diagnóza. Vaše aplikace může záviset na několika službách poskytovatele, vaší vlastní konfiguraci, externích API a procesu obnovy, který funguje pouze tehdy, pokud byl otestován. Tato příručka vysvětluje hlavní příčiny, co by měl začátečník nejprve zkontrolovat a chyby, které ztěžují zvládání rozsáhlého výpadku.
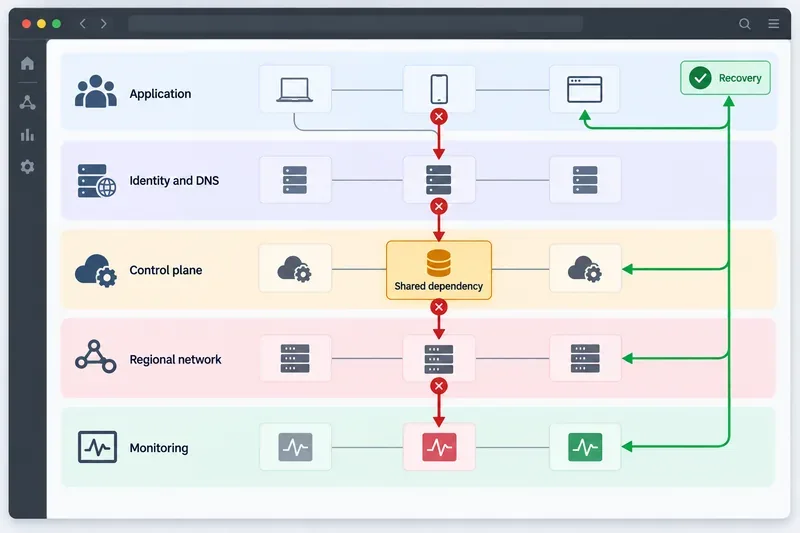
Dostupnost udává, zda služba dokáže úspěšně odpovědět na požadavek. Snížení výkonu znamená, že odpovídá, ale příliš pomalu nebo se zvýšenou chybovostí. Rozsáhlý incident může ovlivnit datovou rovinu – systémy, které obsluhují aplikační provoz – nebo řídicí rovinu – API a interní systémy používané k vytváření, konfiguraci, ověřování a správě zdrojů. Výpadek řídicí roviny může zabránit nasazení nebo škálování, i když již spuštěné úlohy nadále obsluhují určitý provoz.
Sdílená závislost je služba, na které se spoléhá mnoho produktů nebo cest požadavků. Běžnými příklady jsou DNS, správa identit a přístupu, ověřování certifikátů, směrování, metadata, kvóty a pozorovatelnost. Pokud je tato závislost centralizovaná nebo má společný režim selhání, může mít malá vada mnohem větší poloměr šíření – skupinu zákazníků, regionů nebo služeb ovlivněných jedním selháním.
Změny jsou hlavním zdrojem velkých incidentů, protože mohou být správné v jednom kontextu a nebezpečné na úrovni platformy. Úprava oprávnění, pravidlo směrování, příznak funkce, změna schématu nebo automatizovaná akce kapacity se může dotknout každé oblasti nebo každého počítače orientovaného v kontaktu se zákazníkem. Automatizace může zesílit výsledek dříve, než ho člověk uvidí.
Oficiální analýza výpadku od Cloudflare z 18. listopadu 2025 ilustruje tuto třídu selhání. Změna oprávnění databáze způsobila duplicitní řádky v souboru funkce Bot Management. Soubor se zhruba zdvojnásobil, rozšířil se na počítače po celém světě a překročil limit v směrovacím softwaru. Cloudflare uvádí, že incident nebyl způsoben kybernetickým útokem; selhání vzniklo v důsledku interakce konfigurace a softwaru. Společnost zastavila šíření a nasadila soubor, o kterém se ví, že je v pořádku. Přečtěte si analýzu výpadku od Cloudflare z 18. listopadu 2025, kde naleznete podrobný popis poskytovatele.
Základní služby se často nacházejí pod mnoha zdánlivě nesouvisejícími produkty. Identita, autorizace, interní DNS, monitorování, metadata a API používaná k poskytování zdrojů se mohou stát častým bodem selhání. Příznaky, se kterými se zákazníci setkávají, mohou vypadat odlišně – selhání přihlášení, chyby při nasazení, časové limity nebo chybějící metriky – ale základní závislost může být stejná.
Ve svém shrnutí po události US-EAST-1 ze 7. prosince 2021 popsala společnost AWS neočekávanou interakci zahrnující automatizovanou škálovací aktivitu a interní síťová zařízení. AWS uvedla, že postižená síť hostovala základní služby, včetně monitorování, interního DNS, autorizačních služeb a částí řídicí roviny EC2. Pokusy o připojení a opakované pokusy o připojení pak přispěly k přetížení. AWS také uvedla, že bylo ovlivněno její kontaktní centrum podpory a části komunikační cesty pro kontrolu stavu služeb. Shrnutí AWS po události je užitečným příkladem toho, proč může mít poskytovatel potíže s obnovou služeb a jejich diagnostikou současně.
Když se požadavek nezdaří, klienti se často pokusí o opakování. Bouře opakování nastává, když mnoho klientů pokouší o opakování najednou, zejména bez exponenciálního odkládání – strategie, která prodlužuje čekání mezi pokusy – a chvění, které přidává malé náhodné zpoždění. Tyto opakování spotřebovávají stejnou omezenou kapacitu a mohou z částečného selhání udělat větší výpadek.
Mezi další multiplikátory zátěže patří příliš časté kontroly stavu, automatické přepnutí při selhání, které odesílá provoz do již tak vytížené oblasti, fronty, které najednou uvolňují všechny nevyřízené položky, a zásady automatického škálování, které reagují na příznaky, nikoli na příčinu. Služba proto může selhat, i když její servery fyzicky neselhaly. Důležitou otázkou není jen „Může poskytovatel přidat kapacitu?“, ale také „Přidávají naši klienti a automatizace další práci do selhávající cesty?“.
Cloudové platformy stále závisí na fyzických datových centrech, napájecích systémech, chlazení, optických propojeních, routerech, úložných zařízeních a regionálních síťových cestách. Redundance snižuje riziko, ale neznamená, že je každé selhání neviditelné. Sdílené zařízení, zóna dostupnosti, meziregionální propojení nebo hranice směrování mohou ovlivnit mnoho služeb najednou.
Regionální obnova může být také nerovnoměrná. Ve svém záznamu o incidentu z 12. června 2025 společnost Google Cloud uvedla, že u více produktů došlo k problémům s API souvisejícím se základní závislostí, přičemž obnova se liší podle lokality; záznam konkrétně uvádí pomalejší obnovu v us-central1 a v USA a více regionech. Záznam o incidentu Google Cloud Service Health ukazuje, proč kontrola jednoho regionu nebo jednoho produktu nestačí k pochopení celého rozsahu.
Platforma může být v pořádku, dokud neobdrží neočekávaný vstup: soubor, který je větší než limit analyzátoru, duplicitní záznam, neobvyklou odpověď API nebo migraci dat, která odhalí předpoklad ve starším kódu. Tato selhání jsou obzvláště nebezpečná, když je stejná verze nebo konfigurace distribuována globálně.
Pevné limity nejsou z běžného testování vždy zřejmé. Konfigurační soubor může být platný, ale příliš velký pro následnou komponentu. Míra požadavků může být v jedné oblasti přijatelná, ale po failoveru překročit kvótu. Úloha obnovy může být jednou bezpečná, ale při opakovaném provádění může vytvářet duplicitní práci. Testování by mělo zahrnovat chybná data, částečné selhání závislostí, regionální evakuaci a opakované spuštění – nejen šťastnou cestu.
Distribuované útoky typu denial-of-service, odcizení přihlašovacích údajů, zneužití a škodlivé změny konfigurace mohou způsobit výpadky. Nárůst provozu nebo selhání ověřování však nejsou důkazem útoku. Považání každého incidentu za bezpečnostní událost může poslat odpověď špatným směrem a zpozdit vrácení konfigurace zpět.
Používejte důkazy: porovnávejte vzory požadavků, protokoly ověřování, záznamy o změnách, aktualizace stavu poskytovatelů a nezávislé sondy. Udržujte eskalaci zabezpečení k dispozici, ale oddělujte „to, co víme“, od „toho, co máme podezření“. Zpráva Cloudflare z roku 2025 je konkrétní připomínkou toho, že výpadek může zpočátku vypadat jako útok a přesto mít jinou příčinu.
Výpadek je obtížnější zastavit, když monitorovací systém závisí na stejné cestě selhání jako aplikace. Dashboard může ukazovat, že virtuální stroj běží, zatímco zákazníci nemohou dokončit transakci. Pokyny služby Google Cloud k SLO zaměřeným na zákazníka a vlastním metrikám vysvětlují tento rozdíl: dostupnost infrastruktury není totéž co úspěšná akce zákazníka.
Použijte alespoň jednu nezávislou syntetickou kontrolu – plánovaný test, který provádí bezpečnou transakci podobnou transakci zákazníka – z vnějšku postiženého prostředí. Zachovejte druhý způsob, jak se dostat k aktualizacím incidentů, a zaznamenávejte stránky se stavem poskytovatele, interní upozornění a zprávy od zákazníků v jedné časové ose. Nepředpokládejte, že stránka se stavem je neomylná: Cloudflare oznámil, že jeho vlastní stránka se stavem nebyla během incidentu v listopadu 2025 dostupná, ačkoli byla hostována mimo infrastrukturu Cloudflare.
Začněte s jednoduchou mapou závislostí. Zahrňte DNS, identitu, tajné klíče, certifikáty, fronty, databáze, úložiště objektů, API třetích stran, doručování obsahu, monitorování a oblast poskytovatele. Označte, které komponenty jsou vyžadovány pro každý požadavek a které lze degradovat nebo obejít. Toto cvičení často odhalí, že dvě „nezávislé“ oblasti stále sdílejí identitu, DNS, nástroje pro nasazení nebo jednoho externího dodavatele.
Definujte si RTO (recovery time objective, cílovou dobu pro obnovení služby) a RPO (recovery point objective, přijatelné množství ztráty dat měřené v čase). Poté vyberte ovládací prvky, které odpovídají obchodním potřebám. Malý interní řídicí panel může akceptovat ruční obnovení. Platební nebo nouzový pracovní postup může vyžadovat službu pro více regionů, otestovanou replikaci dat a zdokumentovaného vlastníka pro failover.
| První vodítko | Pravděpodobná příčina | Příprava nebo kontrola |
|---|---|---|
| Chyby se začínají objevovat ihned po nasazení nebo změně zásad. | Změna konfigurace nebo softwaru | Vydání, schválení, správa verzí a rychlé vrácení zpět v systému Canary |
| Několik produktů nedokáže ověřovat nebo přeložit jména. | Sdílená identita, autorizace nebo závislost na DNS | Mapování závislostí a nezávislá přístupová cesta |
| Latence se zvyšuje s rostoucím počtem opakovaných pokusů | Přetížení nebo bouře s opakovaným pokusem | Zpomalení, jitter, jističe a odlehčení zátěže |
| Jeden region se zotavuje, zatímco jiný zůstává oslabený | Regionální rozdíl v kapacitě nebo závislosti | Testované víceregionální failovery a regionální runbooky |
| Infrastruktura vypadá dobře, ale transakce selhávají | Mezera v pozorovatelnosti nebo závislost na následných produktech | SLO na úrovni zákazníka a kontroly syntetických transakcí |
Hlavními příčinami rozsáhlých výpadků cloudu jsou interagující systémy: nebezpečné změny, sdílené závislosti, přetížení a opakované pokusy, selhání regionální infrastruktury, softwarové a datové vady, bezpečnostní nebo dopravní události a slepá místa v detekci. Nemůžete eliminovat každý výpadek poskytovatele, ale můžete omezit jeho dosah. Mapujte závislosti, měřte výsledky zákazníků, zajistěte zdvořilé opakované pokusy, udržujte změny vratné, testujte převzetí služeb při selhání a udržujte záznam o incidentech, který rozlišuje fakta od hypotéz.
Poznámka ke zdroji: Tento článek byl zkontrolován 16. září 2026. Incidenty u poskytovatelů jsou zdokumentované příklady, nikoli vyčerpávající seznam, a analýzy poskytovatelů nemusí odhalovat všechny interní detaily. Názvy produktů, architektury, stavové stránky a chování při obnově se mohou v průběhu času měnit.
Srovnání Xbox Series X a PS5 pro české hráče: výkon, hry, ovladače, disky, úložiště i to, co zkontrolovat před nákupem.
Xbox Series X s Game Passem může nabídnout široký výběr her, ale předplatné navyšuje celkové náklady. Přehled českých cen, tarifů a toho, komu se konzole vyplatí.
Starlink v Česku nabízí domácí internet od 521,50 Kč měsíčně v rámci časově omezené akce. Ověřte dostupnost adresy, tarify, rychlosti i podmínky Roam.
Twitch rozšířil vybrané nástroje monetizace a představil nové interaktivní funkce. Co to prakticky znamená pro české streamery a jejich příjmy?
Starlink připojuje domácnosti přes družice na nízké oběžné dráze. Zjistěte, jak funguje, kolik stojí české tarify a kdy dává smysl oproti pevné síti.
Starlink může vyřešit pomalé připojení mimo dosah kabelových sítí. Přehled českých cen, možných nákladů na instalaci, výhledu na oblohu a limitů služby.
Twitch spustil k vydání GTA VI odměny za sledování, nové komunitní prvky i denní soutěž o kódy hry. Co to znamená pro české diváky a streamery?
GTA 6 vychází 19. listopadu na PS5 a Xbox Series X|S. Rockstar potvrdil cíl 30 FPS, předběžné stažení i rozdíly PS5 Pro. Zjistěte, co připravit.
Twitch mezi lednem a zářím 2026 zaznamenal přes 8,6 miliardy hodin sledování her. Jak herní hity, živé reakce a chat mění sledovanost i komunitu?
GTA 6 vychází 19. listopadu 2026 na PS5 a Xbox Series X|S. Rockstar potvrdil cíl 30 FPS, až 212 GB místa i půlnoční vydání v Česku.