Hem
» Nyheter
»
Vilka är de främsta orsakerna bakom omfattande driftstopp på molnplattformar?
Vilka är de främsta orsakerna bakom omfattande driftstopp på molnplattformar?
Det korta svaret: utbredd driftstopp för molnplattformar beror vanligtvis på en kedja av fel, inte en isolerad trasig server. En riskabel konfigurations- eller programvaruändring kan påverka ett delat beroende, såsom identitet, DNS, auktorisering eller ett kontrollplans-API. Det första felet utlöser sedan återförsök, trafikförskjutningar eller automatiserad skalning, vilket ökar belastningen och sprider effekten över regioner eller produkter. Svag observerbarhet och en oprövad återställningsväg kan göra att avbrottet varar längre.
Det mönstret är viktigt eftersom det förändrar vad du bör förbereda dig för. ”Molnet” är inte en enda maskin och ”leverantören är nere” är inte en fullständig diagnos. Din applikation kan vara beroende av flera leverantörstjänster, din egen konfiguration, externa API:er och en återställningsprocess som bara fungerar om den har testats. Den här guiden förklarar de viktigaste orsakerna, vad en nybörjare bör kontrollera först och de misstag som gör ett brett avbrott svårare att hantera.
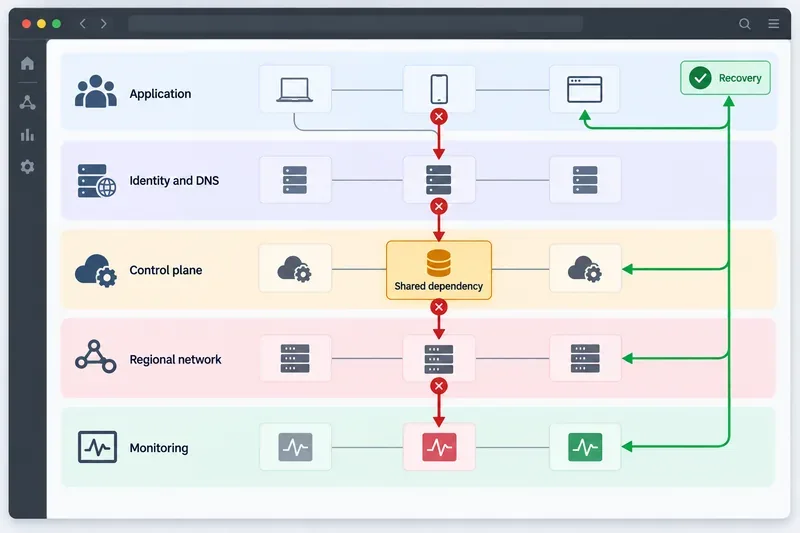
Konceptuell vy över hur ett fel i ett delat molnberoende kan kaskadföras genom identitets-, kontrollplans-, regionala och övervakningslager innan återställningen återställs.
Först, förstå vad "utbredd driftstopp" betyder
Tillgänglighet avser huruvida en tjänst framgångsrikt kan svara på en begäran. Prestandaförsämring innebär att den svarar, men för långsamt eller med förhöjda felfrekvenser. En omfattande incident kan påverka dataplanet – de system som hanterar applikationstrafik – eller kontrollplanet – de API:er och interna system som används för att skapa, konfigurera, autentisera och hantera resurser. Ett avbrott i kontrollplanet kan förhindra distributioner eller skalning även om redan körda arbetsbelastningar fortsätter att hantera en del trafik.
Ett delat beroende är en tjänst som många produkter eller sökvägar för förfrågningar är beroende av. DNS, identitets- och åtkomsthantering, certifikatvalidering, routning, metadata, kvoter och observerbarhet är vanliga exempel. Om beroendet är centraliserat eller har ett gemensamt felläge kan en liten defekt ha en mycket större explosionsradie – den uppsättning kunder, regioner eller tjänster som påverkas av ett fel.
De främsta orsakerna bakom omfattande avbrott i molnplattformar
1. En felaktig ändrings-, konfigurations- eller automatiseringsregel
Ändringar är en ledande källa till stora incidenter eftersom de kan vara korrekta i ett sammanhang och osäkra på plattformsnivå. En behörighetsredigering, routningsregel, funktionsflagga, schemaändring eller automatiserad kapacitetsåtgärd kan påverka varje region eller varje kundvänd maskin. Automatisering kan förstärka resultatet innan en människa ser det.
Cloudflares officiella rapport från den 18 november 2025 illustrerar denna typ av fel. En ändring av databasbehörigheter orsakade dubbletter av rader i en Bot Management-funktionsfil. Filen blev ungefär dubbelt så stor, spreds till maskiner över hela världen och överskred en gräns i routingprogramvaran. Cloudflare säger att incidenten inte orsakades av en cyberattack; felet kom från en konfigurations- och programvaruinteraktion. Företaget stoppade spridningen och driftsatte en fungerande fil. Läs Cloudflares rapport om avbrottet från den 18 november 2025 för leverantörens detaljerade redogörelse.
2. Fel på ett delat kontrollplan eller en grundläggande tjänst
Grundläggande tjänster ligger ofta under många till synes orelaterade produkter. Identitet, auktorisering, intern DNS, övervakning, metadata och API:er som används för att tillhandahålla resurser kan bli en vanlig felpunkt. De kundvända symptomen kan se olika ut – inloggningsfel, distributionsfel, timeouts eller saknade mätvärden – men det underliggande beroendet kan vara detsamma.
I sin sammanfattning av US-EAST-1 efter händelsen den 7 december 2021 beskrev AWS en oväntad interaktion som involverade automatiserad skalningsaktivitet och interna nätverksenheter. AWS uppgav att det berörda nätverket var värd för grundläggande tjänster, inklusive övervakning, intern DNS, auktoriseringstjänster och delar av EC2-kontrollplanet. Anslutningsförsök och återförsök bidrog sedan till överbelastning. AWS rapporterade också att deras supportkontaktcenter och delar av deras kommunikationsväg för tjänstens hälsa påverkades. AWS sammanfattning av händelsen är ett användbart exempel på varför en leverantör kan ha svårt att både återställa tjänster och diagnostisera dem samtidigt.
3. Överbelastning, återförsöksstormar och kaskadfel
När en begäran misslyckas försöker klienter ofta igen. En återförsöksstorm uppstår när många klienter försöker igen samtidigt, särskilt utan exponentiell backoff – en strategi som ökar väntetiden mellan försök – och jitter, vilket ger en liten slumpmässig fördröjning. Dessa återförsök förbrukar samma begränsade kapacitet och kan förvandla ett partiellt fel till ett större avbrott.
Andra belastningsmultiplikatorer inkluderar hälsokontroller som körs för ofta, automatisk redundansväxling som skickar trafik till en redan upptagen region, köer som frigör en eftersläpning på en gång och autoskalningspolicyer som reagerar på symptom snarare än orsak. En tjänst kan därför misslyckas även om dess servrar inte fysiskt har gått sönder. Den viktiga frågan är inte bara "Kan leverantören lägga till kapacitet?" utan också "Lägger våra klienter och automatisering till mer arbete på den felande vägen?"
4. Regionala infrastruktur-, nätverks-, ström- eller hårdvaruproblem
Molnplattformar är fortfarande beroende av fysiska datacenter, kraftsystem, kylning, fiberlänkar, routrar, lagringsenheter och regionala nätverksvägar. Redundans minskar risken, men det gör inte alla fel osynliga. En delad anläggning, tillgänglighetszon, länk mellan regioner eller routningsgräns kan påverka många tjänster samtidigt.
Regional återhämtning kan också vara ojämn. I sin incidentrapport den 12 juni 2025 rapporterade Google Cloud att flera produkter upplevde API-problem relaterade till ett underliggande beroende, med återställning som varierade beroende på plats; rapporten noterade specifikt långsammare återställning i us-central1 och i amerikanska och multiregionala tjänster. Google Cloud Service Health-incidentrapporten visar varför det inte räcker med att kontrollera en region eller en produkt för att förstå hela omfattningen.
5. Programvarufel, dataformsfel och hårda gränser
En plattform kan vara felfri tills den får oväntade indata: en fil som är större än en parsergräns, en dubblettpost, ett ovanligt API-svar eller en datamigrering som exponerar ett antagande i äldre kod. Dessa fel är särskilt farliga när samma version eller konfiguration distribueras globalt.
Hårda gränser är inte alltid uppenbara vid normal testning. En konfigurationsfil kan vara giltig, men för stor för en nedströmskomponent. En förfrågningsfrekvens kan vara acceptabel i en region, men överstiga en kvot efter redundansväxling. Ett återställningsjobb kan vara säkert en gång, men skapa dubbelarbete när det upprepas. Testning bör omfatta dåliga data, partiella beroendefel, regional evakuering och upprepad körning – inte bara den lyckliga vägen.
6. Säkerhetshändelser, trafikavvikelser och felaktiga tidiga antaganden
Distribuerade överbelastningsattacker, stulna autentiseringsuppgifter, missbruk och skadliga konfigurationsändringar kan orsaka avbrott. Men en trafiktopp eller ett autentiseringsfel är inte ett bevis på en attack. Att behandla varje incident som en säkerhetshändelse kan skicka svaret i fel riktning och försena en konfigurationsåterställning.
Använd bevis: jämför förfrågningsmönster, autentiseringsloggar, ändringsregister, uppdateringar av leverantörsstatus och oberoende undersökningar. Håll säkerhetseskalering tillgänglig, men separera "vad vi vet" från "vad vi misstänker". Cloudflares obduktion från 2025 är en konkret påminnelse om att ett avbrott initialt kan se ut som en attack och ändå ha en annan grundorsak.
7. Blindpunkter i övervakning och statuskommunikation
Ett avbrott blir svårare att begränsa när övervakningssystemet är beroende av samma felsökande sökväg som applikationen. En instrumentpanel kan visa att en virtuell maskin körs medan kunder inte kan slutföra en transaktion. Google Clouds vägledning om kundfokuserade SLO:er och anpassade mätvärden förklarar denna skillnad: infrastrukturens drifttid är inte detsamma som en lyckad kundåtgärd.
Använd minst en oberoende syntetisk kontroll – ett schemalagt test som utför en säker kundliknande transaktion – utanför den berörda miljön. Ha ett andra sätt att nå incidentuppdateringar och registrera leverantörers statussidor, interna varningar och kundrapporter i en tidslinje. Anta inte att en statussida är ofelbar: Cloudflare rapporterade att deras egen statussida inte heller var tillgänglig under incidenten i november 2025, trots att den låg utanför Cloudflares infrastruktur.
En nybörjares förberedelse- och svarsväg
Före ett avbrott: kartlägg vad din tjänst verkligen är beroende av
Börja med en enkel beroendekarta. Inkludera DNS, identitet, hemligheter, certifikat, köer, databaser, objektlagring, tredjeparts-API:er, innehållsleverans, övervakning och leverantörsregionen. Markera vilka komponenter som krävs för varje begäran och vilka som kan försämras eller kringgås. Denna övning visar ofta att två "oberoende" regioner fortfarande delar identitet, DNS, distributionsverktyg eller en enda extern leverantör.
Definiera din RTO (recovery time objective, target time to restore service) och RPO (recovery point objective, den acceptabla mängden dataförlust mätt i tid). Välj sedan kontroller som matchar affärsbehovet. En liten intern instrumentpanel kan acceptera manuell återställning. Ett betalnings- eller nödarbetsflöde kan behöva tjänster i flera regioner, testad datareplikering och en dokumenterad redundansägare.
Under ett avbrott: bekräfta omfattningen innan du ändrar saker
Kontrollera om symptomet är ett programfel, en leverantörsincident, ett regionalt problem eller ett beroendefel. Jämför flera regioner, konton, nätverk och kundsökvägar där det är säkert.
Frys orelaterade distributioner och konfigurationsändringar. Bevara tidsstämplar, förfrågnings-ID:n, felexempel, senaste ändringar och det första kundens synliga symptomet.
Kontrollera leverantörens officiella servicehälsosida och incidentregister, men förlita dig inte på en enda signal. Jämför den med oberoende sonderingar och dina egna loggar.
Minska belastningen på ett säkert sätt. Använd begränsade återförsök med exponentiell backoff och jitter, kretsbrytare som stoppar anrop till ett felaktigt beroende och kökontroller som förhindrar en plötslig replaystorm.
Redundansöverflyttning endast när destinationen är klar och proceduren har testats. Verifiera autentiseringsuppgifter, DNS TTL-beteende, datakonsistens, idempotens och nedströmskapacitet innan du dirigerar mer trafik.
Kommunicera vad som är bekräftat, vad som undersöks, vad kunderna bör göra och när nästa uppdatering kommer. Undvik att lova en återhämtningstid som bevisen inte stöder.
Snabbreferens: ledtråd, trolig orsak och användbar kontroll
Tidig ledtråd
Trolig orsak
Förberedelse eller kontroll
Felen börjar omedelbart efter en distribution eller policyändring
Konfigurations- eller programändring
Canary-utgåvor, godkännanden, versionshantering och snabb återställning
Flera produkter misslyckas med att autentisera eller tolka namn
Delad identitet, auktorisering eller DNS-beroende
Beroendemappning och en oberoende åtkomstväg
Latensen ökar när antalet återförsök ökar
Överbelasta eller försök igen med storm
Bakström, jitter, brytare och lastavkoppling
En region återhämtar sig medan en annan förblir försämrad
Regional kapacitet eller beroendeskillnad
Testade redundansväxlingar för flera regioner och regionala runbooks
Infrastrukturen ser sund ut men transaktioner misslyckas
Observerbarhetsgap eller nedströmsberoende
SLO:er på kundnivå och kontroller av syntetiska transaktioner
Misstag som förvärrar utbredda driftstopp
Om du antar att tjänsten hanteras av en leverantör behöver din applikation ingen återhämtningsförmåga.
Mäter endast instansens drifttid istället för inloggning, utcheckning, sökning eller andra kritiska kundresor.
Använda oändliga återförsök eller starta om allt på en gång.
Redundansöverföring till en destination som inte har testats under verklig belastning.
Görde flera nödändringar utan att registrera vilken som hjälpte.
Hålla övervakning, driftsättning och incidentkommunikation på samma beroendeväg.
Att kalla en incident för en cyberattack innan bevisen stöder den slutsatsen.
Slutsats
De främsta orsakerna till utbredda molnavbrott är interagerande system: osäkra ändringar, delade beroenden, överbelastning och återförsök, regionala infrastrukturfel, programvaru- och dataformsfel, säkerhets- eller trafikhändelser och blinda fläckar i detektering. Du kan inte eliminera alla leverantörsavbrott, men du kan begränsa dess explosionsradie. Kartlägg beroenden, mät kundresultat, gör återförsök artiga, håll ändringar reversibla, testa redundans och upprätthåll en incidentjournal som skiljer fakta från hypoteser.
Källnotering: Denna artikel granskades den 16 september 2026. Leverantörsincidenterna är dokumenterade exempel, inte en uttömmande lista, och leverantörernas obduktioner kanske inte avslöjar alla interna detaljer. Produktnamn, arkitekturer, statussidor och återställningsbeteende kan ändras över tid.