Domov
» Správy
»
Výpadok Salesforce v roku 2025: Praktická retrospektíva závažných narušení
Výpadok Salesforce v roku 2025: Praktická retrospektíva závažných narušení
Výpadky Salesforce v roku 2025 sa nevyvíjali podľa jedného jednoduchého vzorca. Niektoré incidenty sa obmedzovali na konkrétne inštancie alebo produkty, zatiaľ čo iné prechádzali cez viacero cloudov alebo záviseli od infraštruktúry tretích strán. Pre tímy prevádzky, IT, CRM, obchodu a marketingu nie je užitočnou retrospektívou zoznam všetkých príspevkov o dôvere publikovaných v danom roku. Je to prehľad narušení, ktoré odhaľujú opakujúce sa režimy zlyhania: závislosti od autentifikácie, infraštruktúra dátového centra, obnova databázy, siete na doručovanie obsahu, DNS poskytovateľa cloudu a zmeny, ktoré je potrebné vrátiť späť.
Táto referencia sa zameriava na vybraný súbor významných incidentov z roku 2025, ktoré zdokumentovala spoločnosť Salesforce Trust. „Závažný“ tu znamená prevádzkovo významný incident z dôvodu trvania, rozsahu alebo typu ovplyvneného pracovného postupu zákazníka; neznamená to, že bol ovplyvnený každý zákazník a nejde o kompletný zoznam incidentov. Presný dopad závisel od produktu, inštancie, regiónu a nájomníka.
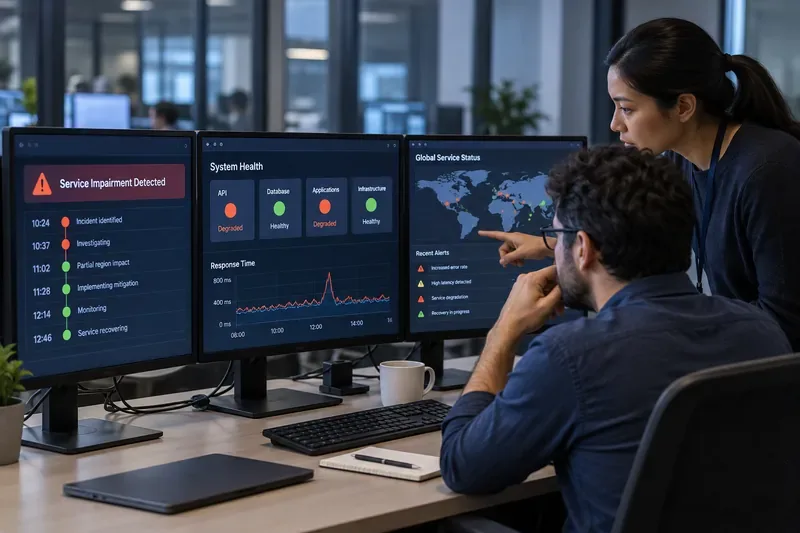
Prevádzkový tím kontroluje stav služieb a časové harmonogramy incidentov, čím ilustruje druh monitorovania naprieč systémami, ktoré je potrebné, keď narušenie cloudovej platformy ovplyvní obchodné pracovné postupy.
Časový harmonogram výpadkov Salesforce v roku 2025: vybrané incidenty, ktoré stoja za štúdium
Dátum
Čo uviedla spoločnosť Salesforce
Hlásené trvanie alebo okno zotavenia
Prečo je to z prevádzkového hľadiska dôležité
7. februára
Prerušenie služieb pre podskupinu zákazníkov, pričom Salesforce uviedol obmedzenia zdrojov spojené s vysokým využitím sieťovej prevádzky.
2 hodiny 20 minút
Kapacita a tlak na dopravu môžu spôsobiť zníženie výkonu až do úplnej nedostupnosti.
13. – 14. februára
Prerušenie služby spojené s problémom u dodávateľa tretej strany; Spoločnosť Salesforce uviedla, že dodávateľ zistil poškodenie fyzickej sieťovej infraštruktúry, zatiaľ čo spoločnosť Salesforce pracovala na prepnutí na záložný systém.
1 hodina 45 minút
Externá konektivita sa môže stať súčasťou efektívnej hranice dostupnosti Salesforce.
10. – 11. júna
Udalosť vo viacerých cloudoch ovplyvnila autentifikáciu a služby naprieč produktmi vrátane Heroku, Commerce, Marketing Cloud a ďalších služieb Salesforce.
Jeden incident v Truste trval 22 hodín a 43 minút
Závislosti identity a zdieľanej platformy môžu mať široký vplyv na podnikanie, aj keď jednotlivé aplikácie zostávajú v poriadku.
18. – 19. júna
Porucha chladiaceho systému v dátovom centre v Indianapolise spôsobila narušenie siete; spoločnosť Salesforce uviedla, že väčšina serverov vo viac postihnutých zásobníkoch bola odpojená od siete ešte pred postupnou obnovou.
Fáza prerušenia prevádzky bola hlásená ako 18 hodín a 44 minút v súvislosti s uvedeným incidentom.
Fyzické zariadenia, napájanie, siete, virtuálna infraštruktúra, databázy a obnova aplikácií môžu tvoriť dlhý reťazec závislostí.
2. – 6. októbra
Zákazníci služby Marketing Cloud s databázou DB10016 stratili službu, pretože databáza nebola k dispozícii; Salesforce vykonal obnovenie a overenie databázy.
Fáza prerušenia služby hlásená ako 3 dni 16 hodín pred prechodom na zníženie výkonu
Obnova databázy môže byť oveľa pomalšia ako reštart aplikácie, takže plány kontinuity potrebujú dlhodobý režim.
20. októbra
Viaceré cloudy Salesforce boli ovplyvnené problémom s DNS u dodávateľa cloudovej infraštruktúry tretej strany. Súvisiaci vplyv hlásili služby Commerce Cloud, MuleSoft, Marketing Cloud Account Engagement, Heroku a ďalšie.
Líšilo sa podľa služby; uvedené prerušenie obchodu trvalo 3 hodiny 19 minút, zatiaľ čo incident MuleSoft zostal otvorený 16 hodín 23 minút.
Závislosť na úrovni jedného poskytovateľa môže v rôznych produktoch spôsobiť rôzne príznaky a časy obnovy.
18. novembra
Podmnožina obchodov Commerce Cloud zaznamenala občasné chyby HTTP 500. Spoločnosť Salesforce uviedla, že jej platforma a sieť fungujú normálne a prerušenie pripísala aktualizácii konfigurácie poskytovateľa CDN tretej strany, ktorá bola vrátená späť.
4 hodiny 40 minút
Dostupnosť pre zákazníkov môže zlyhať na hranici doručovania, aj keď je základná aplikačná platforma v poriadku.
1. Výraz „Salesforce nefunguje“ je zvyčajne príliš všeobecný na to, aby sa dal podľa neho konať.
Spoločnosť Salesforce Trust hlási incidenty podľa produktu, inštancie, služby a niekedy aj podľa databázy alebo regionálnej súčasti. Prerušenie zo 7. februára ovplyvnilo podmnožinu zákazníkov. Incident služby Marketing Cloud z 2. októbra sa sústredil na jednu databázu. Udalosť z 20. októbra sa týkala viacerých cloudov, ale spôsobila rôzne časy obnovy a príznaky. Pre respondentov preto prvou užitočnou otázkou nie je len to, či je Salesforce nefunkčný, ale ktorý nájomník, produkt, región, inštancia a závislosť zlyháva.
2. Infraštruktúra tretích strán sa stala súčasťou výpadku
Niekoľko incidentov z roku 2025 ukazuje, prečo sa plánovanie kontinuity SaaS nemôže zastaviť na hraniciach dodávateľov SaaS. Incident z 13. – 14. februára sa týkal sieťového dodávateľa tretej strany. Prerušenie viacerých cloudov z 20. októbra súviselo s problémom DNS u dodávateľa cloudovej infraštruktúry tretej strany. 18. novembra spoločnosť Salesforce nahlásila problémy s pripojením k obchodu Commerce Cloud súvisiace s aktualizáciou konfigurácie poskytovateľa CDN tretej strany.
Poučenie nespočíva v tom, že tretie strany sú vo svojej podstate nespoľahlivé. Ide o to, že pracovné postupy zákazníkov závisia od reťazca služieb: identita, DNS, siete, doručovanie obsahu, cloudová infraštruktúra, API a aplikačné služby. Váš model incidentov by mal nasledovať tento reťazec.
3. Zotavenie je často postupné, nie okamžité
Podujatie v dátovom centre z 18. – 19. júna je toho silným príkladom. Spoločnosť Salesforce opísala obnovu fyzických a virtuálnych zdrojov, následné spustenie databáz a replík online, overenie parametrov údajov a obnovu závislých služieb. Narušenie databázy Marketing Cloud v októbri podobne prešlo obnovou, kontrolami konfigurácie, overením a neskôr fázou zníženia výkonu.
Toto rozlíšenie je dôležité pre obchodné tímy. „Platforma sa zotavuje“ nemusí nevyhnutne znamenať, že každý front je vyčerpaný, každá integrácia bola zopakovaná, každý obchod je stabilný alebo každá naplánovaná úloha bola úspešne spustená.
Praktický kontrolný zoznam pre reakciu na incidenty pri výpadkoch Salesforce
Identifikujte presný okruh výbuchu. Zaznamenajte postihnuté organizácie, názvy mojich domén, produkty, obchodné jednotky, regióny, inštancie a integrácie.
Pred zmenou produkcie skontrolujte dôveryhodnosť Salesforce. Porovnajte svoje príznaky s oficiálnym záznamom o incidente, aby ste počas udalosti na strane dodávateľa nevykonávali zbytočné zmeny konfigurácie.
Samostatné zlyhania prihlásenia, API, dát a front-endu. Zlyhanie overenia, pomalé stránky, oneskorené asynchrónne úlohy, nedostupnosť databázy a chyby CDN vyžadujú rôzne riešenia.
Chráňte integritu údajov. Vyhnite sa slepým opakovaným pokusom, ktoré môžu viesť k duplicitným prípadom, potenciálnym zákazníkom, objednávkam, platbám alebo odchádzajúcim správam. Používajte ovládacie prvky idempotencie tam, kde ich integrácie podporujú.
Zaraďte kritickú prácu do frontu mimo zlyhávajúcej závislosti. Zachyťte urgentné požiadavky na predaj, podporu, vybavenie alebo servis v kontrolovanom záložnom kanáli s časovými pečiatkami a vlastníctvom.
Sledujte obnovu podľa pracovného postupu, nielen podľa farby stavu. Testujte prihlásenie, operácie čítania/zápisu, volania API, naplánované úlohy, prichádzajúce správy, odchádzajúce oznámenia a cesty zákazníkov s vysokou hodnotou.
Zosúladenie po obnovení. Skontrolujte neúspešné úlohy, fronty opakovaných pokusov, čiastočné transakcie, zmeškané automatizácie, duplicitné odoslania a medzery v hláseniach.
Uschovajte si záznam o incidentoch. Zaznamenajte si prvý príznak, oficiálne ID incidentu, dopad na podnikanie, kroky na zmiernenie následkov, kontrolné body obnovy a opatrenia po incidente.
Ako interpretovať incident dôveryhodnosti v Salesforce bez prehnanej reakcie
Užitočná kontrola dôveryhodnosti má tri fázy. Po prvé, prečítajte si dotknuté služby a inštancie. Po druhé, porovnajte zverejnený čas začiatku s vašou telemetriou; Salesforce niekedy upravuje časy začiatku incidentov, keď sa vyšetrovanie zlepšuje. Po tretie, rozlišujte medzi prerušením služby a zhoršením výkonu alebo prerušením funkcií. Tieto označenia opisujú rôzne prevádzkové stavy a incident na úrovni funkcie môže spôsobiť, že väčšina platformy bude použiteľná.
Nepredpokladajte, že trvanie incidentu sa rovná obdobiu, počas ktorého každý postihnutý zákazník pociťoval rovnaké príznaky. Aktualizácie Salesforce často opisujú rozširovanie alebo zmenšovanie polomeru dopadu, postupnú obnovu alebo obnovu špecifickú pre daný produkt. Pre interné hlásenie si zaznamenajte oficiálny časový harmonogram dodávateľa aj vaše vlastné pozorované okno dopadu.
Poučenie z plánovania kontinuity z najdlhších udalostí v roku 2025
Najsilnejším ponaučením z roku 2025 o odolnosti je, že plán výpadku by mal mať viac ako 30-minútový režim. Krátkodobé prerušenie môže vyžadovať iba komunikáciu a trpezlivosť. Viachodinová udalosť si vyžaduje prácu v rade a kontrolované manuálne procesy. Prerušenie trvajúce niekoľko dní, ako napríklad spomínaný incident s databázou Marketing Cloud, si vyžaduje odovzdávanie personálnych záležitostí, správu nevybavených zákaziek, komunikáciu so zákazníkmi a plán obnovy pre odložené kampane, importy, exporty, operácie API a reportovanie.
Definujte priority obnovy pred výpadkom. Pre obchodnú organizáciu môže byť príjem potenciálnych zákazníkov a záväzky voči nim pred aktualizáciou analytických údajov. Pre maloobchodníka môže byť kritickou cestou zachytávanie objednávok, presnosť zásob a prehľad o zákazníckom servise. Pre marketingový tím môže byť prioritou predchádzanie duplicitným odoslaniam a zachovanie stavu kampane, a nie snaha presadiť každú naplánovanú aktivitu cez nestabilný systém.
Čo by mali tímy zmeniť po zhodnotení roku 2025?
Retrospektívu použite na testovanie predpokladov, nie na predpovedanie ďalšieho zlyhania. Incidenty z roku 2025 ukazujú, že počiatočný problém môže pochádzať z tlaku na prevádzku, siete dodávateľov, fyzického chladenia, databáz, DNS, konfigurácie CDN alebo zmien softvéru. Žiadne jednotné riešenie nepokrýva všetky tieto faktory.
Rozvinutý plán kontinuity prevádzky Salesforce by preto mal mapovať obchodné procesy na technické závislosti, priradiť vlastníkov záložných procesov, definovať bezpečné správanie pri opakovanom pokuse, udržiavať monitorovanie dôveryhodnosti Salesforce blízko pracovného postupu incidentov a zahŕňať formálnu fázu zosúladenia po obnovení služby. Najužitočnejšou metrikou nie je len „čas, kým Salesforce nestane zeleným“. Je to čas, kým sa obchodný proces overí od začiatku do konca a nevybavené záležitosti sa bezpečne vyriešia.
Referenčná poznámka a obmedzenia
Táto retrospektíva bola pripravená na základe vlastných záznamov spoločnosti Salesforce o dôvere a pomoci a zameriava sa na vybrané incidenty z kalendárneho roka 2025. Spoločnosť Salesforce počas roka publikovala mnoho ďalších oznámení o incidentoch vrátane kratších a užšie vymedzených udalostí. Niektoré stránky o dôvere boli aktualizované po prvej udalosti, keďže boli objasnené okná dopadu a dotknuté komponenty. Pre aktuálny stav služby použite stav dôveryhodnosti spoločnosti Salesforce , a nie sa spoliehajte na historický článok.