Domov
» Správy
»
Salesforce Outage 2025: A Retrospective on Major Disruptions
Salesforce Outage 2025: A Retrospective on Major Disruptions
Bottom line: Salesforce did not have one single “2025 outage.” It had a series of materially different disruptions: a Commerce Cloud release problem, short core-service degradation, authentication failures that crossed cloud boundaries, a data-center cooling failure, a prolonged Email Services incident, and a later DNS-related cross-cloud disruption. The practical lesson is that availability must be evaluated at the level of the affected instance, stack, service, integration, and workflow—not only by asking whether “Salesforce” is up.
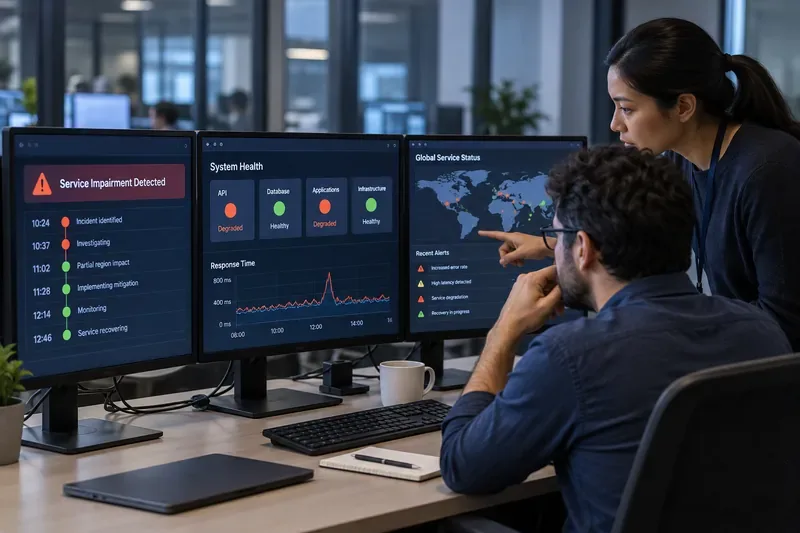
A conceptual service-health dashboard shows how an enterprise team can track component degradation, investigation, mitigation, and restoration; it is not an archived Salesforce screenshot or evidence from a specific incident.
How this retrospective defines a major Salesforce disruption
Salesforce’s Trust site is the primary reference point for service availability and maintenance communications. Its incident records distinguish between a performance degradation, where users may still reach the service but some functions are slow or unreliable, and a service disruption, where end users may be unable to access the service. That distinction matters because a CRM can appear to be online while login, email processing, search, APIs, or background jobs are failing.
This review focuses on 2025 incidents that had one or more of the following characteristics: multi-cloud impact, a long or operationally significant recovery window, an infrastructure or change-management root cause, or a published root-cause analysis. It is not a complete count of every localized performance event recorded during the year. Times below are in UTC unless stated otherwise, and duration labels follow Salesforce’s incident records where available.
2025 incident timeline at a glance
Date
Primary area
What customers saw
Documented cause or status
January 14
Commerce Cloud / B2C Core
Order Search API performance issues affecting job activity, storefront activity, and order processing; 12 hours 45 minutes in the incident record.
A recent release was identified as the potential trigger; Salesforce later applied a fix.
March 11
Core Service
A brief performance degradation lasting about 20 minutes, with possible slow responses, timeouts, or intermittent connectivity.
The public incident record confirms recovery but does not establish a detailed root cause in the material reviewed here.
June 10–11
Authentication across multiple clouds, including Heroku
Some customers experienced multi-factor authentication failures and difficulty logging in to Salesforce-related services; the incident record spans 22 hours 43 minutes.
Preskúmanie nápravných opatrení spoločnosťou Heroku identifikovalo ako hlavnú príčinu výpadku Heroku neúmyselnú aktualizáciu systému, ktorú nainštaloval dodávateľ v produkčnej infraštruktúre.
18. – 19. júna
Zapojenie do marketingového cloudu, najmä stacky 1 a 6
Problémy s prístupom, zlyhania prihlásenia a postupné obnovenie ovplyvňujúce aplikácie, spracovanie na pozadí, e-mail a mobilné služby.
Porucha chladiaceho systému v dátovom centre spoločnosti Salesforce v Indianapolise odstavila mnoho fyzických a virtuálnych serverov.
26. – 27. júna
E-mailové služby
Oneskorenia prichádzajúcich a odchádzajúcich e-mailov, rast frontu, pomalé úlohy Apex, vrátené e-maily, zlyhania doručenia a možné duplicitné záznamy typu e-mail-to-case.
Udalosť s vysokým objemom spúšťačov spotrebovala zdroje poštového servera a spôsobila búrku opakovaných pokusov; spoločnosť Salesforce vyhlásila incident za vyriešený 27. júna o 22:08 UTC.
20. októbra
Viaceré cloudy Salesforce
Rozsiahle narušenie ovplyvňujúce prístup a cloudové funkcie, pričom obnova prebieha postupne.
Spoločnosť Salesforce opísala problém s DNS u externého dodávateľa cloudovej infraštruktúry; incident sa zhodoval s rozsiahlo hlásenou udalosťou DNS AWS US-EAST-1.
Čo sa stalo pri tých hlavných incidentoch?
Január: problém s vydaním sa dostal do pracovných postupov Commerce Cloudu
14. januára začali zákazníci služby Commerce Cloud používajúci rozhrania API pre vyhľadávanie objednávok spoločnosti Commerce pociťovať znížený výkon. Záznam o incidente spoločnosti Salesforce uvádza ako dotknutú službu službu B2C Core, identifikuje začiatok približne o 01:30 UTC a zaznamenáva vyriešenie o 14:15 UTC. Dôsledok sa neobmedzoval len na pomalé načítavanie stránky: v závislosti od implementácie mohli zákazníci pozorovať zníženú aktivitu úloh, aktivitu v obchode a spracovanie objednávok.
V zázname sa uvádza, že nedávne vydanie bolo potenciálnym spúšťačom a poznamenáva sa, že niektoré pody v ázijsko-tichomorskej oblasti dostali problematické vydanie skôr, ako sa pôvodne predpokladalo. Tento detail je dôležitý pre administrátorov: „problém s vydaním“ nemusí ovplyvniť každý pod v rovnakom okamihu. Kontrola na úrovni inštancie, načasovanie vydania a presná cesta k API sú užitočnejšie ako globálny predpoklad dostupnosti áno alebo nie. Pozrite si oficiálny záznam o incidente z januára .
Marec: krátkodobé zhoršenie základných služieb malo z prevádzkového hľadiska stále význam
Udalosť z 11. marca bola oveľa kratšia, pričom záznam o dôvere vykazoval približne 20 minút zhoršenia výkonu základnej služby. Krátke incidenty sa po obnovení ľahko ignorujú, ale stále môžu spôsobiť neúspešné požiadavky prehliadača, oneskorené volania API, duplicitné opakované pokusy klientov a zmätok, keď obrazovka používateľa funguje, zatiaľ čo integrácia nefunguje. Praktickým cieľom nie je nafúknuť krátke zhoršenie výkonu na globálny výpadok; ide o zachovanie dostatočného množstva telemetrie na určenie, či bola neúspešná transakcia skutočne potvrdená.
Keďže verejný záznam, ktorý tu bol preskúmaný, neposkytuje podrobnú technickú príčinu, nemal by sa pripisovať nasadeniu, databáze, sieti alebo konfigurácii zákazníka bez dodatočných dôkazov. To je užitočná disciplína pre hlásenie incidentov: rozlišujte, čo záznam o stave potvrdzuje, od toho, čo zostáva neznáme. Referenciou je incident dôveryhodnosti z 11. marca .
10. – 11. júna: zlyhania overovania odhalili závislosti medzi cloudmi
Spoločnosť Salesforce 10. júna oznámila prerušenie služieb, ktoré ovplyvnilo viacero cloudov vrátane Commerce Cloud, Marketing Cloud, Hyperforce a Heroku. Záznam o incidente opisuje dopad na overovanie a možné zlyhania viacfaktorového overovania. Zákazníci sa mohli stretnúť s problémami s prihlásením, aj keď samotná aplikácia alebo úložisko údajov neboli chybným komponentom.
Neskoršie preskúmanie nápravných opatrení spoločnosťou Heroku pridáva najjasnejší detail o hlavnej príčine: neúmyselná aktualizácia systému, ktorú dodávateľ použil na produkčnú infraštruktúru, zmenila prevádzkové prostredie. Spoločnosť Heroku uviedla, že incident ovplyvnil aj jej stránku so stavom systému, čím vytvoril komunikačný problém v čase, keď zákazníci potrebovali aktualizácie. Medzi nápravné opatrenia patrilo zastavenie bezobslužných aktualizácií operačných systémov dodávateľa, audit obrazov, zlepšenie správania pri spustení siete, posilnenie odolnosti stránky so stavom systému a rozšírenie testovania pomocou canary a regresného testovania.
18. – 19. júna: zlyhanie fyzického zariadenia sa stalo incidentom aplikácie
Incident v Marketing Cloud z 18. júna pripomína, že spoľahlivosť SaaS v konečnom dôsledku závisí od fyzických zariadení. Spoločnosť Salesforce oznámila, že porucha chladiaceho systému v jej dátovom centre v Indianapolise spôsobila narušenie siete, ktoré ovplyvnilo stanice Stacks 1 a 6. Mnoho fyzických a virtuálnych serverov bolo odpojených. Záložné generátory určitý čas podporovali prostredie a obnova si vyžadovala viac než len obnovenie napájania: tímy v kontrolovanej sekvencii opäť zaviedli do prevádzky úložisko, sieťové komponenty, databázové systémy, repliky a aplikačné služby.
Záznam o incidente ukazuje postupnú obnovu, pričom Stack 1 bol obnovený pred Stack 6 a následnými vplyvmi na služby, ako je Mobile Connect. Záznam spoločnosti Salesforce zahŕňa takmer 24 hodín, ale okno s najzávažnejším prerušením služby a širšie okno so znížením výkonu neboli identické. Tento rozdiel vysvetľuje, prečo niektorí používatelia mohli hlásiť obnovu, zatiaľ čo iní stále zaznamenali oneskorené odosielanie, problémy s registráciou alebo nedostupné funkcie. Primárnym odkazom je incident v dátovom centre v Indianapolise z 18. júna .
26. – 27. júna: E-mailové služby premenili nevybavené žiadosti na búrku opakovaných pokusov
Najprevádzkovejšie poučnou udalosťou roku 2025 bolo zhoršenie prevádzky e-mailových služieb zdokumentované v neskoršej analýze hlavných príčin spoločnosti Salesforce. Spúšťacia udalosť spotrebovala veľké množstvo zdrojov poštového servera. Pomalšie spracovanie spôsobilo, že externí poskytovatelia vykonali viac pokusov o pripojenie, čo spôsobilo opakovanú búrku. Nasledovali zlyhania poštového servera, oneskorené prichádzajúce a odchádzajúce správy a sekundárne problémy s výkonom frontu správ.
Obnova si vyžadovala niekoľko súbežných zásahov: vypnutie problematickej prevádzky, reštartovanie poštových služieb s frontami presunutými do pohotovostného úložiska, pridanie kapacity, optimalizáciu konfigurácie siete pomocou poskytovateľa agenta na prenos pošty od tretej strany, oddelenie prichádzajúcej a odchádzajúcej prevádzky medzi hostiteľmi, migráciu súborov na SSD disky a použitie obmedzovania brány firewall. Spoločnosť Salesforce varovala, že trvalé zlyhania e-mailov sa nebudú automaticky obnovovať a že opakované pokusy by mohli vytvoriť duplicitné záznamy typu e-mail-prípad. Zverejnená analýza hlavných príčin je obzvlášť cenná, pretože opisuje počiatočný spúšťač aj sekundárne účinky.
20. októbra: Závislosť od DNS spôsobila, že problém tretej strany vyzeral ako výpadok služby Salesforce.
Záznam o incidente spoločnosti Salesforce z 20. októbra opisuje rozsiahle narušenie viacerých cloudov spôsobené problémom DNS u externého dodávateľa cloudovej infraštruktúry. DNS je adresárový systém, ktorý pomáha softvéru lokalizovať koncové body služieb. Ak zlyhá kritická vyhľadávacia cesta, aplikácie môžu zobrazovať časové limity alebo chyby pripojenia, aj keď sa základné obchodné údaje nestratili.
V ten istý deň informácie o verejnom zdraví spoločnosti AWS identifikovali problémy s rozlišovaním DNS pre regionálne koncové body služby DynamoDB v oblasti US-EAST-1. Tieto dva záznamy by sa mali čítať spoločne, ale nie len tak zlúčiť: stránka so stavom služby Salesforce je autoritou pre dopad služby Salesforce, zatiaľ čo záznam o stave služby AWS opisuje udalosť v infraštruktúre v upstreame. Referencia služby Salesforce je záznam o incidente z 20. októbra a zodpovedajúca referencia v upstreame je udalosť o stave služby AWS .
Päť praktických lekcií pre administrátorov Salesforce
Monitorujte správny rozsah. Zaznamenávajte inštanciu, pod, zásobník, región a kritické produkty vašej organizácie. „Salesforce je funkčný“ nedokazuje, že vaša e-mailová služba, API, autentifikačná cesta alebo zásobník Marketing Cloud sú v poriadku.
Fronty a opakované pokusy považovať za súčasť výpadku. Keď je nadradená služba pomalá, automatické opakované pokusy môžu znásobiť zaťaženie a vytvoriť duplicitné záznamy. Pozastavte nepodstatné úlohy, operácie opakovaného prehrávania nastavte ako idempotentné a opätovne spracujte iba transakcie, ktorých konečný stav je známy.
Oddeľte dostupnosť od integrity údajov. Po obnovení porovnajte odoslané, neúspešné, vrátené, zaradené do frontu a trvalo neúspešné správy. V prípade vytvárania prípadov a zápisov do API overte, či bola požiadavka úspešná, a potom ju znova odošlite.
Navrhujte komunikáciu mimo zlyhávajúcej cesty. Prihláste sa na odber stránky Salesforce Trust, udržiavajte interný kanál incidentov a udržiavajte testovanú alternatívu pre aktualizácie zákazníkov a zamestnancov. Súčasťou incidentu sa môže stať stránka so stavom, ktorá závisí od rovnakej infraštruktúry.
Skontrolujte závislosti tretích strán. Do mapy závislostí zahrňte poskytovateľov identít, pripojené aplikácie, služby prenosu e-mailov, DNS, cloudovú infraštruktúru, middleware a monitorovanie. Plán kontinuity Salesforce, ktorý pokrýva iba používateľské rozhranie CRM, je neúplný.
Stručný kontrolný zoznam reakcie na výpadok
Potvrdenie: Skontrolujte stránku Salesforce Trust, kde nájdete presnú inštanciu alebo službu, a potom otestujte malý počet reprezentatívnych pracovných postupov.
Zabráňte hromadnému načítaniu, nepodstatným automatizáciám a agresívnym cyklom opakovaných pokusov, ktoré by mohli zhoršiť fronty alebo duplicitné zápisy.
Komunikácia: Zaznamenajte ID incidentu dôveryhodnosti, čas prvého pozorovania, ovplyvnený pracovný postup, text chyby a dopad na podnikanie.
Obnova: Zosúladenie frontov, výsledkov e-mailov, prípadov, zápisov cez API a naplánovaných úloh po obnovení zostáv Salesforce.
Učte sa: Porovnajte časovú os incidentu s vašimi RTO, RPO, politikou opakovania, mapou závislostí a plánom upozornenia zákazníkov.
Čo by sa nemalo zamieňať s výpadkom služby?
Rok 2025 priniesol aj rozsiahle bezpečnostné správy týkajúce sa spoločnosti Salesforce vrátane kampaní zahŕňajúcich kompromitované tokeny OAuth tretích strán. Tieto udalosti sú relevantné pre odolnosť, ale nie sú to isté ako výpadok dostupnosti. Vo svojom upozornení z augusta 2025 spoločnosť Google Threat Intelligence uviedla, že kampaň Salesloft Drift nevznikla zo zraniteľnosti v základnej platforme Salesforce a odporučila kontrolu integrácií, rotáciu prihlasovacích údajov a kontrolu protokolov monitorovania udalostí Salesforce. Toto rozlíšenie zabraňuje retrospektívnemu nesprávnemu označeniu incidentov prístupu k údajom ako prestojov alebo naopak, považovaniu výpadku za dôkaz porušenia. Pôvodné upozornenie je k dispozícii od spoločnosti Google Threat Intelligence .
Záverečné hodnotenie
Výpadky Salesforce v roku 2025 možno najlepšie chápať skôr ako portfólio režimov zlyhania než ako jeden príbeh o spoľahlivosti. Vydania môžu ovplyvniť konkrétne pody. Autentifikácia môže zlyhať v inak odlišných cloudoch. Chladiaci systém sa môže stať incidentom CRM. Záznamy nevybavených e-mailov sa môžu opakovanými pokusmi znásobiť. Zlyhanie DNS tretej strany môže prekročiť hranice organizácie.
Pre zákazníkov je trvalou odpoveďou vrstvená viditeľnosť a kontrolovaná obnova: presne vedieť, ktoré služby Salesforce spúšťajú ktoré obchodné procesy, monitorovať relevantný rozsah stavu, bezpečne uchovávať opakované pokusy, uchovávať dôkazy a overovať údaje po obnovení. Tieto kroky síce neodstránia prestoje poskytovateľa, ale môžu znížiť rozdiel medzi krátkym prerušením a dlhodobým obchodným incidentom.
Zdroje a overovacia poznámka
Tento článok bol preskúmaný a porovnaný so službou Trust status spoločnosti Salesforce , záznamami o incidentoch, na ktoré odkazujeme vyššie, analýzou hlavných príčin e-mailových služieb publikovanou spoločnosťou Salesforce, preskúmaním nápravných opatrení spoločnosťou Heroku, službou Google Threat Intelligence a panelom AWS Health Dashboard. Prehľad bol pripravený 16. septembra 2026. Stránky s incidentmi je možné aktualizovať po prvotnej publikácii, takže čitatelia, ktorí vyšetrujú novú udalosť, by mali používať živú stránku Trust a vlastné upozornenia pre jednotlivé inštancie.