Domov
» Správy
»
Aké sú hlavné príčiny rozsiahlych výpadkov cloudových platforiem?
Aké sú hlavné príčiny rozsiahlych výpadkov cloudových platforiem?
Stručná odpoveď: rozsiahle výpadky cloudovej platformy zvyčajne pramenia z reťazca zlyhaní, nie z jedného izolovaného nefunkčného servera. Riziková konfigurácia alebo zmena softvéru môže ovplyvniť zdieľanú závislosť, ako je identita, DNS, autorizácia alebo API riadiacej roviny. Prvé zlyhanie potom spustí opakované pokusy, zmeny prevádzky alebo automatické škálovanie, čo zvyšuje zaťaženie a rozkladá dopad medzi regiónmi alebo produktmi. Slabá pozorovateľnosť a neotestovaná cesta obnovy môžu spôsobiť dlhšie trvanie výpadku.
Tento vzorec je dôležitý, pretože mení to, na čo by ste sa mali pripraviť. „Cloud“ nie je jeden stroj a „poskytovateľ je nefunkčný“ nie je úplná diagnóza. Vaša aplikácia môže závisieť od viacerých služieb poskytovateľa, vašej vlastnej konfigurácie, externých rozhraní API a procesu obnovy, ktorý funguje iba vtedy, ak bol otestovaný. Táto príručka vysvetľuje hlavné príčiny, čo by mal začiatočník skontrolovať ako prvé a chyby, ktoré sťažujú zvládnutie rozsiahleho výpadku.
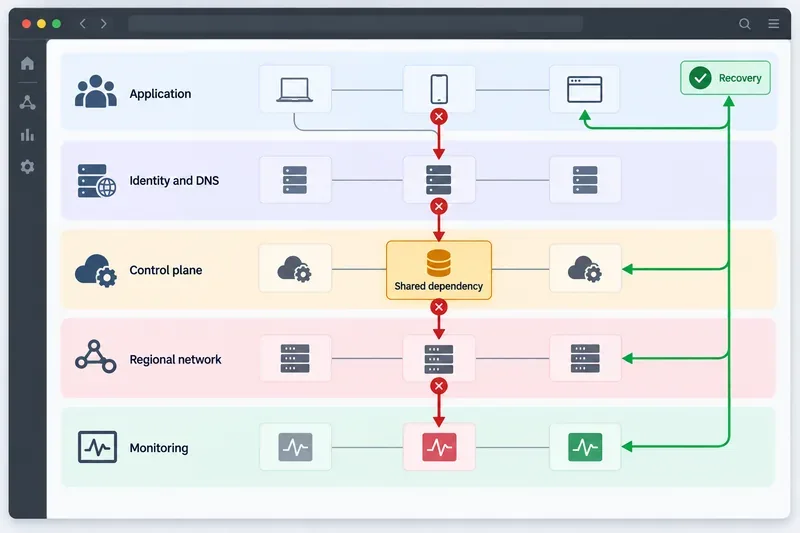
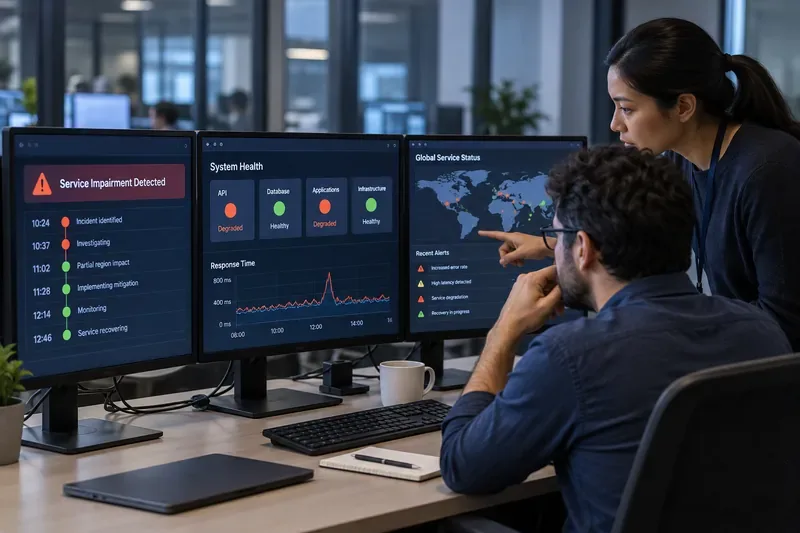
Koncepčný pohľad na to, ako sa môže zlyhanie v zdieľanej cloudovej závislosti kaskádovito šíriť cez vrstvy identity, riadiacej roviny, regionálnej vrstvy a monitorovania predtým, ako sa obnoví systém.
Najprv pochopte, čo znamená „rozsiahly prestoj“
Dostupnosť vyjadruje, či služba dokáže úspešne odpovedať na požiadavku. Zníženie výkonu znamená, že odpovedá, ale príliš pomaly alebo so zvýšenou mierou chybovosti. Rozsiahly incident môže ovplyvniť dátovú rovinu – systémy, ktoré obsluhujú prenos aplikácií – alebo riadiacu rovinu – rozhrania API a interné systémy používané na vytváranie, konfiguráciu, autentifikáciu a správu zdrojov. Výpadok riadiacej roviny môže zabrániť nasadeniu alebo škálovaniu, aj keď už spustené pracovné zaťaženia naďalej obsluhujú určitú prenosovú kapacitu.
Zdieľaná závislosť je služba, na ktorej závisí mnoho produktov alebo trás požiadaviek. Bežnými príkladmi sú DNS, správa identít a prístupov, overovanie certifikátov, smerovanie, metadáta, kvóty a pozorovateľnosť. Ak je táto závislosť centralizovaná alebo má spoločný režim zlyhania, malá chyba môže mať oveľa väčší polomer rozšírenia – skupinu zákazníkov, regiónov alebo služieb ovplyvnených jedným zlyhaním.
Hlavné príčiny rozsiahlych výpadkov cloudových platforiem
1. Zlá zmena, konfigurácia alebo pravidlo automatizácie
Zmeny sú hlavným zdrojom veľkých incidentov, pretože môžu byť správne v jednom kontexte a nebezpečné na úrovni platformy. Úprava povolení, pravidlo smerovania, príznak funkcie, zmena schémy alebo automatizovaná akcia kapacity sa môžu dotknúť každej oblasti alebo každého počítača orientovaného na zákazníka. Automatizácia môže zosilniť výsledok skôr, ako ho človek uvidí.
Oficiálna analýza výpadku spoločnosti Cloudflare z 18. novembra 2025 ilustruje túto triedu zlyhania. Zmena oprávnení databázy spôsobila duplicitné riadky v súbore funkcie Bot Management. Súbor sa zhruba zdvojnásobil, rozšíril sa na počítače po celom svete a prekročil limit v smerovacom softvéri. Cloudflare tvrdí, že incident nebol spôsobený kybernetickým útokom; zlyhanie vzniklo v dôsledku interakcie konfigurácie a softvéru. Spoločnosť zastavila šírenie a nasadila súbor, o ktorom sa vie, že je v poriadku. Prečítajte si analýzu výpadku spoločnosti Cloudflare z 18. novembra 2025, kde nájdete podrobný popis poskytovateľa.
2. Zlyhanie zdieľanej riadiacej roviny alebo základnej služby
Základné služby často stoja pod mnohými zdanlivo nesúvisiacimi produktmi. Identita, autorizácia, interný DNS, monitorovanie, metadáta a API používané na poskytovanie zdrojov sa môžu stať bežným bodom zlyhania. Príznaky, s ktorými sa zákazníci stretávajú, môžu vyzerať odlišne – zlyhania prihlásenia, chyby pri nasadení, časové limity alebo chýbajúce metriky – ale základná závislosť môže byť rovnaká.
Vo svojom súhrne po udalosti US-EAST-1 zo 7. decembra 2021 spoločnosť AWS opísala neočakávanú interakciu zahŕňajúcu automatizovanú škálovaciu aktivitu a interné sieťové zariadenia. AWS uviedla, že postihnutá sieť hostila základné služby vrátane monitorovania, interného DNS, autorizačných služieb a častí riadiacej roviny EC2. Pokusy o pripojenie a opakované pokusy potom prispeli k preťaženiu. Spoločnosť AWS tiež uviedla, že ovplyvnené bolo jej kontaktné centrum podpory a časti komunikačnej cesty o stave služieb. Súhrn AWS po udalosti je užitočným príkladom toho, prečo môže mať poskytovateľ ťažkosti so súčasným obnovením služieb aj ich diagnostikovaním.
3. Preťaženie, opakované búrky a kaskádové zlyhanie
Keď požiadavka zlyhá, klienti ju často opakujú. Búrka opakovaných pokusov nastáva, keď sa o ňu pokúša veľa klientov naraz, najmä bez exponenciálneho odloženia – stratégie, ktorá zvyšuje čakaciu dobu medzi pokusmi – a chvenia, ktoré pridáva malé náhodné oneskorenie. Tieto opakované pokusy spotrebúvajú rovnakú vzácnu kapacitu a môžu čiastočné zlyhanie zmeniť na rozsiahlejší výpadok.
Medzi ďalšie multiplikátory záťaže patria príliš časté kontroly stavu, automatické prepínanie pri zlyhaní, ktoré posiela prevádzku do už aj tak vyťaženej oblasti, fronty, ktoré naraz uvoľňujú všetky nevybavené položky, a politiky automatického škálovania, ktoré reagujú na príznaky, a nie na príčinu. Služba preto môže zlyhať, aj keď jej servery fyzicky nefungujú. Dôležitou otázkou nie je len „Môže poskytovateľ pridať kapacitu?“, ale aj „Pridávajú naši klienti a automatizácia viac práce do zlyhávajúcej cesty?“
4. Problémy s regionálnou infraštruktúrou, sieťou, napájaním alebo hardvérom
Cloudové platformy stále závisia od fyzických dátových centier, napájacích systémov, chladenia, optických liniek, smerovačov, úložných zariadení a regionálnych sieťových trás. Redundancia znižuje riziko, ale nerobí každú poruchu neviditeľnou. Zdieľané zariadenie, zóna dostupnosti, medziregionálne prepojenie alebo hranica smerovania môže ovplyvniť mnoho služieb naraz.
Regionálna obnova môže byť tiež nerovnomerná. Vo svojom zázname o incidente z 12. júna 2025 spoločnosť Google Cloud uviedla, že viacero produktov malo problémy s API súvisiace so základnou závislosťou, pričom obnova sa líšila v závislosti od lokality; v zázname sa konkrétne uvádzala pomalšia obnova v službách v strednej časti USA a v službách v USA a viacerých regiónoch. Záznam o incidente Google Cloud Service Health ukazuje, prečo kontrola jedného regiónu alebo jedného produktu nestačí na pochopenie celého rozsahu.
5. Softvérové chyby, chyby tvaru dát a tvrdé limity
Platforma môže byť v poriadku, kým nedostane neočakávaný vstup: súbor, ktorý je väčší ako limit analyzátora, duplicitný záznam, nezvyčajnú odpoveď API alebo migráciu údajov, ktorá odhalí predpoklad v staršom kóde. Tieto zlyhania sú obzvlášť nebezpečné, keď je rovnaká verzia alebo konfigurácia distribuovaná globálne.
Pevné limity nie sú vždy zrejmé z bežného testovania. Konfiguračný súbor môže byť platný, ale príliš veľký pre následný komponent. Miera požiadaviek môže byť v jednej oblasti prijateľná, ale po zlyhaní môže prekročiť kvótu. Úloha obnovy môže byť raz bezpečná, ale pri opakovaní môže vytvoriť duplicitnú prácu. Testovanie by malo zahŕňať chybné údaje, čiastočné zlyhanie závislostí, regionálnu evakuáciu a opakované vykonávanie – nielen šťastnú cestu.
6. Bezpečnostné udalosti, anomálie v prevádzke a nesprávne počiatočné predpoklady
Distribuované útoky typu „denial-of-service“, ukradnuté prihlasovacie údaje, zneužitie a škodlivé zmeny konfigurácie môžu spôsobiť výpadky. Nárast prenosovej prevádzky alebo zlyhanie overenia však nie je dôkazom útoku. Považovanie každého incidentu za bezpečnostnú udalosť môže poslať odpoveď nesprávnym smerom a oddialiť vrátenie konfigurácie späť.
Používajte dôkazy: porovnávajte vzory požiadaviek, protokoly autentifikácie, záznamy o zmenách, aktualizácie stavu poskytovateľov a nezávislé sondy. Udržujte eskaláciu zabezpečenia k dispozícii, ale oddeľte „to, čo vieme“ od „toho, čo máme podozrenie“. Cloudflareova analýza z roku 2025 je konkrétnou pripomienkou toho, že výpadok môže spočiatku vyzerať ako útok a stále mať inú príčinu.
7. Slepé miesta v monitorovaní a komunikácii stavu
Výpadok je ťažšie obmedziť, keď monitorovací systém závisí od rovnakej cesty zlyhania ako aplikácia. Ovládací panel môže ukazovať, že virtuálny stroj beží, zatiaľ čo zákazníci nemôžu dokončiť transakciu. Pokyny služby Google Cloud týkajúce sa SLO zameraných na zákazníka a vlastných metrík vysvetľujú tento rozdiel: dostupnosť infraštruktúry nie je to isté ako úspešná akcia zákazníka.
Použite aspoň jednu nezávislú syntetickú kontrolu – plánovaný test, ktorý vykoná bezpečnú transakciu podobnú transakcii zákazníka – mimo postihnutého prostredia. Zachovajte druhý spôsob prístupu k aktualizáciám incidentov a zaznamenávajte stránky so stavom poskytovateľa, interné upozornenia a správy od zákazníkov v jednej časovej osi. Nepredpokladajte, že stránka so stavom je neomylná: Cloudflare oznámil, že jeho vlastná stránka so stavom nebola počas incidentu v novembri 2025 dostupná, hoci bola hostovaná mimo infraštruktúry Cloudflare.
Príprava a reakcia pre začiatočníkov
Pred výpadkom: zmapujte, od čoho vaša služba skutočne závisí
Začnite s jednoduchou mapou závislostí. Zahrňte DNS, identitu, tajné kľúče, certifikáty, fronty, databázy, úložisko objektov, rozhrania API tretích strán, doručovanie obsahu, monitorovanie a oblasť poskytovateľa. Označte, ktoré komponenty sú potrebné pre každú požiadavku a ktoré je možné degradovať alebo obísť. Toto cvičenie často odhalí, že dve „nezávislé“ oblasti stále zdieľajú identitu, DNS, nástroje na nasadenie alebo jedného externého dodávateľa.
Definujte si RTO (cieľový čas obnovy, cieľový čas na obnovenie služby) a RPO (cieľový bod obnovy, prijateľné množstvo straty údajov merané v čase). Potom vyberte ovládacie prvky, ktoré zodpovedajú potrebám podniku. Malý interný dashboard môže akceptovať manuálnu obnovu. Platobný alebo núdzový pracovný postup môže vyžadovať službu pre viacero regiónov, testovanú replikáciu údajov a zdokumentovaného vlastníka prepnutia v prípade zlyhania.
Počas výpadku: pred zmenou overte rozsah
Skontrolujte, či je príznakom chyba aplikácie, incident poskytovateľa, regionálny problém alebo zlyhanie závislosti. V bezpečných prípadoch porovnajte viacero oblastí, účtov, sietí a ciest zákazníkov.
Zmrazte nesúvisiace nasadenia a zmeny konfigurácie. Zachovajte časové pečiatky, ID požiadaviek, vzorky chýb, posledné zmeny a prvý príznak viditeľný pre zákazníka.
Skontrolujte oficiálnu stránku poskytovateľa o stave služieb a záznam o incidentoch, ale nespoliehajte sa na jeden signál. Porovnajte to s nezávislými sondami a vlastnými protokolmi.
Bezpečne znížte zaťaženie. Používajte ohraničené opakovania s exponenciálnym odložením a jitterom, ističe, ktoré zastavia volania zlyhávajúcej závislosti, a ovládacie prvky frontu, ktoré zabránia náhlej búrke opakovaní.
Prepnutie na záložný systém vykonajte iba vtedy, keď je cieľ pripravený a postup bol otestovaný. Pred presmerovaním ďalšej prevádzky overte poverenia, správanie DNS TTL, konzistenciu údajov, idempotenciu a kapacitu downstreamu.
Oznámte, čo je potvrdené, čo sa vyšetruje, čo by mali zákazníci urobiť a kedy bude k dispozícii ďalšia aktualizácia. Vyhnite sa sľubovaniu času na zotavenie, ktorý dôkazy nepodporujú.
Stručný prehľad: indícia, pravdepodobná príčina a užitočná kontrola
Skorá indícia
Pravdepodobná príčina
Príprava alebo kontrola
Chyby sa začínajú vyskytovať ihneď po nasadení alebo zmene politiky
Zmena konfigurácie alebo softvéru
Vydania, schválenia, správa verzií a rýchle vrátenie zmien v Canary
Niekoľkým produktom sa nepodarí overiť alebo rozlíšiť mená
Zdieľaná identita, autorizácia alebo závislosť od DNS
Mapovanie závislostí a nezávislá prístupová cesta
Latencia sa zvyšuje so zvyšujúcim sa počtom opakovaných pokusov
Preťaženie alebo opakovanie búrky
Spomalenie, jitter, ističe a odľahčenie záťaže
Jeden región sa zotavuje, zatiaľ čo iný zostáva oslabený
Rozdiel v regionálnej kapacite alebo závislosti
Testované viacregionálne záložné prepnutie a regionálne runbooky
Infraštruktúra vyzerá zdravo, ale transakcie zlyhávajú
Medzera v pozorovateľnosti alebo závislosť od downstreamu
SLO na úrovni zákazníka a kontroly syntetických transakcií
Chyby, ktoré zhoršujú rozsiahle prestoje
Za predpokladu, že služba spravovaná poskytovateľom, vaša aplikácia nepotrebuje žiadny plán odolnosti.
Meranie iba prevádzkyschopnosti inštancie namiesto prihlásenia, platby, vyhľadávania alebo iných kritických ciest zákazníka.
Používanie nekonečného počtu opakovaní alebo reštartovanie všetkého naraz.
Prepnutie na cieľ, ktorý nebol testovaný pri skutočnej záťaži.
Vykonanie niekoľkých núdzových zmien bez zaznamenania, ktorá z nich pomohla.
Udržiavanie monitorovania, nasadenia a komunikácie o incidentoch na rovnakej ceste závislostí.
Označovanie incidentu za kybernetický útok predtým, ako dôkazy tento záver podporujú.
Zrátané a podčiarknuté
Hlavnými príčinami rozsiahlych výpadkov cloudu sú interagujúce systémy: nebezpečné zmeny, zdieľané závislosti, preťaženie a opakované pokusy, zlyhania regionálnej infraštruktúry, chyby softvéru a tvaru dát, bezpečnostné alebo dopravné udalosti a slepé miesta v detekcii. Nemôžete eliminovať každý výpadok poskytovateľa, ale môžete obmedziť jeho dosah. Mapujte závislosti, merajte výsledky zákazníkov, zabezpečte zdvorilé opakované pokusy, udržujte zmeny vratné, testujte záložné prepnutie a udržiavajte záznam o incidentoch, ktorý rozlišuje fakty od hypotéz.
Poznámka k zdroju: Tento článok bol skontrolovaný 16. septembra 2026. Incidenty poskytovateľov sú zdokumentované príklady, nie sú vyčerpávajúcim zoznamom a analýzy poskytovateľov nemusia odhaliť všetky interné detaily. Názvy produktov, architektúry, stránky so stavom a správanie pri obnove sa môžu časom meniť.