Hjem
» New Trends
»
Neste generasjons halvledere for AI og superdatamaskiner: Hva som betyr noe utover FLOPS
Neste generasjons halvledere for AI og superdatamaskiner: Hva som betyr noe utover FLOPS
I 2026 er den viktigste endringen innen AI og superdatamaskinvare ikke en eneste ny transistornode eller akselerator. Det er skiftet mot å designe hele databehandlingssystemet som én halvlederplattform: logikk, høybåndbreddeminne, chiplets, pakke, oppskaleringskoblinger, nettverksstruktur, strømforsyning, kjøling og programvare må alle optimaliseres sammen. NVIDIA sier at Vera Rubin-plattformen nå er i full produksjon, AMD lanserte Instinct MI400-familien i juli 2026, Micron sender HBM4 i volum, og TSMC sier at N2 startet storproduksjon sent i 2025, mens N2P og A16 er planlagt for volumproduksjon i andre halvdel av 2026. Denne utviklingen gjør én lærdom klar: å velge neste generasjons halvledere betyr nå å velge en systemarkitektur, ikke bare en brikke.
Det er viktig fordi den «beste» halvlederen er sterkt avhengig av arbeidsmengden. En opplæringsklynge i frontlinjemodeller, et nasjonalt superdatasenter, en skybasert inferenstjeneste og en AI-distribusjon i bedrifter kan alle favorisere ulike avveininger. Peak FLOPS alene er en dårlig kjøpsregel. Minnekapasitet, minnebåndbredde, sammenkoblingstopologi, støttede numeriske formater, programvaremodenhet, kjølekrav, tilgjengelighet og totale systemkostnader kan ha like stor betydning.
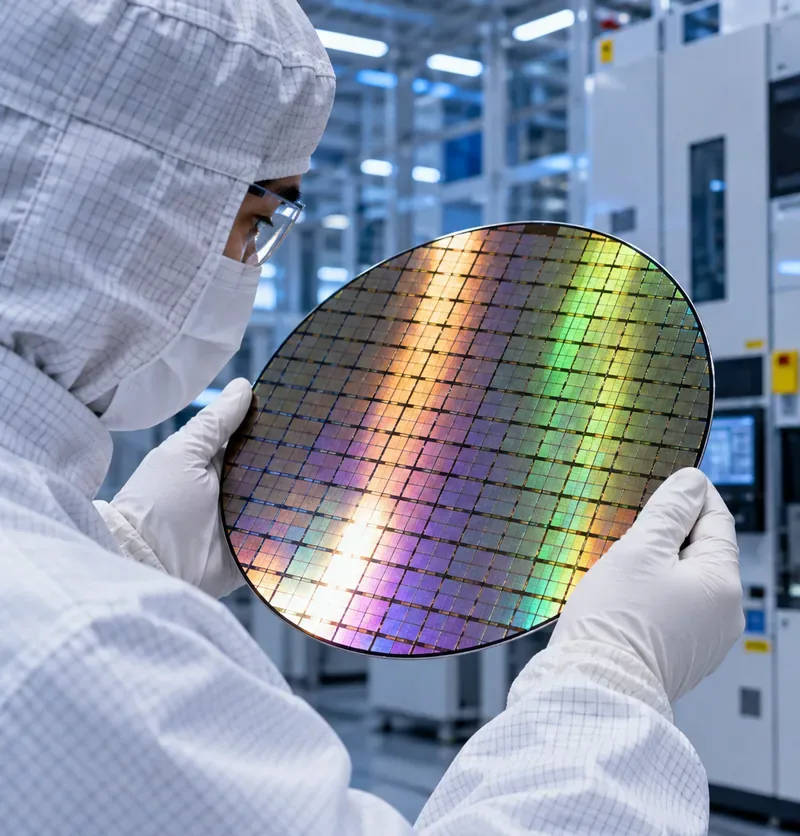
En renromstekniker inspiserer en mønstret silisiumskive, som illustrerer presisjonsproduksjonen bak avanserte prosessorer som brukes i AI og høyytelsesdatabehandling.
Skiftet i 2026: minne og sammenkobling er nå førsteklasses designbegrensninger
Moderne AI-akseleratorer kan utføre aritmetikk raskere enn data alltid kan leveres til dem. Det gjør minnebåndbredde og dataflyt sentralt for ytelse i den virkelige verden. Micron oppgir at deres HBM4 36 GB 12-høye produkt er i stor volumproduksjon og leverer mer enn 2,8 TB/s båndbredde per stabel, ved hjelp av et 2048-biters grensesnitt, med mer enn 20 % bedre energieffektivitet enn deres sammenlignbare HBM3E-produkt. Se Microns HBM4-produktinformasjon og deres HBM4-produksjonsmelding fra mars 2026 .
Ulempen er at HBM er dyrt og pakkekrevende. Flere stabler øker kapasitet og båndbredde, men de forstørrer også pakken, kompliserer ruting og strømforsyning, øker termisk tetthet og legger mer press på pakkeutbyttet. For minnebundet inferens, store anbefalingsmodeller, langkontekst LLM-servering og vitenskapelige arbeidsbelastninger med høy datagjenbruk, kan det være fornuftig å betale for mer HBM. For mindre modeller med lavt minnetrykk kan den premien være bortkastet.
Alternativ 1: integrerte GPU-racksystemer for maksimal AI-skalering
NVIDIAs Vera Rubin NVL72 illustrerer den systemfokuserte tilnærmingen. NVIDIA publiserer en konfigurasjon med 72 Rubin GPU-er og 36 Vera CPU-er, med 20,7 TB HBM4 på tvers av racket. Én enkelt Rubin GPU er oppført med 288 GB HBM4, mens NVLink 6 gir opptil 3,6 TB/s oppskaleringsbåndbredde per GPU. Plattformen er designet for forhåndstrening, ettertrening, skalering i testfasen og storskala agentisk inferens. Gjeldende spesifikasjoner er tilgjengelige på NVIDIA Vera Rubin NVL72-siden .
Fordelen er integrasjon. Beregning, CPU-GPU-koherens, oppskaleringsstruktur, nettverk, systemadministrasjon og programvare er konstruert sammen. Det kan redusere risikoen ved å sette sammen en stor klynge fra uavhengig optimaliserte komponenter. Det er spesielt attraktivt når tid til distribusjon og et modent GPU-programvareøkosystem er viktigere enn arkitektonisk åpenhet.
Avveiningen er en forpliktelse til en tett integrert plattform. Store racksystemer krever også betydelig anleggsplanlegging, inkludert væskekjøling, elektrisk distribusjon og nettverksdesign. Kjøpere bør sammenligne levert applikasjonsgjennomstrømning per rack og per megawatt, ikke bare akseleratorspesifikasjoner. Leverandørpubliserte tall for topp ytelse er teoretiske eller arbeidsbelastningsspesifikke og bør valideres med den faktiske modellen, batchstørrelsen, sekvenslengden, numerisk presisjonen og kommunikasjonsmønsteret som vil kjøre i produksjon.
Alternativ 2: GPU-systemer med mye brikkesett og en mer åpen infrastrukturstrategi
AMDs Instinct MI400-serie tar en annen vei, samtidig som den forfølger det samme målet på systemnivå. MI455X kombinerer chiplets, HBM4, avansert pakking og Infinity Fabric. AMD lister opp opptil 432 GB HBM4 og opptil 23,3 TB/s med maksimal teoretisk minnebåndbredde per MI455X GPU. Helios rackskala-referansedesign kombinerer 72 MI455X GPU-er og er bygget rundt åpne infrastrukturstandarder. AMD sier at volumdistribusjoner basert på Helios forventes i andre halvdel av 2026. Se siden om AMD Instinct MI400-serien .
Denne tilnærmingen er attraktiv når minnekapasitet, brikkemodularitet, ROCm og åpne rack- eller sammenkoblingsstandarder er strategiske prioriteringer. Mer lokal HBM kan redusere partisjoneringspresset på modeller og kan bidra til inferensarbeidsbelastninger med store KV-cacher eller arbeidsbelastninger som ellers ville spredt data over akseleratorer.
Avveiningen er programvarevalidering. En plattform kan ha sterke silisiumspesifikasjoner, men fortsatt kreve ingeniørarbeid hvis et kritisk rammeverk, en kjerne, et kollektivt kommunikasjonsmønster eller en tilpasset operator er bedre optimalisert andre steder. Organisasjoner som vurderer AMD bør sammenligne sine egne trenings- og inferensrørledninger under ROCm i stedet for å anta at portabilitet automatisk betyr lik ytelse.
Alternativ 3: spesialiserte AI-ASIC-er når arbeidsmengdetilpasning er viktigere enn generalitet
Googles TPU7x, også kjent som Ironwood, viser fordelene med en domenespesifikk akselerator. Google Cloud har 192 GB HBM per brikke, omtrent 7,38 TB/s HBM-båndbredde, 1,2 TB/s toveis båndbredde for sammenkobling mellom brikke og store pod-konfigurasjoner. Arkitekturen er bygget rundt tensor og sparse computing i stedet for å prøve å betjene alle mulige brukstilfeller for akseleratorer. Tekniske detaljer er tilgjengelige i Google Cloud TPU7x-dokumentasjonen .
En spesialisert akselerator kan være et sterkt valg når målmodellene kartlegges tydelig til kompilatoren, numeriske formater, minnehierarkiet og støttede rammeverk. Skylevering kan også fjerne mye av anleggsbyrden forbundet med å eie en stor AI-klynge.
Avveiningen er portabilitet og arbeidsmengdebredde. Hvis en organisasjon er avhengig av lavnivå CUDA-spesifikk kode, uvanlige kjerner, nisjebaserte vitenskapelige biblioteker eller applikasjoner utenfor akseleratorens optimale kapasitet, kan migreringskostnadene oppveie maskinvareeffektiviteten. Den riktige sammenligningen er derfor tid til resultat fra ende til ende og kostnad til resultat for den faktiske programvarestakken.
Avansert pakking blir like viktig som transistorskalering
De ledende AI-prosessorene er for komplekse til å behandle pakking som et passivt siste trinn. TSMCs CoWoS-plattform integrerer logikk og HBM ved hjelp av store mellomleggere, mens SoIC-teknologien støtter 3D-brikkestabling med høydensitets die-to-die-forbindelser. TSMC oppgir at 3nm SoIC-stabling startet volumproduksjon i 2025. CoWoS-L-teknologien har også skalert utover konvensjonelle begrensninger for retikkelstørrelse for store AI- og HPC-pakker. Se TSMCs offisielle CoWoS- og SoIC- teknologisider.
Intel Foundry forfølger et lignende mål med EMIB og Foveros. EMIB bruker innebygde silisiumbroer for å koble sammen brikker med høy tetthet uten å kreve en full silisiummellomlegger over hele pakken. Foveros legger til vertikal stabling, mens Foveros Direct bruker kobber-til-kobber-hybridbinding for svært fine brikker-til-brikker-forbindelser. Intel beskriver disse teknologiene på sin side om avansert pakkeing .
Det tekniske valget er ikke bare «2,5D versus 3D». Designere må balansere sammenkoblingstetthet, pakkestørrelse, termisk oppførsel, strategi for kjente komponenter, utbytte, monteringskompleksitet og kostnad. En 3D-stabel kan forkorte lenker og forbedre båndbreddetettheten, men vertikal stabling av varme beregningskomponenter kan gjøre varmefjerning vanskeligere. En 2,5D-arkitektur kan være enklere å kjøle ned og teste, men kan kreve et større fotavtrykk og lengre sammenkoblinger.
Avanserte prosessnoder er fortsatt viktige – men av spesifikke grunner
Transistorskalering er fortsatt viktig fordi AI- og HPC-systemer er strømbegrensede. TSMC sier at N2-teknologien deres startet volumproduksjon i fjerde kvartal 2025, ved bruk av nanosheet-transistorer, og at N2P og A16 er planlagt for volumproduksjon i andre halvdel av 2026. A16 legger til baksides strømforsyning, som flytter strømruting bort fra frontsidesignallagene og er rettet mot krevende HPC-design med tette strømnett. Se TSMC A16-teknologisiden .
Intels 18A-node kombinerer på lignende måte en gate-all-around transistorarkitektur, merket RibbonFET, med baksidestrømforsyning, merket PowerVia. Intel sa i juni 2026 at 18A hadde startet produksjon i 2025 og at 18A-P hadde startet risikoproduksjon. Se Intel Foundrys prosessoppdatering for 2026 .
Avveiningen er modenhet kontra maksimal effektivitet. En ny node kan forbedre ytelse, tetthet eller kraft, men modne noder tilbyr ofte bedre utbytte, lavere kostnader og et mer etablert designøkosystem. Chiplet-arkitekturer gjør dette valget mindre binært: databehandlingsfliser kan bruke den nyeste noden, mens I/O-, hurtigbuffer-, analog- eller grensesnittbrikker forblir på eldre, billigere prosesser.
Åpne chiplet-standarder kan redusere innelåsing, men interoperabilitet er ikke automatisk
UCIe er utviklet for å standardisere høyhastighets die-to-die-kommunikasjon mellom brikker. UCIe 3.0 støtter datahastigheter på 48 GT/s og 64 GT/s, noe som dobler den maksimale datahastigheten til UCIe 2.0, samtidig som den opprettholder bakoverkompatibilitet. Den utvider også administrasjons- og strømsparingsfunksjoner. Spesifikasjonsoversikten er tilgjengelig fra UCIe Consortium .
For halvlederdesignere kan UCIe gjøre det enklere å kombinere brikker fra forskjellige team, prosesser eller til slutt leverandører. For systemkjøpere betyr imidlertid ikke en åpen die-to-die-standard umiddelbart utskiftbare akseleratormoduler. Pakking, strømforsyning, fastvare, minnegrensesnitt, termisk design, sikkerhet, validering og programvare må fortsatt samkjøres. UCIe bør derfor sees på som en viktig byggestein for modulær design snarere enn en garanti for plug-and-play-silisium.
Hva bør du velge for ulike behov innen kunstig intelligens og superdatamaskiner?
Chiplet-fleksibilitet, tilgang til støperi, emballasjeøkosystem, åpne sammenkoblinger
Heterogene brikker med avansert 2,5D/3D-pakking
NRE-kostnad, valideringstid, pakkekapasitet og utbytte
Hvordan evaluere en neste generasjons halvlederplattform uten å bli villedet av overordnede spesifikasjoner
Start med arbeidsmengden, ikke brikken. Mål modellstørrelse, antall aktive parametere, kontekstlengde, batchstørrelse, kommunikasjonsintensitet, presisjonskrav, kontrollpunktsoppførsel og forventet utnyttelse. Deretter vurderer du maskinvaren mot disse begrensningene.
For beregningsbundne arbeidsbelastninger: sammenlign vedvarende kjerneytelse med den presisjonen du faktisk vil bruke, ikke bare topptall for FP4 eller FP8.
For minnebundne arbeidsbelastninger: prioriter effektiv HBM-båndbredde, kapasitet, hurtigbufferoppførsel og dataflyttingsoverhead.
For distribuert trening: mål kollektive operasjoner som alt-reduser og alt-til-alle ved det tiltenkte nodeantall.
For slutning: testtokener per sekund, tid til første token, latens mellom tokener, samtidighet og energi per forespørsel ved bruk av realistiske kontekstlengder.
For HPC: verifiser FP64, vektorytelse, minneoppførsel, kompilatorkvalitet, MPI-skalering og de nøyaktige vitenskapelige bibliotekene som er i bruk.
For planlegging av anlegg: inkluder rackstrøm, kjøleteknologi, gulvbelastning, nettverksoptikk, servicevennlighet og ledig kapasitet.
Dette er spesielt viktig i 2026 fordi leverandørarkitekturene er i divergerende utvikling. NVIDIAs Rubin-plattform vektlegger tett integrert rack-skala databehandling og nettverk; AMDs MI400-familie kombinerer stor HBM4-kapasitet med chiplets og en åpen infrastrukturstrategi; Google TPU7x retter seg mot tensor-sentriske arbeidsbelastninger gjennom en skylevert ASIC; TSMC, Intel, minneleverandører og standardiseringsorganer endrer samtidig de fysiske byggesteinene under dem alle.
Den praktiske konklusjonen: optimaliser hele datastien
Den neste generasjonen halvledere vil drive AI og superdatamaskiner, ikke fordi én enhet vinner alle testtester, men fordi industrien lærer å flytte data mer effektivt fra lagring til CPU, fra CPU til akselerator, mellom akseleratorer og mellom stablede brikker og HBM. HBM4, chiplets, 2,5D- og 3D-pakking, strømforsyning på baksiden, raske oppskaleringskoblinger og åpne die-to-die-standarder er alle svar på den samme begrensningen: aritmetikk er bare nyttig når data ankommer raskt nok og innenfor det tilgjengelige strømbudsjettet.
For organisasjoner som kjøper infrastruktur i dag, er den sikreste anbefalingen arbeidsbelastningsspesifikk. Velg en integrert GPU-plattform når økosystemmodenhet og rask skalering er prioritet. Vurder en åpen GPU-plattform når minnekapasitet, infrastrukturfleksibilitet og programvareportabilitet er strategisk. Bruk en spesialisert ASIC når arbeidsbelastningen er tydelig kartlagt til den, og sky- eller plattformavhengighet er akseptabel. For tilpasset silisium, invester i chiplets og avansert pakking når ytelses- og produktvolumgevinstene rettferdiggjør den ekstra design- og valideringskompleksiteten.
Viktigst av alt, test komplette systemer under produksjonsforhold. Halvlederen som ser raskest ut på et spesifikasjonsark, er kanskje ikke den som leverer den laveste kostnaden, korteste tiden til resultat eller best ytelse per watt for arbeidsmengden din.