Etusivu
» New Trends
»
Seuraavan sukupolven puolijohteet tekoälylle ja supertietokoneille: Mikä on tärkeää FLOPS-katkosten jälkeen?
Seuraavan sukupolven puolijohteet tekoälylle ja supertietokoneille: Mikä on tärkeää FLOPS-katkosten jälkeen?
Vuonna 2026 tärkein muutos tekoälyssä ja supertietokoneiden laitteistossa ei ole yksittäinen uusi transistorisolmu tai kiihdytin. Kyse on siirtymisestä koko laskentajärjestelmän suunnitteluun yhdeksi puolijohdealustaksi: logiikka, laajakaistainen muisti, sirut, kotelo, skaalauslinkit, verkkorakenne, virransyöttö, jäähdytys ja ohjelmistot on kaikki optimoitava yhdessä. NVIDIAn mukaan sen Vera Rubin -alusta on nyt täydessä tuotannossa, AMD julkaisi Instinct MI400 -perheensä heinäkuussa 2026, Micron toimittaa HBM4:ää massatuotantona ja TSMC:n mukaan N2 aloitti massatuotannon vuoden 2025 lopulla, kun taas N2P:n ja A16:n massatuotanto on määrä aloittaa vuoden 2026 jälkipuoliskolla. Nämä kehitysaskeleet tekevät yhden opetuksen selväksi: seuraavan sukupolven puolijohteiden valitseminen tarkoittaa nyt järjestelmäarkkitehtuurin valitsemista, ei vain sirun.
Tällä on merkitystä, koska "paras" puolijohde riippuu vahvasti työmäärästä. Pisteisiin keskittyvä koulutusklusteri, kansallinen supertietokonekeskus, pilvipohjainen päättelypalvelu ja yritystason tekoälyn käyttöönotto voivat kaikki suosia erilaisia kompromisseja. Pelkkä huippuluokan FLOPS-luku on huono ostosääntö. Muistikapasiteetti, muistin kaistanleveys, yhteenliitäntöjen topologia, tuetut numeeriset muodot, ohjelmiston kypsyysaste, jäähdytysvaatimukset, saatavuus ja järjestelmän kokonaiskustannukset voivat olla aivan yhtä tärkeitä.
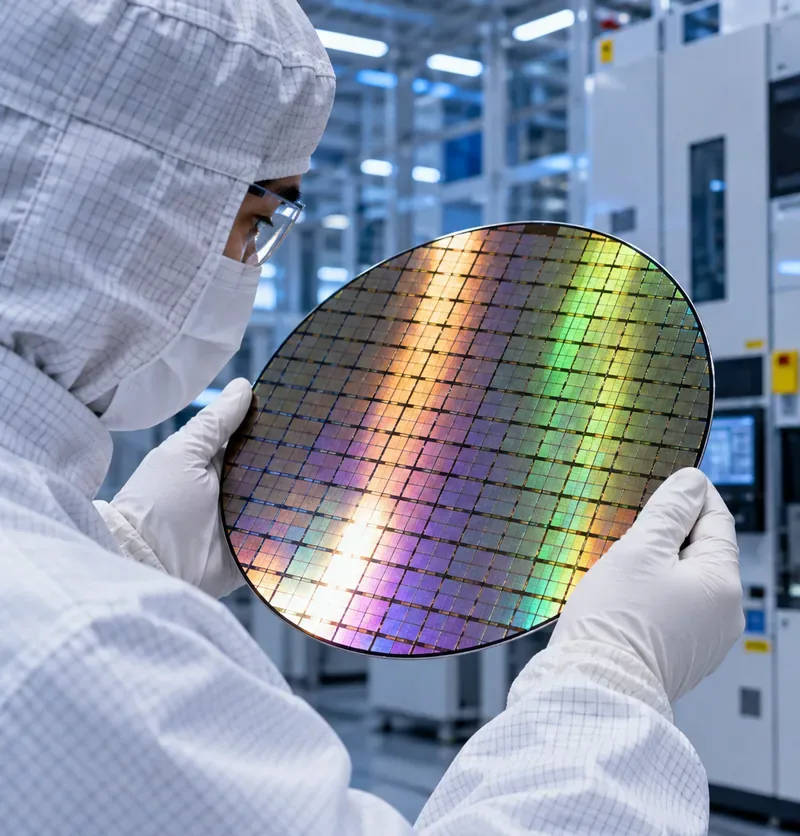
Puhdastilan teknikko tarkastaa kuvioitua piikiekkoa, joka havainnollistaa tekoälyssä ja suurteholaskennassa käytettyjen edistyneiden prosessorien tarkkuusvalmistusta.
Vuoden 2026 muutos: muisti ja yhteenliittäminen ovat nyt ensiluokkaisia suunnittelurajoitteita
Nykyaikaiset tekoälykiihdyttimet pystyvät suorittamaan aritmeettisia suorituksia nopeammin kuin niihin voidaan aina syöttää dataa. Tämä tekee muistin kaistanleveydestä ja datan siirrosta keskeisen osan reaalimaailman suorituskyvylle. Micron toteaa, että sen 36 Gt:n ja 12-muistikortilla varustettu HBM4-tuote on suurtuotannossa ja tarjoaa yli 2,8 Tt/s kaistanleveyttä pinoa kohden käyttämällä 2 048-bittistä rajapintaa ja yli 20 % paremmalla energiatehokkuudella kuin vastaava HBM3E-tuote. Katso Micronin HBM4-tuotetiedot ja sen maaliskuun 2026 HBM4-tuotantoilmoitus .
Kompromissi on, että HBM on kallista ja vaatii paljon pakkausta. Useammat pinot lisäävät kapasiteettia ja kaistanleveyttä, mutta ne myös suurentavat pakettia, monimutkaistavat reititystä ja virransyöttöä, lisäävät lämpötiheyttä ja asettavat enemmän paineita pakkauksen saatavuudelle. Muistiin sidotun päättelyn, suurten suositusmallien, pitkäkontekstisen LLM-tarjoilun ja paljon dataa uudelleenkäytettävien tieteellisten työkuormien kohdalla suuremmasta HBM:stä maksaminen voi olla järkevää. Pienemmissä malleissa, joissa on vähän muistipainetta, tämä lisä voi mennä hukkaan.
Vaihtoehto 1: integroidut GPU-räkkijärjestelmät maksimaaliseen tekoälyn skaalautumiseen
NVIDIAn Vera Rubin NVL72 havainnollistaa järjestelmäkeskeistä lähestymistapaa. NVIDIA julkaisee kokoonpanon, jossa on 72 Rubin-näytönohjainta ja 36 Vera-suoritinta, ja räkissä on 20,7 Tt HBM4-muistia. Yksi Rubin-näytönohjain on listattu 288 Gt:lla HBM4-muistia, kun taas NVLink 6 tarjoaa jopa 3,6 Tt/s skaalautuvaa kaistanleveyttä näytönohjainta kohden. Alusta on suunniteltu esikoulutukseen, jälkikoulutukseen, testiaikaiseen skaalaukseen ja laaja-alaiseen agenttiseen päättelyyn. Ajankohtaiset tiedot löytyvät NVIDIA Vera Rubin NVL72 -sivulta .
Etuna on integrointi. Laskenta, CPU-GPU-koherenssi, skaalautuva rakenne, verkko, järjestelmänhallinta ja ohjelmistot suunnitellaan yhdessä. Tämä voi vähentää riskiä koota suuri klusteri itsenäisesti optimoiduista komponenteista. Se on erityisen houkuttelevaa silloin, kun käyttöönottoaika ja kypsä GPU-ohjelmistoekosysteemi ovat tärkeämpiä kuin arkkitehtuurin avoimuus.
Kompromissi on sitoutuminen tiiviisti integroituun alustaan. Suuret räkkikokoiset järjestelmät vaativat myös merkittävää laitossuunnittelua, mukaan lukien nestejäähdytys, sähkönjakelu ja verkon suunnittelu. Ostajien tulisi verrata toimitettujen sovellusten läpimenoaikaa räkkiä ja megawattia kohden, ei pelkästään kiihdyttimien teknisiä tietoja. Toimittajien julkaisemat huippusuorituskykyluvut ovat teoreettisia tai työmääräkohtaisia, ja ne tulisi validoida todellisen mallin, eräkoon, sekvenssin pituuden, numeerisen tarkkuuden ja tuotannossa käytettävän kommunikaatiomallin avulla.
Vaihtoehto 2: sirupainotteiset GPU-järjestelmät ja avoimempi infrastruktuuristrategia
AMD:n Instinct MI400 -sarja valitsee eri reitin pyrkiessään samaan järjestelmätason tavoitteeseen. MI455X yhdistää sirut, HBM4:n, edistyneen koteloinnin ja Infinity Fabricin. AMD listaa jopa 432 Gt HBM4:ää ja jopa 23,3 TB/s teoreettista muistin kaistanleveyttä MI455X-näytönohjainta kohden. Helios-räkkikokoinen referenssirakenne yhdistää 72 MI455X-näytönohjainta ja on rakennettu avoimen infrastruktuurin standardien ympärille. AMD:n mukaan Heliokseen perustuvien volyymikäyttöönottojen odotetaan tapahtuvan vuoden 2026 jälkipuoliskolla. Katso AMD Instinct MI400 -sarjan sivu .
Tämä lähestymistapa on houkutteleva, kun muistikapasiteetti, sirujen modulaarisuus, ROCm ja avoimet räkki- tai yhteenliitäntästandardit ovat strategisia prioriteetteja. Paikallisempi HBM voi vähentää mallin osiointipainetta ja voi auttaa päättelemään työkuormia, joissa on suuria KV-välimuisteja tai työkuormia, jotka muuten leviäisivät dataa kiihdyttimien välillä.
Kompromissi on ohjelmiston validointi. Alustalla voi olla vahvat piispesifikaatiot, mutta se voi silti vaatia suunnittelutyötä, jos kriittinen kehys, ydin, kollektiivinen kommunikaatiomalli tai mukautettu operaattori on paremmin optimoitu muualla. AMD:tä harkitsevien organisaatioiden tulisi vertailla omia koulutus- ja päättelyputkiaan ROCm:n avulla sen sijaan, että oletetaan siirrettävyyden automaattisesti tarkoittavan samaa suorituskykyä.
Vaihtoehto 3: erikoistuneet tekoäly-ASIC-piirit, kun työmäärän sopivuus on yleisyyttä tärkeämpää
Googlen TPU7x, joka tunnetaan myös nimellä Ironwood, osoittaa toimialakohtaisen kiihdyttimen edut. Google Cloud listaa 192 Gt HBM:ää sirua kohden, noin 7,38 TB/s HBM-kaistanleveyttä, 1,2 TB/s kaksisuuntaista sirujen välistä yhteenliitäntäkaistanleveyttä ja suuret pod-kokoonpanot. Arkkitehtuuri on rakennettu tensorin ja harvan laskennan ympärille sen sijaan, että yritettäisiin palvella kaikkia mahdollisia kiihdyttimen käyttötapauksia. Tekniset tiedot ovat saatavilla Google Cloud TPU7x:n dokumentaatiossa .
Erikoistunut kiihdytin voi olla vahva valinta, kun kohdemallit vastaavat selkeästi sen kääntäjää, numeerisia muotoja, muistihierarkiaa ja tuettuja kehyksiä. Pilvipalvelu voi myös poistaa suuren tekoälyklusterin omistamiseen liittyvän laitteistotaakan.
Kompromissi on siirrettävyys ja työmäärän laajuus. Jos organisaatio luottaa matalan tason CUDA-spesifiseen koodiin, epätavallisiin ytimiin, tieteellisiin erikoiskirjastoihin tai sovelluksiin, jotka ovat kiihdyttimen optimaalisen sijainnin ulkopuolella, migraatiokustannukset voivat olla suuremmat kuin laitteiston tehokkuus. Oikea vertailukohta on siis ohjelmistopinon kokonaisvaltainen toteutusaika ja -kustannukset.
Edistyksellinen pakkaus on tulossa yhtä tärkeäksi kuin transistorien skaalaus
Johtavat tekoälyprosessorit ovat liian monimutkaisia, jotta pakkauksia voitaisiin käsitellä passiivisena viimeisenä vaiheena. TSMC:n CoWoS-alusta integroi logiikan ja HBM:n käyttämällä suuria välikappaleita, kun taas sen SoIC-teknologia tukee 3D-sirujen pinoamista tiheillä sirujen välisillä liitoksilla. TSMC ilmoittaa, että sen 3 nm:n SoIC-pinoaminen aloitti massatuotannon vuonna 2025. Sen CoWoS-L-teknologia on myös skaalautunut perinteisten ristikkokokorajoitusten yli suurille tekoäly- ja HPC-pakkauksille. Katso TSMC:n viralliset CoWoS- ja SoIC- teknologiasivut.
Intel Foundry pyrkii samankaltaiseen tavoitteeseen EMIB:n ja Foverosin kanssa. EMIB käyttää upotettuja piisiltoja piirilevyjen liittämiseen suurella tiheydellä ilman, että koko koteloon tarvitaan täysimittaista piisiruvälitintä. Foveros lisää pystysuuntaisen pinoamisen, kun taas Foveros Direct käyttää kupari-kupari-hybridiliitosta erittäin hienojakoisiin piirilevyjen välisiin liitoksiin. Intel kuvaa näitä teknologioita edistyneillä pakkaussivuillaan .
Tekninen valinta ei ole pelkästään ”2,5D vs. 3D”. Suunnittelijoiden on tasapainoteltava yhteenliitäntöjen tiheyden, kotelokoon, lämpökäyttäytymisen, tunnetun hyvän piirin strategian, saannon, kokoonpanon monimutkaisuuden ja kustannusten välillä. 3D-pino voi lyhentää linkkejä ja parantaa kaistanleveyden tiheyttä, mutta kuumien laskentapiirien pystysuora pinoaminen voi vaikeuttaa lämmönpoistoa. 2,5D-arkkitehtuuri voi olla helpompi jäähdyttää ja testata, mutta se voi vaatia suuremman tilan ja pidemmät yhteenliitännät.
Huippuluokan prosessisolmut ovat edelleen tärkeitä – mutta tietyistä syistä
Transistorien skaalaus on edelleen tärkeää, koska tekoäly- ja HPC-järjestelmät ovat teholtaan rajoitettuja. TSMC kertoo, että sen N2-teknologia aloitti massatuotannon vuoden 2025 viimeisellä neljänneksellä käyttäen nanosuikaletransistoreja, ja että N2P:n ja A16:n massatuotannon on määrä alkaa vuoden 2026 jälkipuoliskolla. A16 lisää takapuolen virransyötön, joka siirtää virranreitityksen pois etupuolen signaalikerroksista ja on suunnattu vaativiin HPC-malleihin, joissa on tiheät virtaverkot. Katso TSMC:n A16-teknologiasivu .
Intelin 18A-solmu yhdistää samalla tavalla porttitransistoriarkkitehtuurin, RibbonFET, ja takapuolen virransyötön, PowerVia. Intel ilmoitti kesäkuussa 2026, että 18A oli otettu tuotantoon vuonna 2025 ja että 18A-P oli otettu riskialttiiseen tuotantoon. Katso Intel Foundryn vuoden 2026 prosessipäivitys .
Kompromissi on kypsyyden ja maksimaalisen tehokkuuden välillä. Uusi solmu voi parantaa suorituskykyä, tiheyttä tai tehoa, mutta kypsät solmut tarjoavat usein paremman tuoton, alhaisemmat kustannukset ja vakiintuneemman suunnitteluekosysteemin. Chiplet-arkkitehtuurit tekevät tästä valinnasta vähemmän binäärisen: laskentatiilet voivat käyttää uusinta solmua, kun taas I/O-, välimuisti-, analogia- tai liitäntäpiirit pysyvät vanhemmissa, halvemmissa prosesseissa.
Avoimet sirustandardit voivat vähentää lukkiutumista, mutta yhteentoimivuus ei ole automaattista
UCIe on suunniteltu standardoimaan sirujen välistä nopeaa sirujen välistä tiedonsiirtoa. UCIe 3.0 tukee 48 GT/s ja 64 GT/s tiedonsiirtonopeuksia, mikä kaksinkertaistaa UCIe 2.0:n maksimitiedonsiirtonopeuden säilyttäen samalla taaksepäin yhteensopivuuden. Se myös laajentaa hallittavuutta ja virransäästöominaisuuksia. Teknisten tietojen yleiskatsaus on saatavilla UCIe Consortiumin verkkosivuilta .
Puolijohdesuunnittelijoille UCIe voi helpottaa eri tiimien, prosessien tai lopulta toimittajien sirujen yhdistämistä. Järjestelmän ostajille avoin sirusta siruun -standardi ei kuitenkaan tarkoita välittömästi keskenään vaihdettavia kiihdytinmoduuleja. Pakkauksen, tehonkäytön, laiteohjelmiston, muistiliitäntöjen, lämpösuunnittelun, tietoturvan, validoinnin ja ohjelmiston on vielä oltava yhdenmukaisia. UCIe:tä tulisi siksi pitää tärkeänä rakennuspalikkana modulaariselle suunnittelulle eikä takuuna plug-and-play-piipiirille.
Mitä sinun pitäisi valita erilaisiin tekoäly- ja supertietokonetarpeisiin?
NRE-kustannukset, validointiaika, pakkauskapasiteetti ja saanto
Kuinka arvioida seuraavan sukupolven puolijohdealustaa antamatta otsikkospesifikaatioiden johtaa sinua harhaan
Aloita työmäärästä, älä sirusta. Mittaa mallin kokoa, aktiivisten parametrien määrää, kontekstin pituutta, erän kokoa, tiedonsiirron intensiteettiä, tarkkuusvaatimuksia, tarkistuspisteiden toimintaa ja odotettua käyttöastetta. Arvioi sitten laitteistoa näiden rajoitusten perusteella.
Laskentamäärään sidottujen työkuormien osalta: vertaa ytimen jatkuvaa suorituskykyä sillä tarkkuudella, jota käytät tosiasiallisesti, äläkä pelkästään FP4- tai FP8-huippuarvoja.
Muistia käyttävien työkuormien osalta: priorisoi tehokasta HBM-kaistanleveyttä, kapasiteettia, välimuistin toimintaa ja tiedonsiirron lisäkustannuksia.
Hajautetussa harjoittelussa: mittaa kollektiivisia operaatioita, kuten all-reduce ja all-to-all, aiotulla solmumäärällä.
Päättelyä varten: testitokenit sekunnissa, aika ensimmäiseen tokeniin, tokenien välinen latenssi, samanaikaisuus ja energia pyyntöä kohden käyttäen realistisia kontekstin pituuksia.
HPC:tä varten: tarkista FP64, vektorien suorituskyky, muistin käyttäytyminen, kääntäjän laatu, MPI-skaalaus ja käytössä olevat tarkat tieteelliset kirjastot.
Tilojen suunnittelussa: sisällytä mukaan räkkien virransyöttö, jäähdytystekniikka, lattian kuormitus, verkon optiikka, huollettavuus ja varakapasiteetti.
Tämä on erityisen tärkeää vuonna 2026, koska toimittajien arkkitehtuurit eroavat toisistaan. NVIDIAn Rubin-alusta korostaa tiiviisti integroitua räkkikokoista laskentaa ja verkkoa; AMD:n MI400-perhe yhdistää suuren HBM4-kapasiteetin siruihin ja avoimen infrastruktuurin strategiaan; Google TPU7x kohdistaa tensorikeskeisiin työkuormiin pilvipohjaisen ASIC-piirin avulla; TSMC, Intel, muistitoimittajat ja standardointielimet muuttavat samanaikaisesti kaikkien alla olevia fyysisiä rakennuspalikoita.
Käytännön johtopäätös: optimoi koko datapolku
Seuraavan sukupolven puolijohteet eivät tule käyttämään tekoälyä ja supertietokoneita siksi, että yksi laite voittaisi jokaisen vertailukohdan, vaan koska teollisuus oppii siirtämään dataa tehokkaammin tallennustilasta suorittimelle, suorittimesta kiihdytinille, kiihdyttimien välillä sekä pinottujen piirien ja HBM:n välillä. HBM4, sirut, 2.5D- ja 3D-pakkaukset, taustapuolen virransyöttö, nopeat skaalauslinkit ja avoimet piiristä siruun -standardit ovat kaikki vastauksia samaan rajoitteeseen: aritmetiikka on hyödyllistä vain silloin, kun data saapuu riittävän nopeasti ja käytettävissä olevan tehobudjetin rajoissa.
Organisaatioille, jotka ostavat infrastruktuuria tänään, turvallisin suositus on työkuormakohtainen. Valitse integroitu GPU-alusta, kun ekosysteemin kypsyys ja nopea skaalautuvuus ovat etusijalla. Harkitse avointa GPU-alustaa, kun muistikapasiteetti, infrastruktuurin joustavuus ja ohjelmiston siirrettävyys ovat strategisia. Käytä erikoistunutta ASIC-piiriä, kun työkuorma vastaa sitä selkeästi ja pilvi- tai alustariippuvuus on hyväksyttävää. Mukautettujen piipiirien osalta investoi siruihin ja edistyneisiin paketteihin, kun suorituskyvyn ja tuotevolyymin kasvun odotetaan oikeuttavan ylimääräisen suunnittelun ja validoinnin monimutkaisuuden.
Tärkeintä on vertailla kokonaisia järjestelmiä tuotanto-olosuhteissa. Spesifikaatiotaulukossa nopeimmin toimiva puolijohde ei välttämättä ole se, joka tarjoaa alhaisimmat kustannukset, lyhimmän tulosajan tai parhaan suorituskyvyn wattia kohden työkuormallesi.