Αρχική
» New Trends
»
Ημιαγωγοί επόμενης γενιάς για Τεχνητή Νοημοσύνη και Υπερυπολογιστές: Τι έχει σημασία πέρα από τα FLOPS
Ημιαγωγοί επόμενης γενιάς για Τεχνητή Νοημοσύνη και Υπερυπολογιστές: Τι έχει σημασία πέρα από τα FLOPS
Το 2026, η πιο σημαντική αλλαγή στην Τεχνητή Νοημοσύνη και το υλικό υπερυπολογιστών δεν είναι ένας μόνο νέος κόμβος τρανζίστορ ή επιταχυντής. Είναι η στροφή προς τον σχεδιασμό ολόκληρου του υπολογιστικού συστήματος ως μία πλατφόρμα ημιαγωγών: η λογική, η μνήμη υψηλού εύρους ζώνης, τα τσιπλέτα, η συσκευασία, οι συνδέσεις κλιμάκωσης, η δομή δικτύου, η παροχή ισχύος, η ψύξη και το λογισμικό πρέπει όλα να βελτιστοποιηθούν από κοινού. Η NVIDIA αναφέρει ότι η πλατφόρμα Vera Rubin βρίσκεται πλέον σε πλήρη παραγωγή, η AMD λάνσαρε την οικογένεια Instinct MI400 τον Ιούλιο του 2026, η Micron αποστέλλει HBM4 σε μαζική παραγωγή και η TSMC αναφέρει ότι η N2 εισήλθε σε παραγωγή μεγάλου όγκου στα τέλη του 2025, ενώ οι N2P και A16 έχουν προγραμματιστεί για μαζική παραγωγή στο δεύτερο εξάμηνο του 2026. Αυτές οι εξελίξεις καθιστούν σαφές ένα μάθημα: η επιλογή ημιαγωγών επόμενης γενιάς τώρα σημαίνει επιλογή αρχιτεκτονικής συστήματος, όχι απλώς ενός τσιπ.
Αυτό έχει σημασία επειδή ο «καλύτερος» ημιαγωγός εξαρτάται σε μεγάλο βαθμό από το φόρτο εργασίας. Ένα σύμπλεγμα εκπαίδευσης με μοντέλο αιχμής, ένα εθνικό κέντρο υπερυπολογιστών, μια υπηρεσία συμπερασμάτων cloud και μια ανάπτυξη τεχνητής νοημοσύνης σε επιχειρήσεις μπορούν όλα να ευνοήσουν διαφορετικούς συμβιβασμούς. Τα Peak FLOPS από μόνα τους είναι ένας κακός κανόνας αγοράς. Η χωρητικότητα μνήμης, το εύρος ζώνης μνήμης, η τοπολογία διασύνδεσης, οι υποστηριζόμενες αριθμητικές μορφές, η ωριμότητα λογισμικού, οι απαιτήσεις ψύξης, η διαθεσιμότητα και το συνολικό κόστος του συστήματος μπορούν να έχουν εξίσου μεγάλη σημασία.
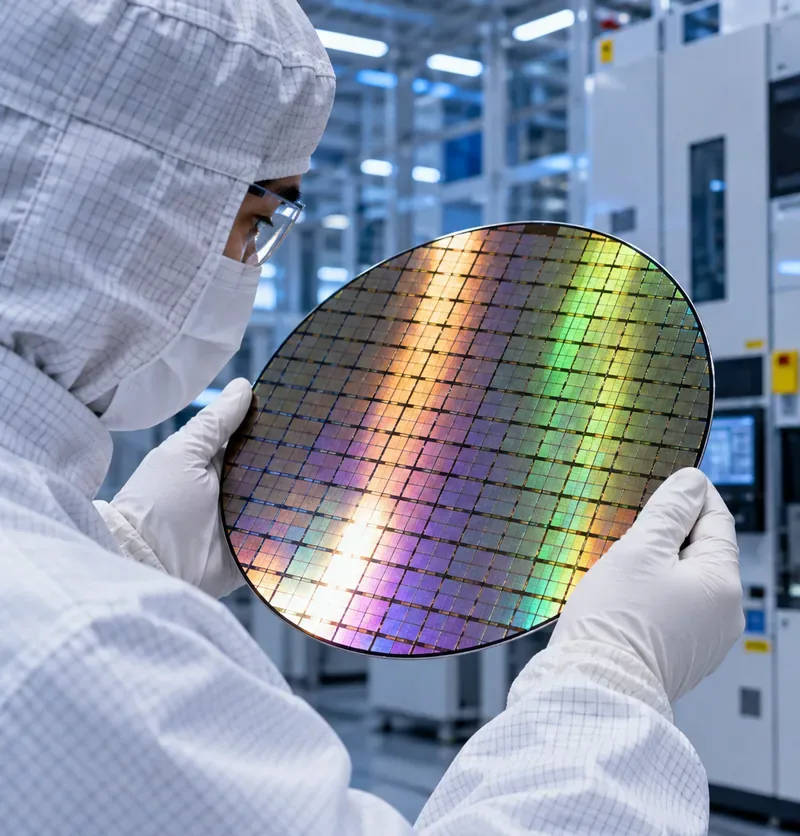
Ένας τεχνικός καθαρού δωματίου επιθεωρεί μια πλακέτα πυριτίου με μοτίβο, που δείχνει την ακριβή κατασκευή πίσω από τους προηγμένους επεξεργαστές που χρησιμοποιούνται στην Τεχνητή Νοημοσύνη και την υπολογιστική υψηλής απόδοσης.
Η μετατόπιση του 2026: η μνήμη και η διασύνδεση αποτελούν πλέον περιορισμούς σχεδιασμού πρώτης κατηγορίας
Οι σύγχρονοι επιταχυντές τεχνητής νοημοσύνης μπορούν να εκτελούν αριθμητικές εργασίες ταχύτερα από ό,τι μπορούν πάντα να τους παρέχονται δεδομένα. Αυτό καθιστά το εύρος ζώνης μνήμης και την κίνηση δεδομένων κεντρικής σημασίας για την απόδοση στον πραγματικό κόσμο. Η Micron δηλώνει ότι το προϊόν HBM4 36GB 12-high βρίσκεται σε παραγωγή μεγάλου όγκου και παρέχει εύρος ζώνης άνω των 2,8 TB/s ανά στοίβα, χρησιμοποιώντας μια διεπαφή 2.048-bit, με περισσότερο από 20% καλύτερη ενεργειακή απόδοση από το συγκρίσιμο προϊόν HBM3E. Δείτε τις πληροφορίες προϊόντος HBM4 της Micron και την ανακοίνωση παραγωγής HBM4 του Μαρτίου 2026 .
Το συμβιβασμό είναι ότι το HBM είναι ακριβό και απαιτεί μεγάλη ποσότητα συσκευασίας. Περισσότερες στοίβες αυξάνουν την χωρητικότητα και το εύρος ζώνης, αλλά επίσης διευρύνουν το πακέτο, περιπλέκουν τη δρομολόγηση και την παροχή ισχύος, αυξάνουν την θερμική πυκνότητα και ασκούν μεγαλύτερη πίεση στην απόδοση της συσκευασίας. Για συμπερασματολογία που συνδέεται με τη μνήμη, μεγάλα μοντέλα συστάσεων, εξυπηρέτηση LLM μεγάλου πλαισίου και επιστημονικά φόρτα εργασίας με υψηλή επαναχρησιμοποίηση δεδομένων, η πληρωμή για περισσότερο HBM μπορεί να έχει νόημα. Για μικρότερα μοντέλα με χαμηλή πίεση μνήμης, αυτό το premium μπορεί να σπαταληθεί.
Επιλογή 1: ενσωματωμένα συστήματα rack GPU για μέγιστη κλίμακα AI
Η κάρτα γραφικών Vera Rubin NVL72 της NVIDIA παρουσιάζει την προσέγγιση που δίνει προτεραιότητα στο σύστημα. Η NVIDIA δημοσιεύει μια διαμόρφωση 72 GPU Rubin και 36 CPU Vera, με 20,7 TB HBM4 σε όλο το rack. Μία μόνο GPU Rubin παρατίθεται με 288 GB HBM4, ενώ η NVLink 6 παρέχει έως και 3,6 TB/s εύρους ζώνης κλιμάκωσης ανά GPU. Η πλατφόρμα έχει σχεδιαστεί για προ-εκπαίδευση, μετ-εκπαίδευση, κλιμάκωση σε χρόνο δοκιμής και μεγάλης κλίμακας συμπερασματολογία πρακτόρων. Οι τρέχουσες προδιαγραφές είναι διαθέσιμες στη σελίδα NVIDIA Vera Rubin NVL72 .
Το πλεονέκτημα είναι η ενσωμάτωση. Η υπολογιστική ικανότητα, η συνοχή CPU-GPU, το κλιμακωτό δίκτυο, η δικτύωση, η διαχείριση συστήματος και το λογισμικό σχεδιάζονται μαζί. Αυτό μπορεί να μειώσει τον κίνδυνο συναρμολόγησης ενός μεγάλου συμπλέγματος από ανεξάρτητα βελτιστοποιημένα στοιχεία. Είναι ιδιαίτερα ελκυστικό όταν ο χρόνος ανάπτυξης και ένα ώριμο οικοσύστημα λογισμικού GPU έχουν μεγαλύτερη σημασία από την αρχιτεκτονική διαφάνεια.
Το αντάλλαγμα είναι η δέσμευση για μια στενά ενσωματωμένη πλατφόρμα. Τα μεγάλα συστήματα κλίμακας rack απαιτούν επίσης σημαντικό σχεδιασμό εγκαταστάσεων, συμπεριλαμβανομένης της υγρής ψύξης, της διανομής ηλεκτρικής ενέργειας και του σχεδιασμού δικτύου. Οι αγοραστές θα πρέπει να συγκρίνουν την απόδοση των εφαρμογών που παρέχονται ανά rack και ανά μεγαβάτ, όχι μόνο τις προδιαγραφές του επιταχυντή. Οι αριθμοί μέγιστης απόδοσης που δημοσιεύονται από τους προμηθευτές είναι θεωρητικοί ή συγκεκριμένοι για το φόρτο εργασίας και θα πρέπει να επικυρώνονται με το πραγματικό μοντέλο, το μέγεθος παρτίδας, το μήκος ακολουθίας, την αριθμητική ακρίβεια και το μοτίβο επικοινωνίας που θα εκτελεστεί στην παραγωγή.
Επιλογή 2: συστήματα GPU με chiplet και πιο ανοιχτή στρατηγική υποδομής
Η σειρά Instinct MI400 της AMD ακολουθεί διαφορετική πορεία, ενώ παράλληλα επιδιώκει τον ίδιο στόχο σε επίπεδο συστήματος. Η MI455X συνδυάζει chiplets, HBM4, προηγμένη συσκευασία και Infinity Fabric. Η AMD διαθέτει έως και 432 GB HBM4 και έως 23,3 TB/s μέγιστου θεωρητικού εύρους ζώνης μνήμης ανά GPU MI455X. Ο σχεδιασμός αναφοράς Helios σε κλίμακα rack συνδυάζει 72 GPU MI455X και βασίζεται σε πρότυπα ανοιχτής υποδομής. Η AMD αναφέρει ότι αναμένονται ογκώδεις αναπτύξεις με βάση το Helios το δεύτερο εξάμηνο του 2026. Δείτε τη σελίδα της σειράς AMD Instinct MI400 .
Αυτή η προσέγγιση είναι ελκυστική όταν η χωρητικότητα μνήμης, η αρθρωτή δομή chiplet, το ROCm και τα πρότυπα ανοιχτού rack ή διασύνδεσης αποτελούν στρατηγικές προτεραιότητες. Περισσότερο τοπικό HBM μπορεί να μειώσει την πίεση διαμέρισης μοντέλων και μπορεί να βοηθήσει στην εξαγωγή συμπερασμάτων για φόρτους εργασίας με μεγάλες προσωρινές μνήμες KV ή φόρτους εργασίας που διαφορετικά θα διαχέονταν δεδομένα σε επιταχυντές.
Το αντάλλαγμα είναι η επικύρωση λογισμικού. Μια πλατφόρμα μπορεί να έχει ισχυρές προδιαγραφές πυριτίου, αλλά να απαιτεί μηχανική εργασία εάν ένα κρίσιμο πλαίσιο, πυρήνας, συλλογικό μοτίβο επικοινωνίας ή προσαρμοσμένος χειριστής βελτιστοποιηθεί καλύτερα αλλού. Οι οργανισμοί που εξετάζουν το ενδεχόμενο AMD θα πρέπει να συγκρίνουν τις δικές τους αγωγούς εκπαίδευσης και συμπερασμάτων στο πλαίσιο του ROCm αντί να υποθέτουν ότι η φορητότητα σημαίνει αυτόματα ίση απόδοση.
Επιλογή 3: εξειδικευμένα ASIC τεχνητής νοημοσύνης όταν η προσαρμογή του φόρτου εργασίας έχει μεγαλύτερη σημασία από τη γενικότητα
Το TPU7x της Google, γνωστό και ως Ironwood, δείχνει τα οφέλη ενός επιταχυντή που λειτουργεί ειδικά για συγκεκριμένο τομέα. Το Google Cloud παραθέτει 192 GB HBM ανά τσιπ, περίπου 7,38 TB/s εύρος ζώνης HBM, 1,2 TB/s αμφίδρομο εύρος ζώνης διασύνδεσης μεταξύ τσιπ και διαμορφώσεις μεγάλων pod. Η αρχιτεκτονική βασίζεται σε τενσόρ και αραιό υπολογισμό αντί να προσπαθεί να εξυπηρετήσει κάθε πιθανή περίπτωση χρήσης του επιταχυντή. Οι τεχνικές λεπτομέρειες είναι διαθέσιμες στην τεκμηρίωση του Google Cloud TPU7x .
Ένας εξειδικευμένος επιταχυντής μπορεί να αποτελέσει μια ισχυρή επιλογή όταν τα μοντέλα-στόχοι αντιστοιχίζονται με σαφήνεια στον μεταγλωττιστή τους, στις αριθμητικές μορφές, στην ιεραρχία μνήμης και στα υποστηριζόμενα πλαίσια. Η παροχή υπηρεσιών cloud μπορεί επίσης να μειώσει μεγάλο μέρος του φόρτου των εγκαταστάσεων που σχετίζεται με την κατοχή ενός μεγάλου cluster AI.
Το αντάλλαγμα είναι η φορητότητα και το εύρος του φόρτου εργασίας. Εάν ένας οργανισμός βασίζεται σε κώδικα χαμηλού επιπέδου ειδικά για CUDA, ασυνήθιστους πυρήνες, εξειδικευμένες επιστημονικές βιβλιοθήκες ή εφαρμογές εκτός του sweet spot του επιταχυντή, το κόστος μετεγκατάστασης μπορεί να υπερτερήσει της αποδοτικότητας του υλικού. Η σωστή σύγκριση είναι επομένως ο χρόνος-από-τέλος-από-τέλος-αποτέλεσμα και το κόστος-από-αποτέλεσμα για την πραγματική στοίβα λογισμικού.
Η προηγμένη συσκευασία γίνεται τόσο σημαντική όσο η κλιμάκωση των τρανζίστορ
Οι κορυφαίοι επεξεργαστές τεχνητής νοημοσύνης είναι πολύ περίπλοκοι για να θεωρηθεί η συσκευασία ως ένα παθητικό τελικό βήμα. Η πλατφόρμα CoWoS της TSMC ενσωματώνει λογική και HBM χρησιμοποιώντας μεγάλους ενδιάμεσους, ενώ η τεχνολογία SoIC υποστηρίζει στοίβαξη τσιπ 3D με συνδέσεις υψηλής πυκνότητας die-to-die. Η TSMC δηλώνει ότι η στοίβαξη SoIC 3nm εισήλθε σε μαζική παραγωγή το 2025. Η τεχνολογία CoWoS-L έχει επίσης ξεπεράσει τους συμβατικούς περιορισμούς μεγέθους δικτυωτού πλέγματος για μεγάλα πακέτα τεχνητής νοημοσύνης και HPC. Δείτε τις επίσημες σελίδες τεχνολογίας CoWoS και SoIC της TSMC.
Η Intel Foundry επιδιώκει παρόμοιο στόχο με την EMIB και την Foveros. Η EMIB χρησιμοποιεί ενσωματωμένες γέφυρες πυριτίου για τη σύνδεση μήτρων υψηλής πυκνότητας χωρίς να απαιτείται πλήρης ενδιάμεσος πυριτίου σε ολόκληρο το πακέτο. Η Foveros προσθέτει κάθετη στοίβαξη, ενώ η Foveros Direct χρησιμοποιεί υβριδική σύνδεση χαλκού-με-χαλκό για πολύ λεπτές συνδέσεις μήτρας-με-μήτρας. Η Intel περιγράφει αυτές τις τεχνολογίες στη σελίδα προηγμένων συσκευασιών της .
Η επιλογή της μηχανικής δεν είναι απλώς «2.5D έναντι 3D». Οι σχεδιαστές πρέπει να εξισορροπήσουν την πυκνότητα των διασυνδέσεων, το μέγεθος της συσκευασίας, τη θερμική συμπεριφορά, τη στρατηγική της γνωστής καλής μήτρας, την απόδοση, την πολυπλοκότητα συναρμολόγησης και το κόστος. Μια στοίβα 3D μπορεί να μειώσει τους συνδέσμους και να βελτιώσει την πυκνότητα εύρους ζώνης, αλλά η κάθετη στοίβαξη θερμών υπολογιστικών μητρών μπορεί να δυσκολέψει την απομάκρυνση θερμότητας. Μια αρχιτεκτονική 2.5D μπορεί να είναι πιο εύκολη στην ψύξη και τη δοκιμή, αλλά μπορεί να απαιτεί μεγαλύτερο αποτύπωμα και μεγαλύτερες διασυνδέσεις.
Οι κόμβοι διεργασιών αιχμής εξακολουθούν να έχουν σημασία—αλλά για συγκεκριμένους λόγους
Η κλιμάκωση των τρανζίστορ παραμένει σημαντική, επειδή τα συστήματα AI και HPC έχουν περιορισμένη ισχύ. Η TSMC αναφέρει ότι η τεχνολογία N2 εισήλθε σε μαζική παραγωγή το τέταρτο τρίμηνο του 2025, χρησιμοποιώντας τρανζίστορ νανοφύλλων, και ότι τα N2P και A16 έχουν προγραμματιστεί για μαζική παραγωγή το δεύτερο εξάμηνο του 2026. Το A16 προσθέτει παροχή ισχύος από πίσω, η οποία μετακινεί τη δρομολόγηση ισχύος μακριά από τα μπροστινά επίπεδα σήματος και στοχεύει σε απαιτητικά σχέδια HPC με πυκνά δίκτυα ισχύος. Δείτε τη σελίδα τεχνολογίας TSMC A16 .
Ο κόμβος 18A της Intel συνδυάζει ομοίως μια αρχιτεκτονική τρανζίστορ με ολοκληρωμένη λειτουργία πύλης, με την επωνυμία RibbonFET, με παροχή ισχύος από πίσω, με την επωνυμία PowerVia. Η Intel δήλωσε τον Ιούνιο του 2026 ότι το 18A είχε εισέλθει στην παραγωγή το 2025 και ότι το 18A-P είχε εισέλθει σε επικίνδυνη παραγωγή. Δείτε την ενημέρωση διαδικασίας του Intel Foundry για το 2026 .
Το συμβιβασμό είναι η ωριμότητα έναντι της μέγιστης απόδοσης. Ένας νέος κόμβος μπορεί να βελτιώσει την απόδοση, την πυκνότητα ή την ισχύ, αλλά οι ώριμοι κόμβοι συχνά προσφέρουν καλύτερη απόδοση, χαμηλότερο κόστος και ένα πιο καθιερωμένο οικοσύστημα σχεδιασμού. Οι αρχιτεκτονικές chiplet καθιστούν αυτήν την επιλογή λιγότερο δυαδική: τα υπολογιστικά πλακίδια μπορούν να χρησιμοποιήσουν τον νεότερο κόμβο, ενώ τα I/O, η cache, τα αναλογικά ή τα die interface die παραμένουν σε παλαιότερες, φθηνότερες διεργασίες.
Τα ανοιχτά πρότυπα chiplet μπορούν να μειώσουν το lock-in, αλλά η διαλειτουργικότητα δεν είναι αυτόματη
Το UCIe έχει σχεδιαστεί για να τυποποιεί την επικοινωνία υψηλής ταχύτητας μεταξύ chiplets. Το UCIe 3.0 υποστηρίζει ρυθμούς δεδομένων 48 GT/s και 64 GT/s, διπλασιάζοντας τον μέγιστο ρυθμό δεδομένων του UCIe 2.0, διατηρώντας παράλληλα συμβατότητα με παλαιότερες εκδόσεις. Επίσης, επεκτείνει τη διαχειρισιμότητα και τις λειτουργίες εξοικονόμησης ενέργειας. Η επισκόπηση των προδιαγραφών είναι διαθέσιμη από την Κοινοπραξία UCIe .
Για τους σχεδιαστές ημιαγωγών, το UCIe μπορεί να διευκολύνει τον συνδυασμό chiplets από διαφορετικές ομάδες, διαδικασίες ή τελικά προμηθευτές. Για τους αγοραστές συστημάτων, ωστόσο, ένα ανοιχτό πρότυπο die-to-die δεν μεταφράζεται αμέσως σε εναλλάξιμες μονάδες επιταχυντή. Η συσκευασία, η ισχύς, το υλικολογισμικό, οι διεπαφές μνήμης, ο θερμικός σχεδιασμός, η ασφάλεια, η επικύρωση και το λογισμικό πρέπει ακόμη να ευθυγραμμιστούν. Επομένως, το UCIe θα πρέπει να θεωρείται σημαντικό δομικό στοιχείο για τον αρθρωτό σχεδιασμό και όχι ως εγγύηση για plug-and-play πυρίτιο.
Τι πρέπει να επιλέξετε για διαφορετικές ανάγκες Τεχνητής Νοημοσύνης και υπερυπολογιστών;
Φορητότητα και μακροπρόθεσμη εξάρτηση από πλατφόρμα
Προσαρμοσμένη υποδομή πυριτίου ή κρατικής ιδιοκτησίας
Ευελιξία τσιπλέτ, πρόσβαση σε χυτήριο, οικοσύστημα συσκευασίας, ανοιχτές διασυνδέσεις
Ετερογενή τσιπλέτα με προηγμένη συσκευασία 2.5D/3D
Κόστος NRE, χρόνος επικύρωσης, χωρητικότητα συσκευασίας και απόδοση
Πώς να αξιολογήσετε μια πλατφόρμα ημιαγωγών επόμενης γενιάς χωρίς να παραπλανηθείτε από τις προδιαγραφές των κύριων προϊόντων
Ξεκινήστε με το φόρτο εργασίας, όχι με το τσιπ. Μετρήστε το μέγεθος του μοντέλου, τον αριθμό των ενεργών παραμέτρων, το μήκος του περιβάλλοντος, το μέγεθος της παρτίδας, την ένταση επικοινωνίας, τις απαιτήσεις ακρίβειας, τη συμπεριφορά των σημείων ελέγχου και την αναμενόμενη αξιοποίηση. Στη συνέχεια, αξιολογήστε το υλικό σε σχέση με αυτούς τους περιορισμούς.
Για φόρτους εργασίας που σχετίζονται με υπολογιστικές εργασίες: συγκρίνετε την απόδοση του πυρήνα με την ακρίβεια που θα χρησιμοποιήσετε στην πραγματικότητα, όχι μόνο τις μέγιστες τιμές του FP4 ή του FP8.
Για φόρτους εργασίας που περιορίζονται στη μνήμη: δώστε προτεραιότητα στο αποτελεσματικό εύρος ζώνης HBM, τη χωρητικότητα, τη συμπεριφορά της προσωρινής μνήμης και την επιβάρυνση μετακίνησης δεδομένων.
Για κατανεμημένη εκπαίδευση: μετρήστε συλλογικές λειτουργίες όπως all-reduce και all-to-all στον προβλεπόμενο αριθμό κόμβων.
Για συμπεράσματα: δοκιμαστικά tokens ανά δευτερόλεπτο, χρόνος έως το πρώτο token, καθυστέρηση μεταξύ των tokens, ταυτόχρονη χρήση και ενέργεια ανά αίτημα χρησιμοποιώντας ρεαλιστικά μήκη περιβάλλοντος.
Για HPC: επαλήθευση του FP64, της απόδοσης διανυσμάτων, της συμπεριφοράς μνήμης, της ποιότητας του μεταγλωττιστή, της κλιμάκωσης MPI και των ακριβών επιστημονικών βιβλιοθηκών που χρησιμοποιούνται.
Για τον σχεδιασμό εγκαταστάσεων: συμπεριλάβετε την ισχύ του rack, την τεχνολογία ψύξης, την φόρτιση δαπέδου, την οπτική δικτύου, τη δυνατότητα συντήρησης και την εφεδρική χωρητικότητα.
Αυτό είναι ιδιαίτερα σημαντικό το 2026, επειδή οι αρχιτεκτονικές των προμηθευτών αποκλίνουν. Η πλατφόρμα Rubin της NVIDIA δίνει έμφαση στην άρτια ενσωματωμένη υπολογιστική και δικτύωση σε κλίμακα rack. Η οικογένεια MI400 της AMD συνδυάζει μεγάλη χωρητικότητα HBM4 με chiplets και μια στρατηγική ανοιχτής υποδομής. Το Google TPU7x στοχεύει σε tensor-centric workloads μέσω ενός ASIC που παρέχεται από το cloud. Η TSMC, η Intel, οι προμηθευτές μνήμης και οι φορείς τυποποίησης αλλάζουν ταυτόχρονα τα φυσικά δομικά στοιχεία που κρύβονται πίσω από όλα αυτά.
Το πρακτικό συμπέρασμα: βελτιστοποίηση ολόκληρης της διαδρομής δεδομένων
Η επόμενη γενιά ημιαγωγών θα τροφοδοτήσει την Τεχνητή Νοημοσύνη και τους υπερυπολογιστές όχι επειδή μία συσκευή κερδίζει κάθε σημείο αναφοράς, αλλά επειδή η βιομηχανία μαθαίνει να μεταφέρει δεδομένα πιο αποτελεσματικά από την αποθήκευση στην CPU, από την CPU στον επιταχυντή, μεταξύ επιταχυντών και μεταξύ στοιβαγμένων μήτρων και HBM. Το HBM4, τα chiplets, η συσκευασία 2.5D και 3D, η παροχή ισχύος από πίσω, οι γρήγορες συνδέσεις κλιμάκωσης και τα ανοιχτά πρότυπα die-to-die είναι όλες απαντήσεις στον ίδιο περιορισμό: η αριθμητική είναι χρήσιμη μόνο όταν τα δεδομένα φτάνουν αρκετά γρήγορα και εντός του διαθέσιμου προϋπολογισμού ισχύος.
Για τους οργανισμούς που αγοράζουν υποδομές σήμερα, η ασφαλέστερη σύσταση είναι να είναι συγκεκριμένη για το φόρτο εργασίας. Επιλέξτε μια ενσωματωμένη πλατφόρμα GPU όταν η ωριμότητα του οικοσυστήματος και η ταχεία κλιμάκωση αποτελούν προτεραιότητα. Εξετάστε μια ανοιχτή πλατφόρμα GPU όταν η χωρητικότητα μνήμης, η ευελιξία της υποδομής και η φορητότητα του λογισμικού είναι στρατηγικά σημεία. Χρησιμοποιήστε ένα εξειδικευμένο ASIC όταν το φόρτο εργασίας αντιστοιχίζεται καθαρά σε αυτό και η εξάρτηση από το cloud ή την πλατφόρμα είναι αποδεκτή. Για προσαρμοσμένο πυρίτιο, επενδύστε σε chiplets και προηγμένες συσκευασίες όταν τα κέρδη απόδοσης και όγκου προϊόντος δικαιολογούν την επιπλέον πολυπλοκότητα σχεδιασμού και επικύρωσης.
Το πιο σημαντικό, συγκρίνετε τα πλήρη συστήματα υπό συνθήκες παραγωγής. Ο ημιαγωγός που φαίνεται πιο γρήγορος σε ένα φύλλο προδιαγραφών μπορεί να μην είναι αυτός που προσφέρει το χαμηλότερο κόστος, τον συντομότερο χρόνο επίτευξης αποτελέσματος ή την καλύτερη απόδοση ανά watt για το φόρτο εργασίας σας.