Hem
» New Trends
»
Nästa generations halvledare för AI och superdatorer: Vad som är viktigt utöver FLOPS
Nästa generations halvledare för AI och superdatorer: Vad som är viktigt utöver FLOPS
År 2026 är den viktigaste förändringen inom AI och superdatorhårdvara inte en enda ny transistornod eller accelerator. Det är skiftet mot att designa hela beräkningssystemet som en enda halvledarplattform: logik, högbandbreddsminne, chiplets, paket, uppskalningslänkar, nätverksstruktur, strömförsörjning, kylning och programvara måste alla optimeras tillsammans. NVIDIA säger att deras Vera Rubin-plattform nu är i full produktion, AMD lanserade sin Instinct MI400-familj i juli 2026, Micron levererar HBM4 i volym, och TSMC säger att N2 gick in i högvolymtillverkning i slutet av 2025 medan N2P och A16 är planerade för volymproduktion under andra halvåret 2026. Denna utveckling gör en lärdom tydlig: att välja nästa generations halvledare innebär nu att välja en systemarkitektur, inte bara ett chip.
Det spelar roll eftersom den "bästa" halvledaren är starkt beroende av arbetsbelastningen. Ett utbildningskluster i frontlinjen, ett nationellt superdatorcenter, en molninferenstjänst och en AI-distribution för företag kan alla gynna olika avvägningar. Enbart maximala FLOPS är en dålig inköpsregel. Minneskapacitet, minnesbandbredd, sammankopplingstopologi, numeriska format som stöds, mjukvarumognad, kylningskrav, tillgänglighet och total systemkostnad kan ha lika stor betydelse.
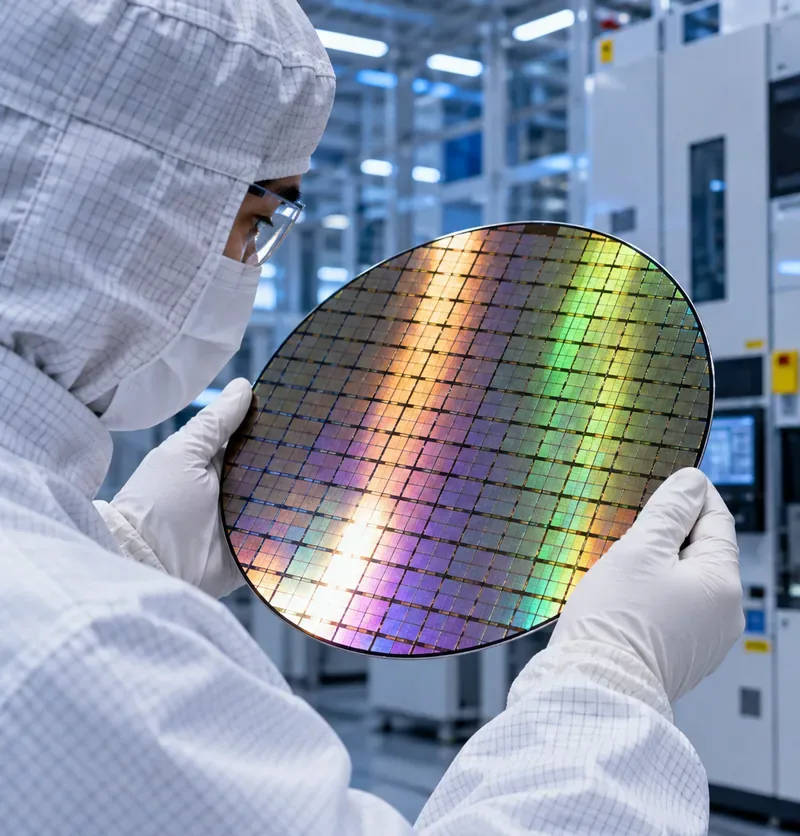
En renrumstekniker inspekterar en mönstrad kiselskiva och illustrerar precisionstillverkningen bakom avancerade processorer som används inom AI och högpresterande datoranvändning.
Skiftet 2026: minne och sammankoppling är nu förstklassiga designbegränsningar
Moderna AI-acceleratorer kan utföra aritmetik snabbare än data alltid kan levereras till dem. Det gör minnesbandbredd och dataförflyttning centrala för verklig prestanda. Micron uppger att deras HBM4 36 GB 12-bitars produkt är i stor volymproduktion och levererar mer än 2,8 TB/s bandbredd per stack, med ett 2 048-bitars gränssnitt, med mer än 20 % bättre energieffektivitet än deras jämförbara HBM3E-produkt. Se Microns HBM4-produktinformation och deras HBM4-produktionsmeddelande från mars 2026 .
Avvägningen är att HBM är dyrt och paketeringsintensivt. Fler stackar ökar kapacitet och bandbredd, men de förstorar också paketet, komplicerar routing och strömförsörjning, ökar värmedensiteten och sätter mer press på paketeringsutbytet. För minnesbunden inferens, stora rekommendationsmodeller, LLM-servering med lång kontext och vetenskapliga arbetsbelastningar med hög dataåteranvändning kan det vara vettigt att betala för mer HBM. För mindre modeller med låg minnesbelastning kan den premien vara bortkastad.
Alternativ 1: integrerade GPU-racksystem för maximal AI-skalning
NVIDIAs Vera Rubin NVL72 illustrerar den systemfokuserade metoden. NVIDIA publicerar en konfiguration med 72 Rubin-GPU:er och 36 Vera-processorer, med 20,7 TB HBM4 i racket. En enda Rubin-GPU listas med 288 GB HBM4, medan NVLink 6 ger upp till 3,6 TB/s skalbar bandbredd per GPU. Plattformen är utformad för förträning, efterträning, skalning vid testtid och storskalig agentinferens. Aktuella specifikationer finns tillgängliga på NVIDIA Vera Rubin NVL72-sidan .
Fördelen är integration. Beräkning, CPU-GPU-koherens, uppskalningsstruktur, nätverk, systemhantering och programvara är konstruerade tillsammans. Det kan minska risken för att sätta ihop ett stort kluster från oberoende optimerade komponenter. Det är särskilt attraktivt när tid till distribution och ett moget GPU-programvaruekosystem är viktigare än arkitektonisk öppenhet.
Avvägningen är ett engagemang för en tätt integrerad plattform. Stora racksystem kräver också betydande anläggningsplanering, inklusive vätskekylning, eldistribution och nätverksdesign. Köpare bör jämföra levererad applikationsgenomströmning per rack och per megawatt, inte bara acceleratorspecifikationer. Leverantörspublicerade siffror för topprestanda är teoretiska eller arbetsbelastningsspecifika och bör valideras med den faktiska modellen, batchstorleken, sekvenslängden, den numeriska precisionen och kommunikationsmönstret som kommer att köras i produktion.
Alternativ 2: chiplet-tunga GPU-system med en mer öppen infrastrukturstrategi
AMDs Instinct MI400-serie tar en annan väg samtidigt som den strävar efter samma mål på systemnivå. MI455X kombinerar chiplets, HBM4, avancerad kapsling och Infinity Fabric. AMD listar upp till 432 GB HBM4 och upp till 23,3 TB/s maximal teoretisk minnesbandbredd per MI455X GPU. Helios rackskaliga referensdesign kombinerar 72 MI455X GPU:er och är byggd kring öppna infrastrukturstandarder. AMD säger att volymdistributioner baserade på Helios förväntas under andra halvan av 2026. Se sidan om AMD Instinct MI400-serien .
Denna metod är tilltalande när minneskapacitet, chipletmodularitet, ROCm och öppna rack- eller sammankopplingsstandarder är strategiska prioriteringar. Mer lokal HBM kan minska trycket på modellpartitionering och kan bidra till inferensarbetsbelastningar med stora KV-cacher eller arbetsbelastningar som annars skulle spilla data över acceleratorer.
Avvägningen är mjukvaruvalidering. En plattform kan ha starka kiselspecifikationer men fortfarande kräva ingenjörsarbete om ett kritiskt ramverk, en kärna, ett kollektivt kommunikationsmönster eller en anpassad operator är bättre optimerad någon annanstans. Organisationer som överväger AMD bör jämföra sina egna tränings- och inferenspipelines under ROCm snarare än att anta att portabilitet automatiskt innebär samma prestanda.
Alternativ 3: specialiserade AI-ASIC:er när arbetsbelastningsanpassning är viktigare än generalitet
Googles TPU7x, även känd som Ironwood, visar fördelarna med en domänspecifik accelerator. Google Cloud listar 192 GB HBM per chip, cirka 7,38 TB/s HBM-bandbredd, 1,2 TB/s dubbelriktad bandbredd för sammankoppling mellan chip och stora pod-konfigurationer. Arkitekturen är byggd kring tensor- och gles beräkning snarare än att försöka tillgodose alla möjliga användningsfall för acceleratorer. Tekniska detaljer finns i Google Cloud TPU7x-dokumentationen .
En specialiserad accelerator kan vara ett starkt val när målmodellerna mappas tydligt till dess kompilator, numeriska format, minneshierarki och stödda ramverk. Molnleverans kan också ta bort mycket av den anläggningsbörda som är förknippad med att äga ett stort AI-kluster.
Avvägningen är portabilitet och arbetsbelastningsbredd. Om en organisation förlitar sig på lågnivå CUDA-specifik kod, ovanliga kärnor, nischade vetenskapliga bibliotek eller applikationer utanför acceleratorns optimala potential, kan migreringskostnaden överväga hårdvarueffektiviteten. Den korrekta jämförelsen är därför tid till resultat från början till slut och kostnad till resultat för den faktiska programvarustacken.
Avancerad kapsling blir lika viktig som transistorskalning
De ledande AI-processorerna är för komplexa för att behandla kapsling som ett passivt sista steg. TSMC:s CoWoS-plattform integrerar logik och HBM med hjälp av stora mellanlägg, medan dess SoIC-teknik stöder 3D-chipstackning med högdensitets die-to-die-anslutningar. TSMC uppger att deras 3nm SoIC-stackning gick in i volymproduktion 2025. Dess CoWoS-L-teknik har också skalats bortom konventionella begränsningar för riktmedelsstorlek för stora AI- och HPC-kapslingar. Se TSMC:s officiella CoWoS- och SoIC -tekniksidor.
Intel Foundry strävar efter ett liknande mål med EMIB och Foveros. EMIB använder inbäddade kiselbryggor för att ansluta chips med hög densitet utan att kräva en fullständig kiselmellanläggare över hela paketet. Foveros lägger till vertikal stapling, medan Foveros Direct använder koppar-till-koppar-hybridbindning för mycket fina chip-till-chip-anslutningar. Intel beskriver dessa tekniker på sin sida om avancerad paketering .
Det tekniska valet är inte bara "2,5D kontra 3D". Konstruktörer måste balansera sammankopplingstäthet, paketstorlek, termiskt beteende, strategi för kända kretsar, utbyte, monteringskomplexitet och kostnad. En 3D-stack kan förkorta länkar och förbättra bandbreddsdensiteten, men vertikal stapling av heta beräkningskretsar kan göra värmeavledning svårare. En 2,5D-arkitektur kan vara enklare att kyla och testa men kan kräva ett större fotavtryck och längre sammankopplingar.
Ledande processnoder är fortfarande viktiga – men av specifika skäl
Transistorskalning är fortfarande viktigt eftersom AI- och HPC-system är effektbegränsade. TSMC säger att deras N2-teknik påbörjades volymproduktion under fjärde kvartalet 2025, med hjälp av nanoskiktstransistorer, och att N2P och A16 är planerade för volymproduktion under andra halvan av 2026. A16 lägger till baksidans strömförsörjning, vilket flyttar strömförsörjningen bort från frontsidans signallager och är inriktat på krävande HPC-designer med täta strömnät. Se TSMC:s A16-tekniksida .
Intels 18A-nod kombinerar på liknande sätt en gate-allround-transistorarkitektur, märkt RibbonFET, med baksidesströmförsörjning, märkt PowerVia. Intel meddelade i juni 2026 att 18A hade påbörjat produktion 2025 och att 18A-P hade påbörjat riskproduktion. Se Intel Foundrys processuppdatering för 2026 .
Avvägningen är mognad kontra maximal effektivitet. En ny nod kan förbättra prestanda, densitet eller effekt, men mogna noder erbjuder ofta bättre avkastning, lägre kostnad och ett mer etablerat designekosystem. Chiplet-arkitekturer gör detta val mindre binärt: beräkningsplattor kan använda den senaste noden medan I/O-, cache-, analog- eller gränssnittschips finns kvar på äldre, billigare processer.
Öppna chiplet-standarder kan minska inlåsning, men interoperabilitet är inte automatisk
UCIe är utformad för att standardisera höghastighetskommunikation mellan chiplets. UCIe 3.0 stöder datahastigheter på 48 GT/s och 64 GT/s, vilket fördubblar den maximala datahastigheten för UCIe 2.0, samtidigt som bakåtkompatibilitet bibehålls. Den utökar också hanterbarheten och energisparfunktionerna. Specifikationsöversikten finns tillgänglig från UCIe Consortium .
För halvledarkonstruktörer kan UCIe göra det enklare att kombinera chiplets från olika team, processer eller så småningom leverantörer. För systemköpare leder dock en öppen die-to-die-standard inte omedelbart till utbytbara acceleratormoduler. Kapsling, strömförsörjning, firmware, minnesgränssnitt, termisk design, säkerhet, validering och programvara måste fortfarande anpassas. UCIe bör därför ses som en viktig byggsten för modulär design snarare än en garanti för plug-and-play-kisel.
Vad ska du välja för olika AI- och superdatorbehov?
Heterogena chiplets med avancerad 2,5D/3D-paketering
NRE-kostnad, valideringstid, förpackningskapacitet och utbyte
Hur man utvärderar nästa generations halvledarplattform utan att bli vilseledd av huvudspecifikationer
Börja med arbetsbelastningen, inte chipet. Mät modellstorlek, antal aktiva parametrar, kontextlängd, batchstorlek, kommunikationsintensitet, precisionskrav, kontrollpunktsbeteende och förväntad användning. Utvärdera sedan hårdvaran mot dessa begränsningar.
För beräkningsbundna arbetsbelastningar: jämför ihållande kärnprestanda med den precision du faktiskt kommer att använda, inte bara toppvärden för FP4 eller FP8.
För minnesbundna arbetsbelastningar: prioritera effektiv HBM-bandbredd, kapacitet, cachebeteende och dataförflyttningsoverhead.
För distribuerad träning: mät kollektiva operationer som all-reduce och all-to-all vid det avsedda antalet noder.
För inferens: testtokens per sekund, tid till första token, latens mellan tokens, samtidighet och energi per begäran med hjälp av realistiska kontextlängder.
För HPC: verifiera FP64, vektorprestanda, minnesbeteende, kompilatorkvalitet, MPI-skalning och exakt vilka vetenskapliga bibliotek som används.
För anläggningsplanering: inkludera rackkraft, kylteknik, golvbelastning, nätverksoptik, servicevänlighet och reservkapacitet.
Detta är särskilt viktigt under 2026 eftersom leverantörsarkitekturerna skiljer sig åt. NVIDIAs Rubin-plattform betonar tätt integrerad rackbaserad beräkning och nätverk; AMDs MI400-familj kombinerar stor HBM4-kapacitet med chiplets och en öppen infrastrukturstrategi; Google TPU7x riktar in sig på tensorcentrerade arbetsbelastningar genom en molnlevererad ASIC; TSMC, Intel, minnesleverantörer och standardiseringsorgan förändrar samtidigt de fysiska byggstenarna under dem alla.
Den praktiska slutsatsen: optimera hela datavägen
Nästa generations halvledare kommer att driva AI och superdatorer, inte för att en enhet vinner varje test, utan för att industrin lär sig att flytta data mer effektivt från lagring till processor, från processor till accelerator, mellan acceleratorer och mellan staplade chips och HBM. HBM4, chiplets, 2,5D- och 3D-kapsling, strömförsörjning på baksidan, snabba uppskalningslänkar och öppna die-to-die-standarder är alla svar på samma begränsning: aritmetik är bara användbart när data anländer tillräckligt snabbt och inom den tillgängliga energibudgeten.
För organisationer som köper infrastruktur idag är den säkraste rekommendationen arbetsbelastningsspecifik. Välj en integrerad GPU-plattform när ekosystemets mognad och snabb skalning är prioriterad. Överväg en öppen GPU-plattform när minneskapacitet, infrastrukturflexibilitet och programvaruportabilitet är strategiska. Använd en specialiserad ASIC när arbetsbelastningen mappas tydligt till den och moln- eller plattformsberoende är acceptabelt. För anpassad kisel, investera i chiplets och avancerad kapsling när prestanda- och produktvolymvinsterna motiverar den extra design- och valideringskomplexiteten.
Viktigast av allt, jämför kompletta system under produktionsförhållanden. Den halvledare som ser snabbast ut på ett specifikationsblad kanske inte är den som levererar den lägsta kostnaden, kortaste tiden till resultat eller bästa prestanda per watt för din arbetsbelastning.