Domov
» New Trends
»
Polovodiče novej generácie pre umelú inteligenciu a superpočítače: Na čom záleží viac než len FLOPS
Polovodiče novej generácie pre umelú inteligenciu a superpočítače: Na čom záleží viac než len FLOPS
V roku 2026 najdôležitejšou zmenou v oblasti umelej inteligencie a hardvéru superpočítačov nie je jediný nový tranzistorový uzol alebo akcelerátor. Ide o posun smerom k navrhovaniu celého výpočtového systému ako jednej polovodičovej platformy: logika, pamäť s vysokou šírkou pásma, čipy, puzdro, škálovateľné prepojenia, sieťová štruktúra, napájanie, chladenie a softvér musia byť spoločne optimalizované. NVIDIA uvádza, že jej platforma Vera Rubin je teraz v plnej výrobe, AMD uviedla na trh svoju rodinu Instinct MI400 v júli 2026, Micron dodáva HBM4 vo veľkom a TSMC uvádza, že N2 vstúpil do veľkoobjemovej výroby koncom roka 2025, zatiaľ čo N2P a A16 sú naplánované na veľkoobjemovú výrobu v druhej polovici roka 2026. Tento vývoj jasne ukazuje jedno ponaučenie: výber polovodičov novej generácie teraz znamená výber systémovej architektúry, nielen čipu.
To je dôležité, pretože „najlepší“ polovodič vo veľkej miere závisí od pracovného zaťaženia. Tréningový klaster hraničného modelu, národné superpočítačové centrum, cloudová inferenčná služba a nasadenie podnikovej umelej inteligencie môžu uprednostňovať rôzne kompromisy. Samotný maximálny počet FLOPS je zlým pravidlom nákupu. Rovnako dôležité môžu byť aj kapacita pamäte, šírka pásma pamäte, topológia prepojení, podporované číselné formáty, vyspelosť softvéru, požiadavky na chladenie, dostupnosť a celkové náklady na systém.
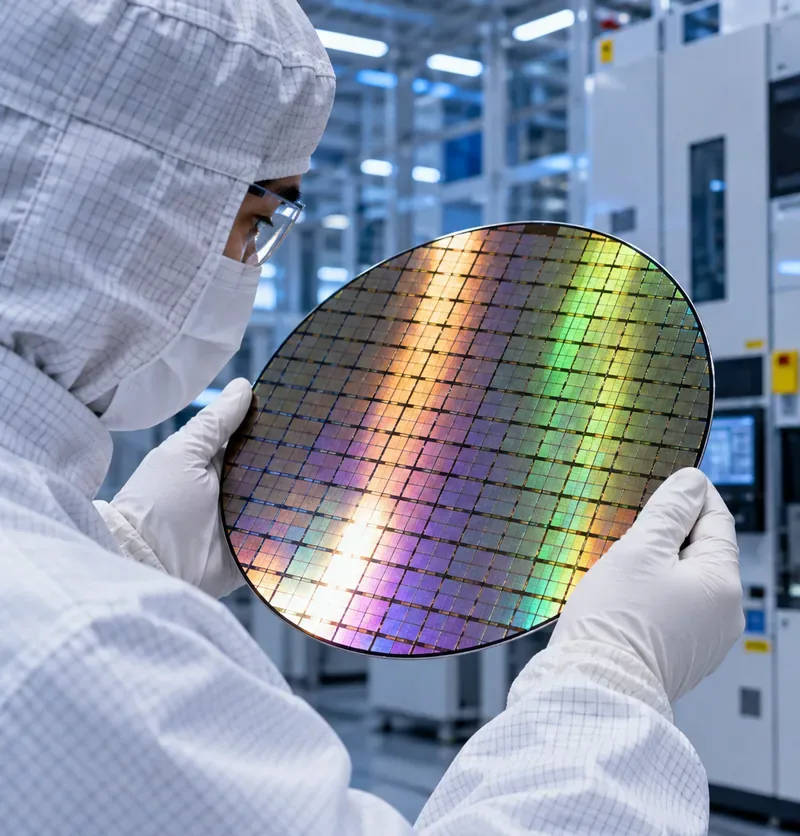
Technik čistých priestorov kontroluje vzorovaný kremíkový plátok, čím ilustruje precíznu výrobu pokročilých procesorov používaných v umelej inteligencii a vysokovýkonných výpočtoch.
Posun v roku 2026: pamäť a prepojenie sú teraz prvotriednymi konštrukčnými obmedzeniami
Moderné akcelerátory umelej inteligencie dokážu vykonávať aritmetické operácie rýchlejšie, ako im vždy stihnú dodať dáta. Vďaka tomu sú šírka pásma pamäte a presun dát kľúčové pre výkon v reálnom svete. Spoločnosť Micron uvádza, že jej produkt HBM4 36GB s kapacitou 12 GB je vo veľkoobjemovej výrobe a poskytuje šírku pásma viac ako 2,8 TB/s na zásobník s použitím 2 048-bitového rozhrania s viac ako 20 % lepšou energetickou účinnosťou ako jej porovnateľný produkt HBM3E. Pozrite si informácie o produkte HBM4 od spoločnosti Micron a jej oznámenie o výrobe HBM4 z marca 2026 .
Nevýhodou je, že HBM je drahé a náročné na balenie. Viac zásobníkov zvyšuje kapacitu a šírku pásma, ale tiež zväčšuje balenie, komplikuje smerovanie a dodávku energie, zvyšuje tepelnú hustotu a vyvíja väčší tlak na výťažnosť balenia. Pre pamäťovo viazanú inferenciu, rozsiahle odporúčacie modely, obsluhu LLM s dlhým kontextom a vedecké pracovné zaťaženia s vysokým opätovným použitím dát môže mať zmysel platiť za viac HBM. Pre menšie modely s nízkym zaťažením pamäte môže byť táto prémia premárnená.
Možnosť 1: integrované rackové systémy GPU pre maximálne škálovanie AI
Platforma NVIDIA Vera Rubin NVL72 ilustruje systémový prístup. NVIDIA publikuje konfiguráciu 72 grafických procesorov Rubin a 36 procesorov Vera s 20,7 TB pamäte HBM4 v celom racku. Jedna grafická karta Rubin je uvedená s 288 GB pamäte HBM4, zatiaľ čo NVLink 6 poskytuje šírku pásma škálovania až 3,6 TB/s na jednu grafickú kartu. Platforma je navrhnutá na predtréning, následný tréning, škálovanie počas testovania a rozsiahlu agentickú inferenciu. Aktuálne špecifikácie sú k dispozícii na stránke NVIDIA Vera Rubin NVL72 .
Výhodou je integrácia. Výpočty, koherencia CPU-GPU, škálovateľná infraštruktúra, sieťovanie, správa systému a softvér sú navrhnuté spoločne. To môže znížiť riziko zostavovania veľkého klastra z nezávisle optimalizovaných komponentov. Je to obzvlášť atraktívne, keď je čas nasadenia a zrelý ekosystém softvéru GPU dôležitejší ako architektonická otvorenosť.
Kompromisom je záväzok k úzko integrovanej platforme. Veľké rackové systémy si tiež vyžadujú rozsiahle plánovanie zariadení vrátane kvapalinového chladenia, elektrického rozvodu a návrhu siete. Kupujúci by mali porovnávať dodávanú priepustnosť aplikácií na rack a na megawatt, nielen špecifikácie akcelerátora. Čísla maximálneho výkonu publikované dodávateľom sú teoretické alebo špecifické pre pracovné zaťaženie a mali by byť overené skutočným modelom, veľkosťou dávky, dĺžkou sekvencie, numerickou presnosťou a komunikačným vzorom, ktorý bude bežať v produkčnom prostredí.
Možnosť 2: systémy GPU s vysokým počtom čipov a otvorenejšou infraštruktúrnou stratégiou
Séria AMD Instinct MI400 sa uberá inou cestou a zároveň sleduje rovnaký cieľ na systémovej úrovni. MI455X kombinuje čipy, HBM4, pokročilé balenie a Infinity Fabric. AMD uvádza až 432 GB HBM4 a až 23,3 TB/s maximálnej teoretickej šírky pásma pamäte na GPU MI455X. Referenčný dizajn Helios pre rackové použitie kombinuje 72 GPU MI455X a je postavený na štandardoch otvorenej infraštruktúry. AMD uvádza, že hromadné nasadenie založené na Heliose sa očakáva v druhej polovici roka 2026. Pozrite si stránku o sérii AMD Instinct MI400 .
Tento prístup je atraktívny, keď sú strategickými prioritami kapacita pamäte, modularita čipov, ROCm a štandardy otvoreného racku alebo prepojenia. Lokálnejší HBM môže znížiť tlak na rozdelenie modelu a môže pomôcť pri inferenčných pracovných zaťaženiach s veľkými vyrovnávacími pamäťami KV alebo pracovnými zaťaženiami, ktoré by inak rozptyľovali dáta medzi akcelerátormi.
Kompromisom je validácia softvéru. Platforma môže mať silné špecifikácie kremíka, ale stále si môže vyžadovať inžinierske práce, ak je kritický framework, jadro, kolektívny komunikačný vzorec alebo vlastný operátor lepšie optimalizovaný inde. Organizácie, ktoré zvažujú AMD, by mali porovnávať svoje vlastné tréningové a inferenčné kanály v rámci ROCm, a nie predpokladať, že prenosnosť automaticky znamená rovnaký výkon.
Možnosť 3: špecializované ASIC čipy s umelou inteligenciou, keď je pracovná záťaž dôležitejšia ako všeobecnosť
Google TPU7x, známy aj ako Ironwood, ukazuje výhody doménovo-špecifického akcelerátora. Google Cloud uvádza 192 GB HBM na čip, šírku pásma HBM približne 7,38 TB/s, obojsmernú šírku pásma medzičipového prepojenia 1,2 TB/s a konfigurácie veľkých podov. Architektúra je postavená na tenzorovom a riedkom výpočtovom procese, a nie na snahe obslúžiť každý možný prípad použitia akcelerátora. Technické podrobnosti sú k dispozícii v dokumentácii k Google Cloud TPU7x .
Špecializovaný akcelerátor môže byť dobrou voľbou, keď cieľové modely jasne zodpovedajú jeho kompilátoru, numerickým formátom, hierarchii pamäte a podporovaným frameworkom. Cloudové poskytovanie môže tiež odstrániť veľkú časť záťaže zariadenia spojenej s vlastníctvom veľkého klastra umelej inteligencie.
Kompromisom je prenositeľnosť a rozsah pracovnej záťaže. Ak sa organizácia spolieha na nízkoúrovňový kód špecifický pre CUDA, nezvyčajné jadrá, špecializované vedecké knižnice alebo aplikácie mimo dosahu akcelerátora, náklady na migráciu môžu prevážiť nad efektivitou hardvéru. Správne porovnanie je preto komplexný čas do dosiahnutia výsledku a pomer nákladov k výsledku pre samotný softvérový balík.
Pokročilé balenie sa stáva rovnako dôležitým ako škálovanie tranzistorov
Popredné procesory umelej inteligencie sú príliš zložité na to, aby sa ich balenie považovalo za pasívny posledný krok. Platforma CoWoS od spoločnosti TSMC integruje logiku a HBM pomocou veľkých medzičlánok, zatiaľ čo jej technológia SoIC podporuje 3D stohovanie čipov s vysokohustotnými prepojeniami medzi čipmi. Spoločnosť TSMC uvádza, že jej 3nm stohovanie SoIC vstúpilo do hromadnej výroby v roku 2025. Jej technológia CoWoS-L tiež prekročila konvenčné obmedzenia veľkosti mriežky pre veľké balíky umelej inteligencie a HPC. Pozrite si oficiálne stránky TSMC o technológiách CoWoS a SoIC .
Intel Foundry sleduje podobný cieľ s EMIB a Foveros. EMIB využíva vstavané kremíkové mostíky na prepojenie čipov s vysokou hustotou bez nutnosti použitia plnohodnotného kremíkového prechodníka v celom puzdre. Foveros pridáva vertikálne stohovanie, zatiaľ čo Foveros Direct používa hybridné prepojenie meď-meď pre veľmi jemné prepojenia medzi čipmi. Intel popisuje tieto technológie na svojej stránke o pokročilom balení .
Inžinierska voľba nie je len „2,5D verzus 3D“. Návrhári musia vyvážiť hustotu prepojení, veľkosť puzdra, tepelné správanie, stratégiu známych čipov, výťažnosť, zložitosť montáže a náklady. 3D stohovanie môže skrátiť prepojenia a zlepšiť hustotu šírky pásma, ale vertikálne stohovanie horúcich výpočtových čipov môže sťažiť odvod tepla. Architektúra 2,5D sa môže ľahšie chladiť a testovať, ale môže vyžadovať väčšiu zastavanú plochu a dlhšie prepojenia.
Špičkové procesné uzly sú stále dôležité – ale z konkrétnych dôvodov
Škálovanie tranzistorov zostáva dôležité, pretože systémy umelej inteligencie a HPC sú energeticky obmedzené. Spoločnosť TSMC uvádza, že jej technológia N2 vstúpila do sériovej výroby v štvrtom štvrťroku 2025 s použitím nanovrstvových tranzistorov a že sériová výroba N2P a A16 je naplánovaná na druhú polovicu roka 2026. A16 pridáva napájanie na zadnej strane, ktoré presúva smerovanie napájania od signálových vrstiev na prednej strane a je zamerané na náročné HPC návrhy s hustými napájacími sieťami. Pozrite si stránku TSMC venovanú technológii A16 .
Uzol 18A od spoločnosti Intel podobne kombinuje architektúru tranzistorov s obvodovým hradlom, označenú ako RibbonFET, s napájaním zozadu, označeným ako PowerVia. Spoločnosť Intel v júni 2026 uviedla, že 18A sa dostala do výroby v roku 2025 a že 18A-P sa dostala do rizikovej výroby. Pozrite si aktualizáciu procesu spoločnosti Intel Foundry z roku 2026 .
Kompromisom je zrelosť verzus maximálna účinnosť. Nový uzol môže zlepšiť výkon, hustotu alebo energiu, ale zrelé uzly často ponúkajú lepší výnos, nižšie náklady a zavedenejší ekosystém návrhu. Architektúry čipov robia túto voľbu menej binárnou: výpočtové dlaždice môžu používať najnovší uzol, zatiaľ čo I/O, vyrovnávacia pamäť, analógové alebo rozhraniové čipy zostávajú na starších, lacnejších procesoch.
Otvorené štandardy čipov môžu znížiť závislosť, ale interoperabilita nie je automatická
UCIe je navrhnutý tak, aby štandardizoval vysokorýchlostnú komunikáciu medzi čipmi medzi jednotlivými čipmi. UCIe 3.0 podporuje prenosové rýchlosti 48 GT/s a 64 GT/s, čím zdvojnásobuje maximálnu prenosovú rýchlosť UCIe 2.0 a zároveň si zachováva spätnú kompatibilitu. Rozširuje tiež možnosti správy a funkcie na úsporu energie. Prehľad špecifikácií je k dispozícii od konzorcia UCIe .
Pre návrhárov polovodičov môže UCIe uľahčiť kombinovanie čipov z rôznych tímov, procesov alebo prípadne dodávateľov. Pre kupujúcich systémov sa však otvorený štandard „čip-čip“ okamžite nepremieta do zameniteľných urýchľovacích modulov. Balenie, napájanie, firmvér, pamäťové rozhrania, tepelný dizajn, zabezpečenie, validácia a softvér sa ešte musia zosúladiť. UCIe by sa preto malo považovať skôr za dôležitý stavebný kameň modulárneho návrhu než za záruku kremíka typu „plug-and-play“.
Čo by ste si mali vybrať pre rôzne potreby v oblasti umelej inteligencie a superpočítačov?
Primárna potreba
Čomu dať prednosť
Pravdepodobný architektonický smer
Hlavný kompromis pri overovaní
Tréning na základe modelu Frontier
Škálovateľná šírka pásma, kapacita HBM, kolektívny výkon, zrelosť softvéru
Integrované systémy GPU pre rackové systémy
Napájanie, chladenie, sieťové pripojenie a celkové náklady na klaster
Inferencia LLM s vysokým objemom
Kapacita pamäte, šírka pásma pamäte, priepustnosť s nízkou presnosťou, cena za token
GPU stojany alebo špecializované akcelerátory AI
Latencia pri cieľovej súbežnosti a prispôsobenie modelu
Vedecká vysokovýkonná výpočtová technika (HPC)
výkon FP64, šírka pásma pamäte, MPI/komunikačný zásobník, validované knižnice
GPU zamerané na HPC plus vysokovýkonné CPU a sieťová infraštruktúra
Prenositeľnosť aplikácií a numerické požiadavky
Cloudovo natívna umelá inteligencia so štandardizovanými modelmi
Flexibilita čipov, prístup k odlievaniu, ekosystém balenia, otvorené prepojenia
Heterogénne čipy s pokročilým 2,5D/3D balením
Náklady na NRE, čas validácie, kapacita balenia a výťažnosť
Ako vyhodnotiť polovodičovú platformu novej generácie bez toho, aby vás zavádzali hlavné špecifikácie
Začnite s pracovnou záťažou, nie s čipom. Zmerajte veľkosť modelu, počet aktívnych parametrov, dĺžku kontextu, veľkosť dávky, intenzitu komunikácie, požiadavky na presnosť, správanie pri kontrolných bodoch a očakávané využitie. Potom vyhodnoťte hardvér vzhľadom na tieto obmedzenia.
Pre výpočtovo viazané úlohy: porovnajte trvalý výkon jadra s presnosťou, ktorú budete skutočne používať, nielen maximálne hodnoty FP4 alebo FP8.
Pre pamäťovo viazané pracovné zaťaženia: uprednostnite efektívnu šírku pásma HBM, kapacitu, správanie vyrovnávacej pamäte a réžiu presunu údajov.
Pre distribuované trénovanie: merajte kolektívne operácie, ako napríklad all-reduce a all-to-all, pri zamýšľanom počte uzlov.
Pre inferenciu: počet testovacích tokenov za sekundu, čas do prvého tokenu, latencia medzi tokenmi, súbežnosť a energia na požiadavku s použitím realistických dĺžok kontextu.
Pre HPC: overte FP64, výkon vektorov, správanie pamäte, kvalitu kompilátora, škálovanie MPI a presné používané vedecké knižnice.
Pri plánovaní zariadení: zahrňte napájanie rackov, chladiacu technológiu, zaťaženie podlahy, sieťovú optiku, prevádzkyschopnosť a voľnú kapacitu.
Toto je obzvlášť dôležité v roku 2026, pretože architektúry dodávateľov sa líšia. Platforma Rubin od spoločnosti NVIDIA kladie dôraz na úzko integrované výpočty a siete v rackovom meradle; rodina MI400 od spoločnosti AMD kombinuje veľkú kapacitu HBM4 s čipmi a stratégiou otvorenej infraštruktúry; Google TPU7x sa zameriava na tenzorovo orientované pracovné zaťaženia prostredníctvom cloudového ASIC; TSMC, Intel, dodávatelia pamätí a štandardizačné orgány súčasne menia fyzické stavebné bloky, ktoré sú základom všetkých týchto systémov.
Praktický záver: optimalizujte celú dátovú cestu
Ďalšia generácia polovodičov bude poháňať umelú inteligenciu a superpočítače nie preto, že jedno zariadenie vyhrá každý benchmark, ale preto, že sa priemysel učí efektívnejšie presúvať dáta z úložiska do CPU, z CPU do akcelerátora, medzi akcelerátormi a medzi stohovanými čipmi a HBM. HBM4, čipy, 2,5D a 3D balenie, napájanie zozadu, rýchle škálovateľné prepojenia a otvorené štandardy medzi čipmi sú všetko reakciami na to isté obmedzenie: aritmetika je užitočná iba vtedy, keď dáta prichádzajú dostatočne rýchlo a v rámci dostupného energetického rozpočtu.
Pre organizácie, ktoré si dnes kupujú infraštruktúru, je najbezpečnejším odporúčaním odporúčanie zamerané na pracovnú záťaž. Vyberte si integrovanú platformu GPU, keď je prioritou zrelosť ekosystému a rýchle škálovanie. Zvážte otvorenú platformu GPU, keď sú strategickými prvkami kapacita pamäte, flexibilita infraštruktúry a prenosnosť softvéru. Použite špecializovaný ASIC, keď sa naň pracovná záťaž jasne mapuje a závislosť od cloudu alebo platformy je prijateľná. V prípade vlastného kremíka investujte do chipletov a pokročilého balenia, keď zvýšenie výkonu a objemu produktov odôvodňuje dodatočnú zložitosť návrhu a validácie.
A čo je najdôležitejšie, porovnávajte kompletné systémy v produkčných podmienkach. Polovodič, ktorý vyzerá najrýchlejšie v špecifikácii, nemusí byť ten, ktorý poskytuje najnižšie náklady, najkratší čas do dosiahnutia výsledku alebo najlepší výkon na watt pre vašu pracovnú záťaž.