Sākums
» New Trends
»
Nākamās paaudzes pusvadītāji mākslīgajam intelektam un superdatoriem: kas ir svarīgāks par flopiem
Nākamās paaudzes pusvadītāji mākslīgajam intelektam un superdatoriem: kas ir svarīgāks par flopiem
2026. gadā vissvarīgākās izmaiņas mākslīgā intelekta un superdatoru aparatūrā nebūs viens jauns tranzistora mezgls vai paātrinātājs. Tā ir pāreja uz visas skaitļošanas sistēmas projektēšanu kā vienu pusvadītāju platformu: loģika, liela joslas platuma atmiņa, mikroshēmas, korpuss, mērogošanas saites, tīkla struktūra, barošanas avots, dzesēšana un programmatūra – viss ir jāoptimizē kopīgi. NVIDIA apgalvo, ka tās Vera Rubin platforma tagad ir pilnā ražošanā, AMD laida klajā savu Instinct MI400 saimi 2026. gada jūlijā, Micron piegādā HBM4 masveidā, un TSMC apgalvo, ka N2 sāka masveida ražošanu 2025. gada beigās, savukārt N2P un A16 masveida ražošana ir paredzēta 2026. gada otrajā pusē. Šīs norises skaidri parāda vienu mācību: nākamās paaudzes pusvadītāju izvēle tagad nozīmē sistēmas arhitektūras, nevis tikai mikroshēmas izvēli.
Tas ir svarīgi, jo “labākais” pusvadītājs ir ļoti atkarīgs no darba slodzes. Frontline modeļa apmācības klasteris, nacionālais superdatoru centrs, mākoņpakalpojumu secinājumu pakalpojums un uzņēmuma mākslīgā intelekta izvietošana var dot priekšroku dažādiem kompromisiem. Vienīgi maksimālais FLOPS ir slikts pirkšanas noteikums. Atmiņas ietilpība, atmiņas joslas platums, savienojumu topoloģija, atbalstītie skaitliskie formāti, programmatūras briedums, dzesēšanas prasības, pieejamība un kopējās sistēmas izmaksas var būt tikpat svarīgas.
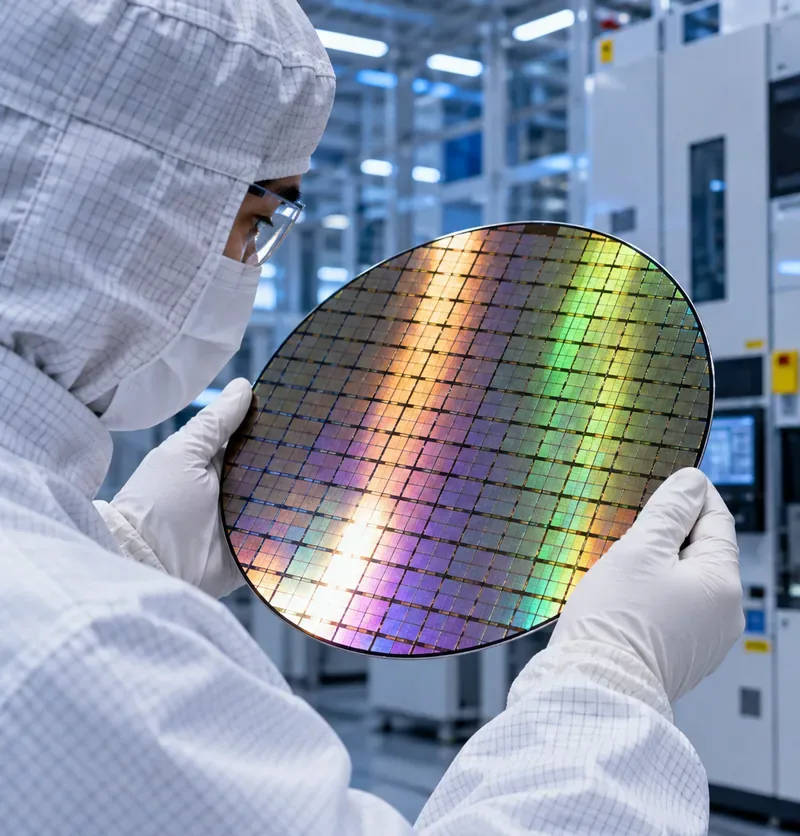
Tīrtelpas tehniķis pārbauda rakstainu silīcija vafeļu, kas ilustrē precīzu ražošanu, kuras pamatā ir progresīvie procesori, ko izmanto mākslīgajā intelektā un augstas veiktspējas skaitļošanā.
2026. gada maiņa: atmiņa un savstarpējie savienojumi tagad ir pirmās klases dizaina ierobežojumi
Mūsdienu mākslīgā intelekta paātrinātāji var veikt aritmētiku ātrāk, nekā tiem vienmēr var piegādāt datus. Tas padara atmiņas joslas platumu un datu kustību par centrālu reālās pasaules veiktspējas nodrošināšanā. Micron norāda, ka tā HBM4 36 GB 12 collu produkts tiek ražots lielā apjomā un nodrošina vairāk nekā 2,8 TB/s joslas platumu uz kaudzi, izmantojot 2048 bitu saskarni, ar vairāk nekā 20% labāku energoefektivitāti nekā salīdzināmajam HBM3E produktam. Skatiet Micron HBM4 produkta informāciju un tā 2026. gada marta HBM4 ražošanas paziņojumu .
Kompromiss ir tāds, ka HBM ir dārga un prasa daudz iepakojuma. Vairāk steku palielina ietilpību un joslas platumu, taču tie arī palielina iepakojuma izmēru, sarežģī maršrutēšanu un enerģijas piegādi, palielina termisko blīvumu un rada lielāku spiedienu uz iepakojuma ražu. Atmiņai ierobežotām secinājumu metodēm, lieliem ieteikumu modeļiem, ilga konteksta LLM apkalpošanai un zinātniskām darba slodzēm ar augstu datu atkārtotu izmantošanu maksāt par lielāku HBM var būt saprātīgi. Mazākiem modeļiem ar zemu atmiņas slodzi šī piemaksa var tikt izšķiesta.
1. variants: integrētas GPU plauktu sistēmas maksimālai mākslīgā intelekta mērogojamībai
NVIDIA Vera Rubin NVL72 ilustrē sistēmu pirmajā vietā. NVIDIA publicē konfigurāciju ar 72 Rubin GPU un 36 Vera CPU ar 20,7 TB HBM4 visā plauktā. Viens Rubin GPU ir norādīts ar 288 GB HBM4, savukārt NVLink 6 nodrošina līdz 3,6 TB/s palielināmas joslas platumu katram GPU. Platforma ir paredzēta priekšapmācībai, pēcapmācībai, mērogošanai testa laikā un liela mēroga aģentu secinājumiem. Pašreizējās specifikācijas ir pieejamas NVIDIA Vera Rubin NVL72 lapā .
Priekšrocība ir integrācija. Skaitļošana, centrālā procesora un grafikas procesora saskaņotība, mērogojamā struktūra, tīklošana, sistēmas pārvaldība un programmatūra tiek izstrādātas kopā. Tas var samazināt risku, ka no neatkarīgi optimizētiem komponentiem tiek izveidots liels klasteris. Tas ir īpaši pievilcīgi, ja izvietošanas laiks un nobriedusi grafikas procesora programmatūras ekosistēma ir svarīgāki par arhitektūras atvērtību.
Kompromiss ir apņemšanās izmantot cieši integrētu platformu. Lielām plauktu mēroga sistēmām ir nepieciešama arī ievērojama iekārtu plānošana, tostarp šķidruma dzesēšana, elektroenerģijas sadale un tīkla projektēšana. Pircējiem ir jāsalīdzina piegādātās lietojumprogrammu caurlaidspēja uz plauktu un uz megavatu, ne tikai paātrinātāju specifikācijas. Pārdevēju publicētie maksimālās veiktspējas rādītāji ir teorētiski vai specifiski darba slodzei, un tie ir jāapstiprina ar faktisko modeli, partijas lielumu, secības garumu, skaitlisko precizitāti un komunikācijas modeli, kas tiks izmantots ražošanā.
2. variants: mikroshēmu ietilpīgas GPU sistēmas ar atvērtāku infrastruktūras stratēģiju
AMD Instinct MI400 sērija izvēlas citu ceļu, vienlaikus tiecoties pēc tā paša sistēmas līmeņa mērķa. MI455X apvieno mikroshēmas, HBM4, uzlabotu iepakojumu un Infinity Fabric. AMD norāda līdz 432 GB HBM4 un līdz 23,3 TB/s maksimālās teorētiskās atmiņas joslas platuma uz katru MI455X GPU. Helios plaukta mēroga atsauces dizains apvieno 72 MI455X GPU un ir veidots, izmantojot atvērtos infrastruktūras standartus. AMD apgalvo, ka Helios bāzes lielapjoma izvietošana ir paredzēta 2026. gada otrajā pusē. Skatiet AMD Instinct MI400 sērijas lapu .
Šī pieeja ir pievilcīga, ja atmiņas ietilpība, mikroshēmu modularitāte, ROCm un atvērtā plaukta vai starpsavienojumu standarti ir stratēģiskas prioritātes. Vairāk lokālas HBM var samazināt modeļa sadalīšanas spiedienu un var palīdzēt secināt darba slodzes ar lielām KV kešatmiņām vai darba slodzēm, kas citādi izplatītu datus starp paātrinātājiem.
Kompromiss ir programmatūras validācija. Platformai var būt spēcīgas silīcija specifikācijas, taču tai joprojām var būt nepieciešams inženiertehnisks darbs, ja kritisks ietvars, kodols, kolektīvās komunikācijas modelis vai pielāgots operators ir labāk optimizēts citur. Organizācijām, kas apsver AMD izmantošanu, vajadzētu salīdzināt savas apmācības un secinājumu plūsmas, izmantojot ROCm, nevis pieņemt, ka pārnesamība automātiski nozīmē vienādu veiktspēju.
3. variants: specializētas mākslīgā intelekta ASIC shēmas, kad darba slodzes atbilstība ir svarīgāka par vispārīgumu
Google TPU7x, kas pazīstams arī kā Ironwood, parāda konkrētai jomai paredzēta paātrinātāja priekšrocības. Google Cloud norāda 192 GB HBM uz vienu mikroshēmu, aptuveni 7,38 TB/s HBM joslas platumu, 1,2 TB/s divvirzienu starpčipu savienojumu joslas platumu un lielas podu konfigurācijas. Arhitektūra ir veidota, izmantojot tenzoru un retu skaitļošanu, nevis cenšoties apkalpot visus iespējamos paātrinātāja lietošanas gadījumus. Tehniskā informācija ir pieejama Google Cloud TPU7x dokumentācijā .
Specializēts paātrinātājs var būt laba izvēle, ja mērķa modeļi precīzi atbilst tā kompilatoram, skaitliskajiem formātiem, atmiņas hierarhijai un atbalstītajiem ietvariem. Mākoņpakalpojumu piegāde var arī atvieglot lielu daļu no infrastruktūras slodzes, kas saistīta ar liela mākslīgā intelekta klastera īpašumtiesībām.
Kompromiss ir pārnesamība un darba slodzes plašums. Ja organizācija paļaujas uz zema līmeņa CUDA specifisku kodu, neparastiem kodoliem, nišas zinātniskām bibliotēkām vai lietojumprogrammām ārpus akseleratora optimālās zonas, migrācijas izmaksas var pārsniegt aparatūras efektivitāti. Tāpēc pareizais salīdzinājums ir laiks līdz rezultāta sasniegšanai un izmaksas līdz rezultātam faktiskajai programmatūras pakotnei.
Uzlabots iepakojums kļūst tikpat svarīgs kā tranzistora mērogošana
Vadošie mākslīgā intelekta procesori ir pārāk sarežģīti, lai iepakojumu uzskatītu par pasīvu pēdējo soli. TSMC CoWoS platforma integrē loģiku un HBM, izmantojot lielus starpniekus, savukārt tās SoIC tehnoloģija atbalsta 3D mikroshēmu sakraušanu ar augsta blīvuma kristāla-mikroshēmas savienojumiem. TSMC norāda, ka tās 3 nm SoIC sakraušana sāka ražot sērijveidā 2025. gadā. Tās CoWoS-L tehnoloģija ir arī mērogojama, pārsniedzot tradicionālos tīkliņa izmēra ierobežojumus lieliem mākslīgā intelekta un HPC iepakojumiem. Skatiet TSMC oficiālās CoWoS un SoIC tehnoloģiju lapas.
Intel Foundry tiecas pēc līdzīga mērķa ar EMIB un Foveros. EMIB izmanto iegultus silīcija tiltiņus, lai savienotu mikroshēmas augstā blīvumā, neprasot pilnu silīcija starpliku visā korpusā. Foveros pievieno vertikālu sakraušanu, savukārt Foveros Direct izmanto vara-vara hibrīdsavienojumu ļoti smalkiem mikroshēmu savienojumiem. Intel apraksta šīs tehnoloģijas savā uzlabotajā iepakojuma lapā .
Inženiertehniskā izvēle nav vienkārši “2,5D pret 3D”. Projektētājiem ir jālīdzsvaro savienojumu blīvums, korpusa izmērs, termiskā uzvedība, zināma laba mikroshēmas stratēģija, ražība, montāžas sarežģītība un izmaksas. 3D steks var saīsināt saites un uzlabot joslas platuma blīvumu, bet karsto skaitļošanas mikroshēmu vertikāla sakraušana var apgrūtināt siltuma noņemšanu. 2,5D arhitektūru var būt vieglāk atdzesēt un testēt, taču tai var būt nepieciešams lielāks izmērs un garāki savienojumi.
Vadošie procesu mezgli joprojām ir svarīgi, taču īpašu iemeslu dēļ
Tranzistoru mērogošana joprojām ir svarīga, jo mākslīgā intelekta un HPC sistēmām ir ierobežota jauda. TSMC apgalvo, ka tā N2 tehnoloģija sāka ražot masveidā 2025. gada ceturtajā ceturksnī, izmantojot nanoslokšņu tranzistorus, un ka N2P un A16 ražošana masveidā ir paredzēta 2026. gada otrajā pusē. A16 pievieno barošanas avotu no aizmugures puses, kas attālina barošanas maršrutēšanu no priekšējās puses signāla slāņiem un ir paredzēta prasīgām HPC konstrukcijām ar blīviem barošanas tīkliem. Skatiet TSMC A16 tehnoloģijas lapu .
Intel 18A mezgls līdzīgi apvieno vārtu visapkārt esošu tranzistora arhitektūru ar zīmolu RibbonFET un barošanas bloku no aizmugures puses ar zīmolu PowerVia. Intel 2026. gada jūnijā paziņoja, ka 18A ražošana ir uzsākta 2025. gadā un ka 18A-P ražošana ir uzsākta riska grupā. Skatiet Intel Foundry 2026. gada procesa atjauninājumu .
Kompromiss ir brieduma pakāpe pretstatā maksimālai efektivitātei. Jauns mezgls var uzlabot veiktspēju, blīvumu vai jaudu, taču nobrieduši mezgli bieži vien piedāvā labāku ražību, zemākas izmaksas un stabilāku dizaina ekosistēmu. Čipletu arhitektūras padara šo izvēli mazāk bināru: skaitļošanas flīzes var izmantot jaunāko mezglu, kamēr I/O, kešatmiņa, analogās vai saskarnes mikroshēmas paliek uz vecākiem, lētākiem procesiem.
Atvērtie mikroshēmu standarti var samazināt pieķeršanos, taču sadarbspēja nav automātiska.
UCIe ir izstrādāts, lai standartizētu ātrdarbīgu mikroshēmu savstarpējo saziņu. UCIe 3.0 atbalsta 48 GT/s un 64 GT/s datu pārraides ātrumu, divkāršojot UCIe 2.0 maksimālo datu pārraides ātrumu, vienlaikus saglabājot atpakaļsaderību. Tas arī paplašina pārvaldāmību un enerģijas taupīšanas funkcijas. Specifikāciju pārskats ir pieejams UCIe konsorcijā .
Pusvadītāju dizaineriem UCIe var atvieglot mikroshēmu apvienošanu no dažādām komandām, procesiem vai galu galā piegādātājiem. Tomēr sistēmu pircējiem atvērts mikroshēmu no mikroshēmas līdz mikroshēmai standarts ne vienmēr nozīmē savstarpēji aizvietojamus paātrinātāju moduļus. Joprojām ir jāsaskaņo korpuss, barošana, programmaparatūra, atmiņas saskarnes, termiskā konstrukcija, drošība, validācija un programmatūra. Tāpēc UCIe jāuzskata par svarīgu modulāras konstrukcijas pamatelementu, nevis par garantiju, ka silīcijs būs gatavs lietošanai un darbosies.
Ko jums vajadzētu izvēlēties dažādām mākslīgā intelekta un superdatoru vajadzībām?
Primārā vajadzība
Kam piešķirt prioritāti
Iespējamais arhitektūras virziens
Galvenais kompromiss, kas jāpārbauda
Apmācība, izmantojot robežmodeļa principus
Palielināma joslas platums, HBM ietilpība, kolektīvā veiktspēja, programmatūras briedums
Integrētas plauktu mēroga GPU sistēmas
Enerģijas, dzesēšanas, tīkla un kopējās klastera izmaksas
Liela apjoma LLM secinājumi
Atmiņas ietilpība, atmiņas joslas platums, zemas precizitātes caurlaidspēja, izmaksas par vienu marķieri
GPU plaukti vai specializēti mākslīgā intelekta paātrinātāji
Latentums mērķa vienlaicīgumā un modeļa atbilstība
Zinātniskā HPC
FP64 veiktspēja, atmiņas joslas platums, MPI/komunikācijas steks, validētas bibliotēkas
Uz HPC orientēti GPU, kā arī augstas veiktspējas centrālie procesori un tīkla struktūra
Lietojumprogrammu pārnesamība un skaitliskās prasības
Mākonī bāzēts mākslīgais intelekts ar standartizētiem modeļiem
Nodrošināta caurlaidspēja, pārvaldīta mērogošana, kompilatoru atbalsts, darbības vienkāršība
Heterogēnas mikroshēmas ar uzlabotu 2,5D/3D iepakojumu
NRE izmaksas, validācijas laiks, iepakošanas ietilpība un ražība
Kā novērtēt nākamās paaudzes pusvadītāju platformu, nemaldinot galveno specifikāciju rezultātus
Sāciet ar darba slodzi, nevis mikroshēmu. Izmēriet modeļa izmēru, aktīvo parametru skaitu, konteksta garumu, partijas lielumu, komunikācijas intensitāti, precizitātes prasības, kontrolpunktu darbību un paredzamo noslodzi. Pēc tam novērtējiet aparatūru, ņemot vērā šos ierobežojumus.
Ar skaitļošanas vajadzībām ierobežotām darba slodzēm: salīdziniet kodola ilgtspējīgo veiktspēju ar precizitāti, ko faktiski izmantosit, ne tikai ar maksimālajiem FP4 vai FP8 rādītājiem.
Atmiņai ierobežotām darba slodzēm: prioritizējiet efektīvu HBM joslas platumu, ietilpību, kešatmiņas darbību un datu pārvietošanas izmaksas.
Izkliedētai apmācībai: izmēriet kolektīvās darbības, piemēram, all-reduce un all-to-all, paredzētajā mezglu skaitā.
Secināšanai: testa marķieri sekundē, laiks līdz pirmajam marķierim, starpmarķieru latentums, vienlaicība un enerģija katram pieprasījumam, izmantojot reālistiskus konteksta garumus.
HPC gadījumā: pārbaudiet FP64, vektoru veiktspēju, atmiņas darbību, kompilatora kvalitāti, MPI mērogošanu un precīzās zinātniskās bibliotēkas, kas tiek izmantotas.
Telpu plānošanai: iekļaujiet plauktu jaudu, dzesēšanas tehnoloģiju, grīdas noslodzi, tīkla optiku, apkalpojamību un rezerves jaudu.
Tas ir īpaši svarīgi 2026. gadā, jo piegādātāju arhitektūras atšķiras. NVIDIA Rubin platforma uzsver cieši integrētu plauktu mēroga skaitļošanu un tīklošanu; AMD MI400 saime apvieno lielu HBM4 ietilpību ar mikroshēmām un atvērtas infrastruktūras stratēģiju; Google TPU7x mērķē uz tenzorcentriskām darba slodzēm, izmantojot mākonī nodrošinātu ASIC; TSMC, Intel, atmiņas piegādātāji un standartu institūcijas vienlaikus maina fiziskos pamatelementus zem tiem visiem.
Praktiskais secinājums: optimizējiet visu datu ceļu
Nākamās paaudzes pusvadītāji darbinās mākslīgo intelektu un superdatorus nevis tāpēc, ka katrā etalonā uzvar viena ierīce, bet gan tāpēc, ka nozare mācās efektīvāk pārvietot datus no atmiņas uz centrālo procesoru (CPU), no centrālā procesora (CPU) uz paātrinātāju, starp paātrinātājiem un starp sakrautām mikroshēmām un HBM. HBM4, mikroshēmas, 2,5D un 3D iepakojums, barošanas padeve no aizmugures puses, ātras mērogošanas saites un atvērtie mikroshēmu starp mikroshēmām standarti ir atbildes uz vienu un to pašu ierobežojumu: aritmētika ir noderīga tikai tad, ja dati pienāk pietiekami ātri un pieejamā jaudas budžeta ietvaros.
Organizācijām, kas iegādājas infrastruktūru šodien, drošākais ieteikums ir pielāgoties darba slodzei. Izvēlieties integrētu GPU platformu, ja prioritāte ir ekosistēmas briedums un ātra mērogošana. Apsveriet atvērtu GPU platformu, ja stratēģiski svarīga ir atmiņas ietilpība, infrastruktūras elastība un programmatūras pārnesamība. Izmantojiet specializētu ASIC, ja darba slodze ir skaidri tai pielāgota un ir pieņemama atkarība no mākoņa vai platformas. Pielāgota silīcija gadījumā ieguldiet mikroshēmās un uzlabotā iepakojumā, ja veiktspējas un produkta apjoma pieaugums attaisno papildu projektēšanas un validācijas sarežģītību.
Vissvarīgākais ir veikt pilnīgu sistēmu salīdzinošo novērtēšanu ražošanas apstākļos. Pusvadītājs, kas specifikācijas lapā izskatās visātrāk, var nebūt tas, kas jūsu darba slodzei nodrošina viszemākās izmaksas, īsāko rezultāta sasniegšanas laiku vai labāko veiktspēju uz vatu.