Kezdőlap
» New Trends
»
Következő generációs félvezetők mesterséges intelligenciához és szuperszámítógépekhez: Ami a flopokon túl is számít
Következő generációs félvezetők mesterséges intelligenciához és szuperszámítógépekhez: Ami a flopokon túl is számít
2026-ban a mesterséges intelligencia és a szuperszámítógépes hardverek terén a legfontosabb változás nem egyetlen új tranzisztorcsomópont vagy gyorsító. Hanem az az elmozdulás, hogy a teljes számítási rendszert egyetlen félvezető platformként tervezzük meg: a logikát, a nagy sávszélességű memóriát, a chipeket, a tokozást, a skálázható kapcsolatokat, a hálózati szövetet, a tápellátást, a hűtést és a szoftvereket mind együtt kell optimalizálni. Az NVIDIA szerint a Vera Rubin platformja már teljes mértékben gyártás alatt áll, az AMD 2026 júliusában indította el az Instinct MI400 családot, a Micron tömegesen szállítja a HBM4-et, a TSMC pedig szerint az N2 2025 végén lépett be a nagy volumenű gyártásba, míg az N2P és az A16 tömeggyártása 2026 második felére várható. Ezek a fejlemények egyértelművé tesznek egy tanulságot: a következő generációs félvezetők kiválasztása most már egy rendszerarchitektúrát is jelent, nem csak egy chipet.
Ez azért fontos, mert a „legjobb” félvezető nagymértékben függ a munkaterheléstől. Egy határokon átnyúló modellű betanító klaszter, egy nemzeti szuperszámítógépes központ, egy felhőalapú következtetési szolgáltatás és egy vállalati mesterséges intelligencia telepítés mind eltérő kompromisszumokat részesíthet előnyben. A csúcs FLOPS-ok önmagában rossz beszerzési szabály. A memóriakapacitás, a memória-sávszélesség, az összekapcsolási topológia, a támogatott numerikus formátumok, a szoftver érettsége, a hűtési igények, a rendelkezésre állás és a teljes rendszerköltség ugyanilyen fontos lehet.
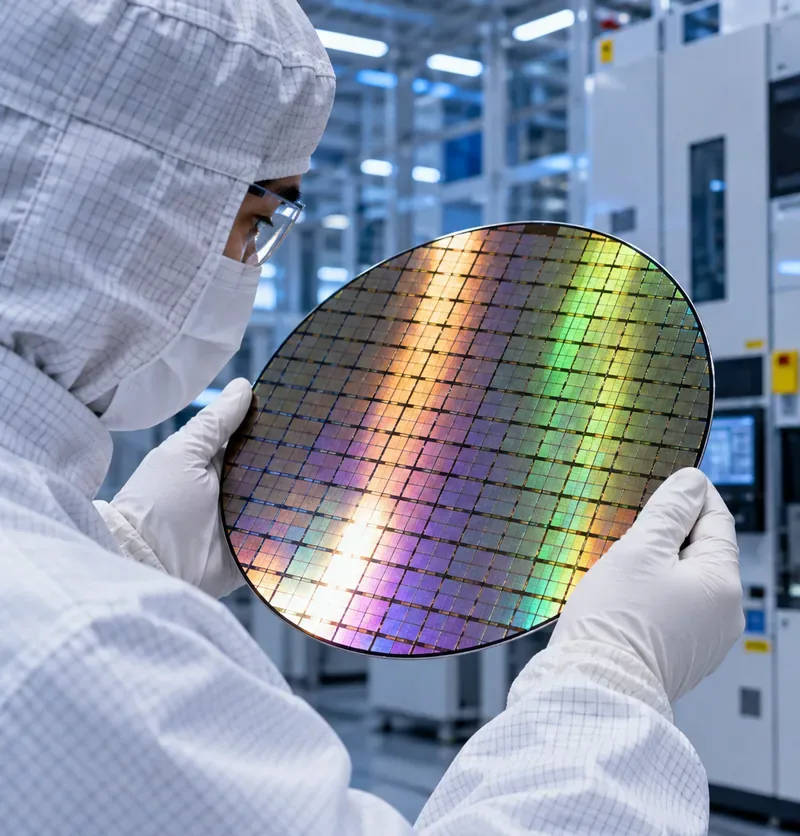
Egy tisztatéri technikus egy mintázott szilíciumlapkát vizsgál, amely a mesterséges intelligenciában és a nagy teljesítményű számítástechnikában használt fejlett processzorok precíziós gyártását illusztrálja.
A 2026-os váltás: a memória és az összekapcsolás mostantól első osztályú tervezési korlátok
A modern mesterséges intelligencia gyorsítók gyorsabban tudnak aritmetikai műveleteket végezni, mint amennyi adatot bármikor is be tudnak juttatni hozzájuk. Ez a memória-sávszélességet és az adatmozgatást a valós teljesítmény központi elemévé teszi. A Micron kijelenti, hogy a 36 GB-os, 12 bites HBM4 terméke nagy volumenű gyártás alatt áll, és több mint 2,8 TB/s sávszélességet biztosít veremenként egy 2048 bites interfész használatával, több mint 20%-kal jobb energiahatékonysággal, mint a hasonló HBM3E termék. Lásd a Micron HBM4 termékinformációit és a 2026. márciusi HBM4 gyártási bejelentését .
A kompromisszum az, hogy a HBM drága és tokozásigényes. Több verem növeli a kapacitást és a sávszélességet, de egyben növeli a csomag méretét is, bonyolítja az útvonalválasztást és a tápellátást, növeli a hősűrűséget, és nagyobb nyomást gyakorol a tokozási hozamra. Memóriához kötött következtetések, nagyméretű ajánlási modellek, hosszú kontextusú LLM-kiszolgálás és magas adat-újrafelhasználással járó tudományos munkaterhelések esetén érdemes lehet több HBM-ért fizetni. Kisebb, alacsony memóriaigényű modellek esetén ez a prémium kárba vész.
1. lehetőség: integrált GPU rackrendszerek a maximális AI-skálázhatóság érdekében
Az NVIDIA Vera Rubin NVL72 processzora a rendszer-központú megközelítést szemlélteti. Az NVIDIA 72 Rubin GPU-ból és 36 Vera CPU-ból álló konfigurációt tesz közzé, 20,7 TB HBM4 tárhellyel a rackben. Egyetlen Rubin GPU 288 GB HBM4 tárhellyel van feltüntetve, míg az NVLink 6 GPU-nként akár 3,6 TB/s skálázható sávszélességet biztosít. A platformot előképzésre, utóképzésre, tesztidejű skálázásra és nagyméretű ágensi következtetésre tervezték. Az aktuális specifikációk az NVIDIA Vera Rubin NVL72 oldalán érhetők el .
Az előny az integráció. A számítási teljesítmény, a CPU-GPU koherencia, a skálázható hálózat, a hálózatépítés, a rendszerfelügyelet és a szoftverek együttesen kerülnek fejlesztésre. Ez csökkentheti egy nagy klaszter függetlenül optimalizált komponensekből történő összeállításának kockázatát. Különösen vonzó, ha a telepítési idő és az érett GPU szoftverökoszisztéma fontosabb, mint az architektúra nyitottsága.
A kompromisszum a szorosan integrált platform iránti elkötelezettség. A nagyméretű, rack méretű rendszerek jelentős létesítménytervezést is igényelnek, beleértve a folyadékhűtést, az elektromos elosztást és a hálózattervezést. A vásárlóknak nem csak a gyorsító specifikációit, hanem a rackenkénti és megawattonkénti leszállított alkalmazás-átviteli sebességet is össze kell hasonlítaniuk. A gyártó által közzétett csúcsteljesítmény-számok elméleti vagy munkaterhelés-specifikusak, és validálni kell őket a tényleges modellel, a kötegmérettel, a sorozathosszal, a numerikus pontossággal és a termelésben futó kommunikációs mintával.
Az AMD Instinct MI400 sorozata más utat választ, miközben ugyanazt a rendszerszintű célt követi. Az MI455X chipeket, HBM4-et, fejlett tokozást és Infinity Fabric technológiát ötvöz. Az AMD akár 432 GB HBM4 memóriát és akár 23,3 TB/s elméleti csúcs memória-sávszélességet is feltüntet MI455X GPU-nként. A Helios rack méretű referenciadizájn 72 MI455X GPU-t kombinál, és nyílt infrastruktúra-szabványok köré épül. Az AMD szerint a Helios alapú mennyiségi telepítések várhatóan 2026 második felében kerülnek bevezetésre. Lásd az AMD Instinct MI400 sorozat oldalát .
Ez a megközelítés akkor vonzó, ha a memóriakapacitás, a chiplet modularitása, a ROCm, valamint a nyílt rack vagy összekapcsolási szabványok stratégiai prioritások. A több lokális HBM csökkentheti a modell particionálási nyomását, és segíthet a nagy KV gyorsítótárakat tartalmazó munkaterhelések vagy az olyan munkaterhelések következtetésében, amelyek egyébként az adatokat gyorsítók között szórnák ki.
A kompromisszum a szoftvervalidáció. Egy platform rendelkezhet erős szilíciumspecifikációkkal, de továbbra is mérnöki munkát igényelhet, ha egy kritikus keretrendszer, kernel, kollektív kommunikációs minta vagy egyéni operátor máshol jobban optimalizált. Az AMD-t fontolgató szervezeteknek a saját betanítási és következtetési folyamataikat ROCm alatt kellene összehasonlítaniuk, ahelyett, hogy feltételeznék, hogy a hordozhatóság automatikusan azonos teljesítményt jelent.
3. lehetőség: specializált mesterséges intelligencia ASIC-ek, amikor a munkaterhelés illeszkedése fontosabb, mint az általánosság
A Google TPU7x-e, más néven Ironwood, egy domain-specifikus gyorsító előnyeit mutatja be. A Google Cloud chipenként 192 GB HBM-et, körülbelül 7,38 TB/s HBM sávszélességet, 1,2 TB/s kétirányú chipek közötti összekapcsolási sávszélességet és nagyméretű pod konfigurációkat sorol fel. Az architektúra a tenzor és a ritka számítás köré épül, ahelyett, hogy minden lehetséges gyorsítóhasználati esetet kiszolgálna. A technikai részletek a Google Cloud TPU7x dokumentációjában találhatók .
Egy specializált gyorsítóprogram jó választás lehet, ha a célmodellek tisztán illeszkednek a fordítóprogramhoz, a numerikus formátumokhoz, a memóriahierarchiához és a támogatott keretrendszerekhez. A felhőalapú megvalósítás emellett jelentősen csökkentheti a nagyméretű MI-klaszterek tulajdonlásával járó létesítményi terheket.
A kompromisszum a hordozhatóság és a munkaterhelés szélessége. Ha egy szervezet alacsony szintű CUDA-specifikus kódra, szokatlan kernelekre, niche tudományos könyvtárakra vagy a gyorsító optimális pontján kívül eső alkalmazásokra támaszkodik, az átállás költsége meghaladhatja a hardverhatékonyságot. A helyes összehasonlítás ezért a tényleges szoftververem teljes körű eredmény-elérési ideje és eredményességi költsége.
A fejlett tokozás ugyanolyan fontossá válik, mint a tranzisztorok skálázása
A vezető mesterséges intelligencia processzorok túl összetettek ahhoz, hogy a tokozást passzív utolsó lépésként kezeljük. A TSMC CoWoS platformja nagy interposerek segítségével integrálja a logikát és a HBM-et, míg SoIC technológiája támogatja a 3D chip-egymásra építést nagy sűrűségű chip-chip csatlakozásokkal. A TSMC kijelentette, hogy 3 nm-es SoIC-egymásra építése 2025-ben lépett be a tömeggyártásba. CoWoS-L technológiája a hagyományos szálkereszt-méretkorlátokon is túllépte a nagy mesterséges intelligencia és HPC tokozások határait. Lásd a TSMC hivatalos CoWoS és SoIC technológiai oldalait.
Az Intel Foundry hasonló célt követ az EMIB és a Foveros esetében. Az EMIB beágyazott szilíciumhidakat használ a lapkák nagy sűrűségű összekapcsolására anélkül, hogy teljes szilícium közbeiktatóra lenne szükség a teljes tokozásban. A Foveros függőleges egymásra rakást biztosít, míg a Foveros Direct réz-réz hibrid kötést használ a nagyon finom lapka-lapka csatlakozásokhoz. Az Intel ezeket a technológiákat a fejlett csomagolási oldalán ismerteti .
A mérnöki választás nem egyszerűen a „2,5D kontra 3D” kérdésről szól. A tervezőknek egyensúlyt kell teremteniük az összeköttetések sűrűségének, a tokozás méretének, a hőviselkedésnek, az ismert „jó” lapkastratégiának, a hozamnak, az összeszerelés bonyolultságának és a költségeknek a között. A 3D-s stack lerövidítheti az összeköttetéseket és javíthatja a sávszélesség-sűrűséget, de a forró számítási lapkák függőleges egymásra rakása megnehezítheti a hőelvezetést. Egy 2,5D-s architektúra könnyebben hűthető és tesztelhető, de nagyobb helyigénnyel és hosszabb összeköttetésekkel járhat.
A legmodernebb folyamatcsomópontok továbbra is fontosak – de bizonyos okokból
A tranzisztorok skálázása továbbra is fontos, mivel a mesterséges intelligencia és a HPC rendszerek teljesítménykorlátozottak. A TSMC szerint az N2 technológiájuk 2025 negyedik negyedévében lépett be a tömeggyártásba nanosíkos tranzisztorok használatával, az N2P és az A16 tömeggyártása pedig 2026 második felében várható. Az A16 hátoldali tápellátást is tartalmaz, amely elmozdítja a tápellátás irányítását az előoldali jelrétegektől, és a sűrű energiahálózatokkal rendelkező, igényes HPC-tervek számára készült. Lásd a TSMC A16 technológiai oldalát .
Az Intel 18A csomópontja hasonlóképpen ötvözi a RibbonFET márkájú, minden oldalról kapuzó tranzisztor-architektúrát a PowerVia márkájú, hátoldali tápellátással. Az Intel 2026 júniusában közölte, hogy a 18A gyártása 2025-ben kezdődött, a 18A-P pedig kockázatos gyártásba került. Lásd az Intel Foundry 2026-os folyamatfrissítését .
A kompromisszum az érettség kontra a maximális hatékonyság. Egy új csomópont javíthatja a teljesítményt, a sűrűséget vagy az energiafogyasztást, de az érett csomópontok gyakran jobb hozamot, alacsonyabb költségeket és egy jobban kiépített tervezési ökoszisztémát kínálnak. A chiplet architektúrák kevésbé binárissá teszik ezt a választást: a számítási csempék használhatják a legújabb csomópontot, míg az I/O, a gyorsítótár, az analóg vagy az interfészchipek a régebbi, olcsóbb folyamatokon maradnak.
A nyílt chiplet szabványok csökkenthetik a függőséget, de az interoperabilitás nem automatikus.
Az UCIe célja a chipek közötti nagysebességű, lapkaközi kommunikáció szabványosítása. Az UCIe 3.0 48 GT/s és 64 GT/s adatsebességet támogat, amivel megduplázza az UCIe 2.0 maximális adatsebességét, miközben megőrzi a visszafelé kompatibilitást. Emellett kiterjeszti a kezelhetőséget és az energiatakarékos funkciókat. A specifikáció áttekintése az UCIe Konzorciumtól érhető el .
A félvezető-tervezők számára az UCIe megkönnyítheti a különböző csapatoktól, folyamatoktól vagy végül a beszállítóktól származó chipletek kombinálását. A rendszervásárlók számára azonban egy nyílt, „chiptől-chipig” szabvány nem jelent azonnal cserélhető gyorsítómodulokat. A tokozásnak, a tápellátásnak, a firmware-nek, a memóriainterfészeknek, a hőtervezésnek, a biztonságnak, a validációnak és a szoftvernek még össze kell hangolniuk. Az UCIe-t ezért a moduláris tervezés fontos építőköveként kell tekinteni, nem pedig a plug-and-play szilikon garanciájaként.
Mit érdemes választani a különböző mesterséges intelligencia és szuperszámítástechnikai igényekhez?
HPC-központú GPU-k, nagy teljesítményű CPU-k és hálózati hálózat
Alkalmazások hordozhatósága és numerikus követelmények
Felhőalapú mesterséges intelligencia szabványosított modellekkel
Biztosított átviteli sebesség, felügyelt skálázás, fordítóprogram támogatás, működési egyszerűség
Felhőalapú GPU vagy felhőalapú AI ASIC
Hordozhatóság és hosszú távú platformfüggőség
Egyedi szilícium vagy szuverén infrastruktúra
Chiplet rugalmasság, öntödei hozzáférés, csomagolási ökoszisztéma, nyílt összeköttetések
Heterogén chipletek fejlett 2.5D/3D tokozással
NRE költség, validálási idő, csomagolási kapacitás és hozam
Hogyan értékeljünk egy következő generációs félvezető platformot anélkül, hogy félrevezetnének a főbb specifikációk?
Kezdd a munkaterheléssel, ne a chippel. Mérd meg a modell méretét, az aktív paraméterek számát, a kontextus hosszát, a köteg méretét, a kommunikáció intenzitását, a pontossági követelményeket, az ellenőrzőpont-viselkedést és a várható kihasználtságot. Ezután értékeld a hardvert ezen korlátok fényében.
Számítási igényekhez kötött munkaterhelések esetén: a fenntartható kernel teljesítményét a ténylegesen használt pontossággal hasonlítsa össze, ne csak az FP4 vagy FP8 csúcsértékeit.
Memóriához kötött munkaterhelések esetén: rangsorolja a hatékony HBM sávszélességet, kapacitást, gyorsítótár-viselkedést és adatmozgatási terhelést.
Elosztott betanítás esetén: mérje meg a kollektív műveleteket, például az all-reduce és az all-to-all műveleteket a kívánt csomópontszámon.
Következtetéshez: teszt tokenek másodpercenként, az első tokenhez szükséges idő, tokenek közötti késleltetés, párhuzamosság és kérésenkénti energia realisztikus kontextushosszak használatával.
HPC esetén: ellenőrizze az FP64-et, a vektorteljesítményt, a memória viselkedését, a fordítóprogram minőségét, az MPI skálázást és a használatban lévő pontos tudományos könyvtárakat.
Létesítménytervezéshez: vegye figyelembe a rackek tápellátását, a hűtési technológiát, a padlóterhelést, a hálózati optikát, a szervizelhetőséget és a tartalék kapacitást.
Ez különösen fontos 2026-ban, mivel a szállítói architektúrák eltérnek egymástól. Az NVIDIA Rubin platformja a szorosan integrált, rack méretű számítástechnikát és hálózatépítést hangsúlyozza; az AMD MI400 családja a nagy HBM4 kapacitást chipekkel és nyílt infrastruktúra stratégiával ötvözi; a Google TPU7x a tenzorközpontú munkaterheléseket célozza meg egy felhőalapú ASIC-en keresztül; a TSMC, az Intel, a memóriagyártók és a szabványügyi testületek egyidejűleg változtatják meg mindegyikük mögötti fizikai építőelemeket.
A gyakorlati következtetés: optimalizálja a teljes adatfolyamot
A félvezetők következő generációja nem azért fogja működtetni a mesterséges intelligenciát és a szuperszámítástechnikát, mert minden benchmarkban egy eszköz nyer, hanem azért, mert az iparág tanulja, hogyan mozgassa hatékonyabban az adatokat a tárolóból a CPU-ba, a CPU-ból a gyorsítóba, a gyorsítók között, valamint a rétegelt lapkák és a HBM között. A HBM4, a chipletek, a 2,5D és 3D tokozás, a hátoldali tápellátás, a gyors skálázható kapcsolatok és a nyílt lapka-lapka szabványok mind ugyanarra a korlátra adott válaszok: a számtani műveletek csak akkor hasznosak, ha az adatok elég gyorsan és a rendelkezésre álló energiaköltségvetésen belül érkeznek meg.
A ma infrastruktúrát vásárló szervezetek számára a legbiztonságosabb ajánlás a munkaterhelés-specifikus megközelítés. Válasszon integrált GPU platformot, ha az ökoszisztéma érettsége és a gyors skálázhatóság az elsődleges. Fontolja meg a nyílt GPU platform használatát, ha a memóriakapacitás, az infrastruktúra rugalmassága és a szoftverek hordozhatósága stratégiai fontosságú. Használjon specializált ASIC-et, ha a munkaterhelés egyértelműen hozzá van rendelve, és a felhő- vagy platformfüggőség elfogadható. Egyedi szilikonok esetén fektessen be chipekbe és fejlett tokozásokba, ha a teljesítmény és a termékmennyiség-növekedés indokolja a további tervezési és validációs bonyolultságot.
A legfontosabb, hogy a teljes rendszereket éles körülmények között kell összehasonlítani. A specifikációs lapon a leggyorsabbnak tűnő félvezető nem feltétlenül az, amelyik a legalacsonyabb költséget, a legrövidebb eredmény-elérési időt vagy a legjobb wattonkénti teljesítményt nyújtja a munkaterheléshez.