Početna
» Vijesti
»
Prekid rada Salesforce Herokua: Što se događa s implementiranim aplikacijama?
Prekid rada Salesforce Herokua: Što se događa s implementiranim aplikacijama?
Prekid rada Herokua ne znači uvijek da je svaka implementirana aplikacija potpuno izvan mreže. Utjecaj ovisi o tome koji dio platforme ne radi: usmjeravanje, dyno umrežavanje, podatkovne usluge, alati za implementaciju, DNS, bilježenje ili integracija poput Heroku Connecta. Za operatere je najbrži način reagiranja identificiranje pogođenog sloja prije ponovnog pokretanja ili promjene ispravne aplikacije.
Herokuova vlastita povijest incidenata pokazuje zašto je ta razlika važna. Dana 10. lipnja 2025., Heroku je izvijestio o ozbiljnom poremećaju platforme koji je mnogim korisnicima stvorio do 24 sata zastoja. U Herokuovom sažetku nakon incidenta navodi se da je nenamjerno ažuriranje operativnog sustava ponovno pokrenulo mrežne usluge na produkcijskim hostovima, dok je greška u postavkama usmjeravanja spriječila ponovnu primjenu ispravnih mrežnih ruta. Isti incident utjecao je i na interne alate i Heroku Status stranicu, komplicirajući dijagnozu i komunikaciju. Heroku je izjavio da incident nije bio sigurnosni događaj i da nisu izgubljeni nikakvi podaci o korisnicima. Pogledajte službeni sažetak prekida od 10. lipnja .
Nedavno, 8. svibnja 2026., Heroku je prijavio prekid usluge kod uzvodnog pružatelja usluga koji je utjecao na podskup korisnika u regiji Sjeverne Amerike. Prijavljeni simptomi uključivali su povremenu povezivost, povećanu latenciju baze podataka i smanjene performanse koje su uključivale dodatke trećih strana. Heroku je kasnije izjavio da je migrirao pogođene resurse u novu zonu dostupnosti te vratio web aplikacije i baze podataka. Povijest incidenata dostupna je na službenoj stranici Heroku incidenata .
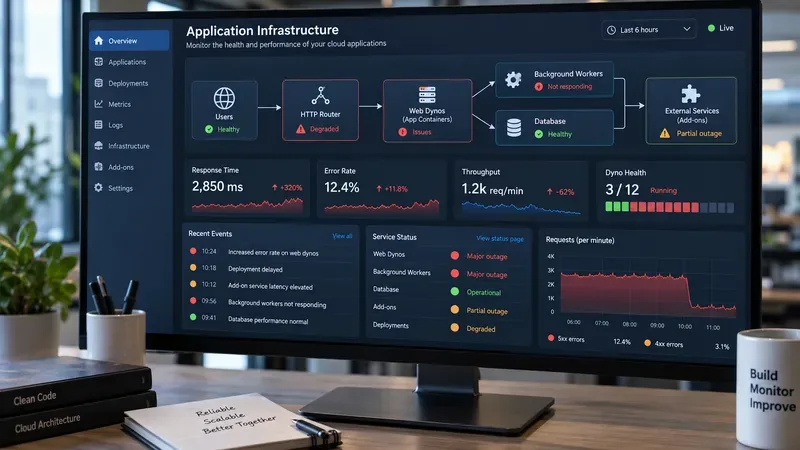
Prikaz praćenja ilustrira kako incident na platformi može različito utjecati na usmjeravanje, web dyno uređaje, radnike, implementacije i dodatke, dok baza podataka ostaje zdrava.
Matrica brzog utjecaja: što se može pokvariti tijekom prekida rada Herokua?
1. Pokretanje aplikacija može propasti čak i ako se vaš kod nije promijenio
Sve Heroku aplikacije rade u upravljanim kontejnerima koji se nazivaju dynos. Web dynos primaju HTTP promet, radni dynos obično obrađuju pozadinske poslove, a jednokratni dynos obavljaju administrativne zadatke. Herokuova dokumentacija o dyno sustavu objašnjava da je upravitelj dyno sustava odgovoran za održavanje tih kontejnera u radu.
Problem s platformom stoga može učiniti prethodno ispravno izdanje nedostupnim bez ikakve implementacije aplikacije. Ako mrežni sustav hosta, upravitelj dyno signala ili temeljna infrastruktura postanu nedostupni, aplikacija može propasti iako su njezin kod i konfiguracija nepromijenjeni.
Tijekom prekida rada 10. lipnja 2025., Heroku je opisao mrežni kvar koji je prekinuo izlaznu vezu za dyno uređaje na pogođenim hostovima. Ovo je važna operativna lekcija: pogreška koja izgleda kao kvar ovisnosti aplikacije može nastati ispod sloja aplikacije.
2. Kvarovi usmjeravanja mogu uzrokovati greške 503, isteke vremena ili povremene uspjehe
Herokuovi HTTP usmjerivači primaju dolazni promet i prosljeđuju zahtjeve web dyno uređajima. Službena dokumentacija usmjeravanja opisuje ovaj put od uravnoteživača opterećenja preko usmjerivača do aplikacijskih dyno uređaja.
Ako je samo dio te putanje oštećen, korisnici mogu prijaviti da stranica „ponekad radi“. Jedan zahtjev može doći do ispravnog dinamometra, dok drugi ne uspije. Zato su višestruke provjere s različitih lokacija informativnije od jednog osvježavanja preglednika.
Herokuova referenca kodova pogrešaka korisna je kada su zapisnici dostupni. H99 i R99 su posebno dokumentirani kao pogreške platforme. Drugi kodovi mogu ukazivati na istek vremena zahtjeva, odbijene veze s pozadinom, karantenu dinamometra ili probleme na razini aplikacije, tako da se sam H-kod ne bi trebao automatski kriviti za incident na razini Herokua.
3. Prekid podatkovne usluge može ostaviti aplikaciju u radu, ali je funkcionalno neupotrebljiva.
Aplikacija može imati ispravne web dinamometre dok je baza podataka spora ili nedostupna. Stranice koje ne zahtijevaju podatke mogu se i dalje učitavati, dok prijava, naplata, pretraživanje, pisanje ili API pozivi ne uspijevaju. To stvara djelomični prekid rada koji krajnjim korisnicima može izgledati nedosljedno.
Incident od 8. svibnja 2026. koristan je primjer jer je Heroku prijavio povremenu povezanost i povećanu latenciju baze podataka za pogođene korisnike. Heroku je također savjetovao da pogođeni korisnici mogu razmotriti prebacivanje baze podataka u slučaju kvara kao ublažavanje tijekom incidenta.
Planirano održavanje također može stvoriti kraće prekide. Herokuova dokumentacija o održavanju Postgresa kaže da održavanje može ponovno pokrenuti povezanu aplikaciju i da korisnici mogu vidjeti pogreške ili kašnjenja nekoliko minuta. Planirano održavanje i neočekivani prekid rada platforme stoga treba razlikovati prije eskalacije.
4. Kvarovi Heroku Connecta mogu uzrokovati zastarjelost podataka Salesforcea bez prekida rada web aplikacije
Heroku Connect sinkronizira podatke između Salesforce organizacije i Heroku Postgresa. Prema dokumentaciji Heroku Connecta , usluga omogućuje sinkronizaciju podataka umjesto da djeluje kao samo web okruženje.
Ako je Connect prekinut, implementirana aplikacija može ostati dostupna dok se sinkronizirani Salesforce podaci prestanu ažurirati. Čitanja iz postojeće Postgres kopije mogu i dalje funkcionirati, ali korisnici mogu vidjeti zastarjele zapise ili odgođena pisanja ovisno o mapiranju i tijeku rada aplikacije.
U dokumentaciji o održavanju Herokua navodi se da tijekom održavanja Heroku Connecta sinkronizacija i konfiguracija nisu dostupne dok postojeći podaci u Postgresu ostaju dostupni; promjene u redu čekanja se zadržavaju, a sinkronizacija se nakon toga nastavlja. To ponašanje je dokumentirano u dokumentu Heroku Connect Maintenance Operations .
5. Problemi s implementacijom ne znače nužno da je proizvodnja u padu
Operateri bi trebali odvojiti „ne može se implementirati“ od „aplikacija nije dostupna“. Heroku kategorizira izgradnje, Git pushove, API-je za implementaciju, nadzornu ploču, CLI i povezane operacije upravljanja odvojeno od runtime i podatkovnih usluga. Incident s alatima može blokirati novo izdanje dok trenutno pokrenuto izdanje nastavlja opsluživati promet.
Ova razlika bila je vidljiva u Herokuovom incidentu 5. svibnja 2026., kada neki korisnici nisu mogli stvarati aplikacije za pregled, ali Heroku je izričito izvijestio da pokrenute aplikacije nisu bile pogođene.
Herokuova dokumentacija o fazi izdanja također napominje da ako zadatak u fazi izdanja ne uspije, novo izdanje se ne implementira, a trenutno izdanje ostaje nepromijenjeno. Tijekom incidenta izbjegavajte tumačenje zaglavljenog cjevovoda kao dokaza da je aktivna aplikacija zakazala.
6. DNS incidenti mogu utjecati na novokreirane aplikacije ili domene drugačije od postojećih
DNS je još jedan slučaj gdje opseg može biti uzak. U rujnu 2025., Heroku je prijavio problem s uzvodnim DNS-om koji je odgodio pružanje DNS zapisa za nove aplikacije i domene. Službeni incident napomenuo je da novokreirana imena hostova mogu ostati nedostupna dok se problem s pružateljem usluga ne riješi, dok se opseg incidenta razvio kako bi uključio neke DNS pogreške za postojeće aplikacije iz regije EU.
Za praktičnu dijagnozu, testirajte postojeći Heroku naziv hosta odvojeno od nedavno dodane prilagođene domene. Također provjerite DNS razlučivost neovisno o ispravnosti aplikacije.
Što biste prvo trebali provjeriti tijekom sumnje na prekid rada Herokua?
Prvo provjerite Salesforce Trust. Heroku kaže da je Salesforce Trust postao primarni komunikacijski kanal za incidente i održavanje 10. listopada 2025., a starija Heroku Status stranica zadržana je kao paralelna sigurnosna kopija tijekom tranzicije. Pogledajte dokumentaciju Heroku Statusa .
Odredite pogođenu kategoriju. Odvojite aplikacije/izvršavanje, podatkovne usluge i alate. To sprječava nepotrebne promjene aplikacija tijekom incidenta na platformi.
Testirajte više od početne stranice. Provjerite statičku krajnju točku, krajnju točku ovisnu o bazi podataka, pozadinske poslove i tijek rada sinkroniziran sa Salesforceom ako je primjenjivo.
Pregledajte kodove pogrešaka i vremenske oznake. Usporedite pogreške Heroku usmjerivača/runtimea sa službenim vremenom početka incidenta.
Potvrdite jesu li implementacije samo blokirane. Ako je produkcija ispravna, izbjegavajte prisilno implementaciju tijekom incidenta nestabilne upravljačke ravnine.
Sačuvajte dokaze. Zabilježite neuspješne zahtjeve, zapisnike, metrike, latenciju baze podataka, ID-ove incidenata i točan UTC prozor.
Treba li ponovno pokrenuti dinamometar tijekom prekida napajanja?
Samo kada smjernice za incident ili vaši vlastiti dokazi to podupiru. Ponovno pokretanje može pomoći kada je određeni dinamometar zaglavljen, ali također može ukloniti ispravan proces ili stvoriti dodatni odljev korisnika tijekom incidenta na cijeloj platformi.
Za incident od 10. lipnja 2025., Heroku je objavio specifično rješenje za aplikacije Private Space: pogođeni korisnici mogli su zaustavljati pojedinačne dinamometare jedan po jedan kako bi se zamijenili. Heroku je izričito upozorio da to ne jamči potpuni oporavak dok uzvodne usluge ostaju oštećene te da se dinamometar ne bi smjeli svi zamijeniti istovremeno. Te smjernice specifične za incident sačuvane su u službenom članku o sanaciji .
Nemojte generalizirati taj postupak na svaki prekid rada. Ako je baza podataka, sloj usmjeravanja, DNS davatelj ili Heroku Connect stvarno usko grlo, ponovno pokretanje web dynamometra možda neće ništa postići.
Oporavak nije dovršen kada se početna stranica prvi put vrati
Nakon što se vrati dostupnost platforme, nizvodni sustavi još uvijek mogu nadoknaditi zaostatak. Heroku je rekao da su nakon prekida u lipnju 2025. isporučene e-poruke sa zakašnjenjem, sinkronizacija Heroku Connecta morala je nadoknaditi zaostatak, a faza izdavanja imala je zaostatak čije je rješavanje trajalo satima.
Za produkcijsku aplikaciju, validirajte oporavak kroz cijeli lanac ovisnosti:
Stopa uspješnosti i latencija HTTP-a su se normalizirale.
Svi očekivani web i worker dyno uređaji su ispravni.
Čitanje i pisanje u bazu podataka uspješno se odvija s normalnom latencijom.
Redovi čekanja i zakazani poslovi se obrađuju umjesto da se gomilaju.
Heroku Connect mapiranja su sinkronizirana ako se koriste.
Implementacije i poslovi u fazi izdavanja rade normalno.
Zapisnici i metrike stižu bez neuobičajenog kašnjenja.
Dodaci trećih strana i vanjski API-ji su se oporavili.
Zaključak
Prekid rada Salesforce Herokua može utjecati na implementirane aplikacije na nekoliko različitih slojeva. Incidenti tijekom izvođenja i usmjeravanja mogu izravno učiniti aplikacije nedostupnima; incidenti s podacima mogu ostaviti procese u pogonu, ali prekinuti ključne značajke; incidenti s povezivanjem mogu uzrokovati zastarjelost podataka koje podržava Salesforce; a incidenti s alatima mogu blokirati implementacije bez utjecaja na izdanje koje je već u produkciji.
Najbolji operativni odgovor stoga nije "ponovno pokretanje svega". Prvo utvrdite je li kvar u Aplikacijama/Izvršavanju, Podacima, Alatima, DNS-u ili integraciji. Usporedite vlastite metrike sa Salesforce Trustom, sačuvajte dokaze, slijedite smjernice za ublažavanje specifičnih incidenata i provjerite svaku ovisnost nakon oporavka. Taj pristup smanjuje rizik pretvaranja incidenta platforme u vlastiti incident aplikacije.