Početna
» New Trends
»
Poluvodiči sljedeće generacije za umjetnu inteligenciju i superračunalstvo: Što je važno izvan FLOPS-a
Poluvodiči sljedeće generacije za umjetnu inteligenciju i superračunalstvo: Što je važno izvan FLOPS-a
U 2026. godini, najvažnija promjena u umjetnoj inteligenciji i superračunalnom hardveru nije jedan novi tranzistorski čvor ili akcelerator. To je pomak prema dizajniranju cijelog računalnog sustava kao jedne poluvodičke platforme: logika, memorija velike propusnosti, čipleti, pakiranje, skalabilne veze, mrežna struktura, napajanje, hlađenje i softver, sve se mora ko-optimizirati. NVIDIA kaže da je njihova platforma Vera Rubin sada u punoj proizvodnji, AMD je lansirao svoju obitelj Instinct MI400 u srpnju 2026., Micron isporučuje HBM4 u velikim količinama, a TSMC kaže da je N2 ušao u masovnu proizvodnju krajem 2025., dok je za masovnu proizvodnju N2P i A16 planirana druga polovica 2026. Ti događaji jasno iznose jednu lekciju: odabir poluvodiča sljedeće generacije sada znači odabir arhitekture sustava, a ne samo čipa.
To je važno jer „najbolji“ poluvodič uvelike ovisi o radnom opterećenju. Klaster za obuku na temelju graničnog modela, nacionalni superračunalni centar, usluga zaključivanja u oblaku i implementacija umjetne inteligencije u poduzeću mogu ići u prilog različitim kompromisima. Sam vršni FLOPS je loše pravilo kupnje. Kapacitet memorije, propusnost memorije, topologija međusobnog povezivanja, podržani numerički formati, zrelost softvera, zahtjevi za hlađenjem, dostupnost i ukupni trošak sustava mogu biti jednako važni.
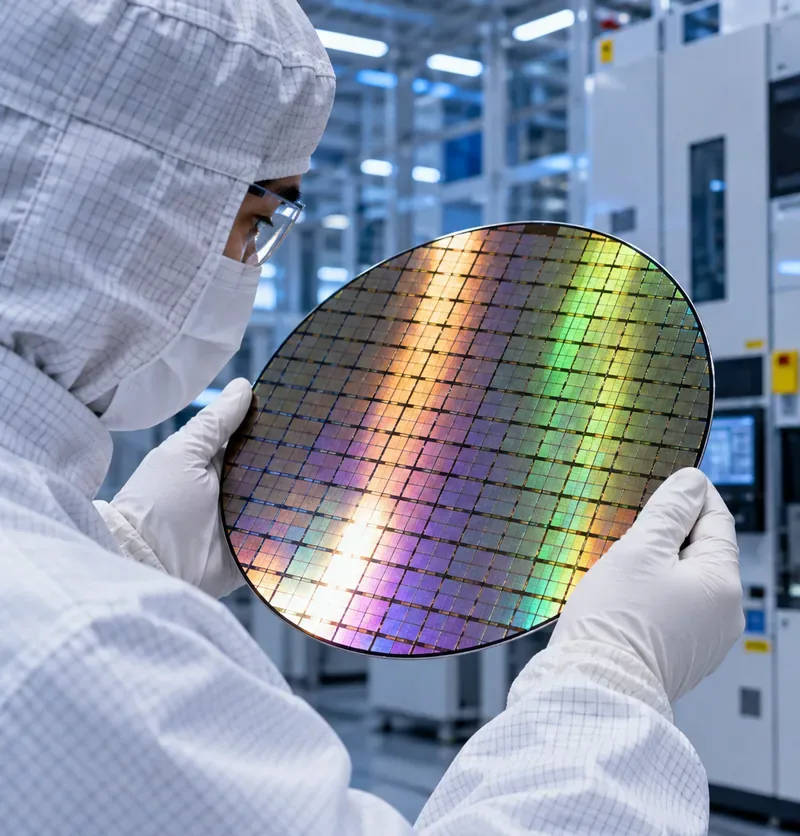
Tehničar za čiste sobe pregledava uzorkovanu silicijsku pločicu, ilustrirajući preciznu proizvodnju koja stoji iza naprednih procesora koji se koriste u umjetnoj inteligenciji i visokoučinkovitom računalstvu.
Promjena 2026.: memorija i međusobno povezivanje sada su prvoklasna ograničenja dizajna
Moderni AI akceleratori mogu izvršavati aritmetičke operacije brže nego što im se podaci uvijek mogu dostaviti. To čini propusnost memorije i premještanje podataka ključnima za performanse u stvarnom svijetu. Micron navodi da je njegov proizvod HBM4 od 36 GB, veličine 12, u velikoj proizvodnji i pruža više od 2,8 TB/s propusnosti po stogu, koristeći 2048-bitno sučelje, s više od 20% boljom energetskom učinkovitošću od usporedivog proizvoda HBM3E. Pogledajte informacije o Micronovom proizvodu HBM4 i njegovu najavu proizvodnje HBM4 iz ožujka 2026 .
Kompromis je što je HBM skup i zahtijeva puno pakiranja. Više slojeva povećava kapacitet i propusnost, ali također povećavaju paket, kompliciraju usmjeravanje i isporuku energije, povećavaju toplinsku gustoću i stavljaju veći pritisak na prinos pakiranja. Za zaključivanje vezano uz memoriju, velike modele preporuka, posluživanje LLM-a s dugim kontekstom i znanstvena opterećenja s visokom ponovnom upotrebom podataka, plaćanje za više HBM-a može imati smisla. Za manje modele s niskim pritiskom memorije, ta premija može biti uzaludna.
NVIDIA-in Vera Rubin NVL72 ilustrira pristup koji stavlja sustav na prvo mjesto. NVIDIA objavljuje konfiguraciju od 72 Rubin GPU-a i 36 Vera CPU-a, s 20,7 TB HBM4 po cijelom racku. Jedan Rubin GPU naveden je s 288 GB HBM4, dok NVLink 6 pruža do 3,6 TB/s propusnosti skaliranja po GPU-u. Platforma je dizajnirana za predtrening, posttrening, skaliranje tijekom testiranja i agentsko zaključivanje velikih razmjera. Trenutne specifikacije dostupne su na stranici NVIDIA Vera Rubin NVL72 .
Prednost je integracija. Izračun, koherentnost CPU-a i GPU-a, skalabilna struktura, umrežavanje, upravljanje sustavom i softver projektiraju se zajedno. To može smanjiti rizik sastavljanja velikog klastera od neovisno optimiziranih komponenti. Posebno je atraktivno kada su vrijeme implementacije i zreo ekosustav GPU softvera važniji od arhitektonske otvorenosti.
Kompromis je predanost čvrsto integriranoj platformi. Veliki sustavi u racku također zahtijevaju značajno planiranje objekata, uključujući hlađenje tekućinom, distribuciju električne energije i dizajn mreže. Kupci bi trebali usporediti isporučeni protok aplikacije po racku i po megavatu, ne samo specifikacije akceleratora. Brojke vršnih performansi koje objavljuju dobavljači su teorijske ili specifične za radno opterećenje i trebale bi se validirati sa stvarnim modelom, veličinom serije, duljinom sekvence, numeričkom preciznošću i komunikacijskim obrascem koji će se izvoditi u produkciji.
Opcija 2: GPU sustavi s puno čipleta i otvorenijom strategijom infrastrukture
AMD-ova Instinct MI400 serija ide drugačijim putem, a istovremeno teži istom cilju na razini sustava. MI455X kombinira čiplete, HBM4, napredno pakiranje i Infinity Fabric. AMD navodi do 432 GB HBM4 i do 23,3 TB/s vršne teorijske propusnosti memorije po MI455X GPU-u. Referentni dizajn Helios rack-skale kombinira 72 MI455X GPU-a i izgrađen je oko standarda otvorene infrastrukture. AMD kaže da se masovna implementacija temeljena na Heliosu očekuje u drugoj polovici 2026. Pogledajte stranicu AMD Instinct MI400 serije .
Ovaj pristup je privlačan kada su kapacitet memorije, modularnost čipleta, ROCm i otvoreni standardi rack ili interconnect-a strateški prioriteti. Lokalniji HBM može smanjiti pritisak particioniranja modela i pomoći kod zaključivanja radnih opterećenja s velikim KV predmemorijama ili radnim opterećenjima koja bi inače prosipala podatke po akceleratorima.
Kompromis je validacija softvera. Platforma može imati snažne silicijske specifikacije, ali i dalje zahtijevati inženjerski rad ako je kritični okvir, jezgra, obrazac kolektivne komunikacije ili prilagođeni operator bolje optimiziran negdje drugdje. Organizacije koje razmatraju AMD trebale bi mjeriti vlastite cjevovode za obuku i zaključivanje pod ROCm-om, umjesto da pretpostavljaju da prenosivost automatski znači jednake performanse.
Opcija 3: specijalizirani AI ASIC-ovi kada je prilagođavanje opterećenju važnije od općenitosti
Googleov TPU7x, također poznat kao Ironwood, pokazuje prednosti akceleratora specifičnog za domenu. Google Cloud navodi 192 GB HBM-a po čipu, oko 7,38 TB/s HBM propusnosti, 1,2 TB/s dvosmjerne međučipovske propusnosti i velike konfiguracije podova. Arhitektura je izgrađena oko tenzorskog i rijetkog računanja, a ne pokušava poslužiti svaki mogući slučaj upotrebe akceleratora. Tehnički detalji dostupni su u dokumentaciji Google Cloud TPU7x .
Specijalizirani akcelerator može biti dobar izbor kada se ciljni modeli jasno mapiraju na njegov kompajler, numeričke formate, hijerarhiju memorije i podržane okvire. Isporuka u oblaku također može ukloniti velik dio opterećenja objekta povezanog s posjedovanjem velikog AI klastera.
Kompromis je prenosivost i širina radnog opterećenja. Ako se organizacija oslanja na kod specifičan za CUDA niske razine, neobične kernele, specijalizirane znanstvene biblioteke ili aplikacije izvan idealnog područja akceleratora, trošak migracije može nadmašiti učinkovitost hardvera. Stoga je ispravna usporedba vrijeme do rezultata i omjer troškova i rezultata za stvarni softverski paket.
Napredno pakiranje postaje jednako važno kao i skaliranje tranzistora
Vodeći AI procesori su previše složeni da bi se pakiranje tretiralo kao pasivni završni korak. TSMC-ova CoWoS platforma integrira logiku i HBM koristeći velike međuspojnike, dok njihova SoIC tehnologija podržava 3D slaganje čipova s visokom gustoćom die-to-die veza. TSMC navodi da je njihovo 3nm SoIC slaganje ušlo u serijsku proizvodnju 2025. godine. Njihova CoWoS-L tehnologija također je premašila konvencionalna ograničenja veličine končanice za velika AI i HPC pakete. Pogledajte službene TSMC- ove stranice o CoWoS i SoIC tehnologiji.
Intel Foundry teži sličnom cilju s EMIB-om i Foverosom. EMIB koristi ugrađene silicijske mostove za spajanje čipova visoke gustoće bez potrebe za punim silicijskim međuslojem preko cijelog pakiranja. Foveros dodaje vertikalno slaganje, dok Foveros Direct koristi hibridno povezivanje bakar-bakar za vrlo fine veze između čipova. Intel opisuje ove tehnologije na svojoj stranici o naprednom pakiranju .
Inženjerski izbor nije jednostavno "2.5D naspram 3D". Dizajneri moraju uravnotežiti gustoću međusobnih veza, veličinu pakiranja, toplinsko ponašanje, strategiju poznatih dobrih čipova, prinos, složenost montaže i troškove. 3D slaganje može skratiti veze i poboljšati gustoću propusnosti, ali vertikalno slaganje vrućih računalnih čipova može otežati odvođenje topline. 2.5D arhitekturu je lakše hladiti i testirati, ali može zahtijevati veći otisak i duže međusobne veze.
Vrhunski procesni čvorovi i dalje su važni - ali iz specifičnih razloga
Skaliranje tranzistora ostaje važno jer su AI i HPC sustavi ograničeni snagom. TSMC kaže da je njihova N2 tehnologija ušla u serijsku proizvodnju u četvrtom tromjesečju 2025., koristeći nanoslojne tranzistore, te da su N2P i A16 planirani za serijsku proizvodnju u drugoj polovici 2026. A16 dodaje napajanje na stražnjoj strani, što pomiče usmjeravanje napajanja dalje od prednjih signalnih slojeva i namijenjeno je zahtjevnim HPC dizajnima s gustim energetskim mrežama. Pogledajte stranicu TSMC A16 tehnologije .
Intelov 18A čvor slično kombinira arhitekturu tranzistora s gate-all-around tehnologijom, nazvanu RibbonFET, s napajanjem na stražnjoj strani, nazvanom PowerVia. Intel je u lipnju 2026. izjavio da je 18A ušao u proizvodnju 2025. i da je 18A-P ušao u rizičnu proizvodnju. Pogledajte ažuriranje procesa Intel Foundryja za 2026. godinu .
Kompromis je zrelost naspram maksimalne učinkovitosti. Novi čvor može poboljšati performanse, gustoću ili snagu, ali zreliji čvorovi često nude bolji prinos, niže troškove i uspostavljeniji ekosustav dizajna. Arhitekture čipova čine ovaj izbor manje binarnim: računalne pločice mogu koristiti najnoviji čvor dok I/O, predmemorija, analogni ili sučeljni čipovi ostaju na starijim, jeftinijim procesima.
Otvoreni standardi čipleta mogu smanjiti ovisnost, ali interoperabilnost nije automatska
UCIe je dizajniran za standardizaciju brze komunikacije između čipova. UCIe 3.0 podržava brzine prijenosa podataka od 48 GT/s i 64 GT/s, udvostručujući maksimalnu brzinu prijenosa podataka UCIe 2.0, uz održavanje unatrag kompatibilnosti. Također proširuje mogućnosti upravljanja i značajke uštede energije. Pregled specifikacija dostupan je od UCIe konzorcija .
Za dizajnere poluvodiča, UCIe može olakšati kombiniranje čipleta iz različitih timova, procesa ili na kraju dobavljača. Međutim, za kupce sustava, otvoreni standard od čipa do čipa ne znači odmah zamjenjive akceleratorske module. Pakiranje, napajanje, firmver, memorijska sučelja, toplinski dizajn, sigurnost, validacija i softver još se moraju uskladiti. Stoga bi UCIe trebalo smatrati važnim gradivnim blokom za modularni dizajn, a ne jamstvom plug-and-play silicija.
Što biste trebali odabrati za različite potrebe umjetne inteligencije i superračunala?
HPC-usmjereni GPU-ovi plus visokoučinkoviti CPU-i i mrežna struktura
Prenosivost aplikacije i numerički zahtjevi
Umjetna inteligencija u oblaku sa standardiziranim modelima
Isporučena propusnost, upravljana skala, podrška za kompajler, jednostavnost rada
Oblačni GPU ili oblačni AI ASIC
Prenosivost i dugoročna ovisnost o platformi
Prilagođena silicijska ili suverena infrastruktura
Fleksibilnost čipleta, pristup tvornicama, ekosustav pakiranja, otvorene međusobne veze
Heterogeni čipleti s naprednim 2.5D/3D pakiranjem
Trošak NRE-a, vrijeme validacije, kapacitet pakiranja i prinos
Kako procijeniti poluvodičku platformu sljedeće generacije bez da vas zavaraju glavne specifikacije
Započnite s radnim opterećenjem, a ne s čipom. Izmjerite veličinu modela, broj aktivnih parametara, duljinu konteksta, veličinu serije, intenzitet komunikacije, zahtjeve za preciznošću, ponašanje kontrolnih točaka i očekivanu iskorištenost. Zatim procijenite hardver u odnosu na ta ograničenja.
Za računalno ograničena opterećenja: usporedite održive performanse kernela s preciznošću koju ćete stvarno koristiti, ne samo vršne vrijednosti FP4 ili FP8.
Za memorijski ograničena opterećenja: dajte prioritet učinkovitoj propusnosti HBM-a, kapacitetu, ponašanju predmemorije i opterećenju premještanja podataka.
Za distribuirano učenje: mjerite kolektivne operacije kao što su all-reduce i all-to-all na željenom broju čvorova.
Za zaključivanje: broj testnih tokena u sekundi, vrijeme do prvog tokena, latencija između tokena, konkurentnost i energija po zahtjevu korištenjem realnih duljina konteksta.
Za HPC: provjerite FP64, performanse vektora, ponašanje memorije, kvalitetu kompajlera, MPI skaliranje i točne znanstvene biblioteke koje se koriste.
Za planiranje objekata: uključite napajanje polica, tehnologiju hlađenja, opterećenje poda, mrežnu optiku, servisiranje i rezervni kapacitet.
To je posebno važno u 2026. godini jer se arhitekture dobavljača razlikuju. NVIDIA-ina Rubin platforma naglašava čvrsto integrirano računalstvo i umrežavanje na razini racka; AMD-ova MI400 obitelj kombinira veliki HBM4 kapacitet s čipovima i strategijom otvorene infrastrukture; Google TPU7x cilja na tenzorski orijentirana opterećenja putem ASIC-a isporučenog u oblaku; TSMC, Intel, dobavljači memorije i tijela za standardizaciju istovremeno mijenjaju fizičke gradivne blokove ispod svih njih.
Praktični zaključak: optimizirajte cijeli put podataka
Sljedeća generacija poluvodiča pokretat će umjetnu inteligenciju i superračunalstvo ne zato što jedan uređaj pobjeđuje u svakom benchmarku, već zato što industrija uči učinkovitije premještati podatke iz memorije u CPU, s CPU-a na akcelerator, između akceleratora i između složenih čipova i HBM-a. HBM4, čipleti, 2.5D i 3D pakiranje, napajanje s stražnje strane, brze poveznice za skaliranje i otvoreni standardi od čipa do čipa odgovori su na isto ograničenje: aritmetika je korisna samo kada podaci stižu dovoljno brzo i unutar dostupnog energetskog proračuna.
Za organizacije koje danas kupuju infrastrukturu, najsigurnija preporuka je specifična za radno opterećenje. Odaberite integriranu GPU platformu kada su zrelost ekosustava i brzo skaliranje prioritet. Razmotrite otvorenu GPU platformu kada su kapacitet memorije, fleksibilnost infrastrukture i prenosivost softvera strateški važni. Koristite specijalizirani ASIC kada se radno opterećenje jasno mapira na nju i ovisnost o oblaku ili platformi je prihvatljiva. Za prilagođeni silicij, uložite u chiplete i napredno pakiranje kada dobitci u performansama i količini proizvoda opravdavaju dodatnu složenost dizajna i validacije.
Najvažnije je testirati kompletne sustave u proizvodnim uvjetima. Poluvodič koji izgleda najbrže na specifikaciji možda neće biti onaj koji nudi najnižu cijenu, najkraće vrijeme do rezultata ili najbolje performanse po vatu za vaše radno opterećenje.