Valkoposkihanhi: tuntomerkit, elintavat ja tunnistusopas Suomessa

Tunnista valkoposkihanhi valkoisista kasvoista ja mustasta kaulasta. Lue, missä se elää, mitä se syö ja miten erotat sen kanadanhanhesta.
Lyhyt vastaus: laajalle levinnyt pilvialustan käyttökatkos johtuu yleensä vikaketjusta, ei yhdestä yksittäisestä rikkoutuneesta palvelimesta. Riskialtis kokoonpano- tai ohjelmistomuutos voi vaikuttaa jaettuun riippuvuuteen, kuten identiteettiin, DNS:ään, valtuutukseen tai ohjaustason API:in. Ensimmäinen vika laukaisee sitten uudelleenyrityksiä, liikenteen siirtoja tai automaattisen skaalauksen, mikä lisää kuormitusta ja levittää vaikutusta eri alueille tai tuotteille. Heikko havaittavuus ja testaamaton palautuspolku voivat pidentää käyttökatkosta.
Tämä kaava on tärkeä, koska se muuttaa sitä, mihin sinun tulisi varautua. ”Pilvi” ei ole yksi kone, eikä ”palveluntarjoaja on alhaalla” ole täydellinen diagnoosi. Sovelluksesi voi olla riippuvainen useista palveluntarjoajan palveluista, omasta kokoonpanostasi, ulkoisista API-rajapinnoista ja palautusprosessista, joka toimii vain, jos se on testattu. Tämä opas selittää tärkeimmät syyt, mitä aloittelijan tulisi tarkistaa ensin, ja virheet, jotka vaikeuttavat laajan käyttökatkoksen hallintaa.
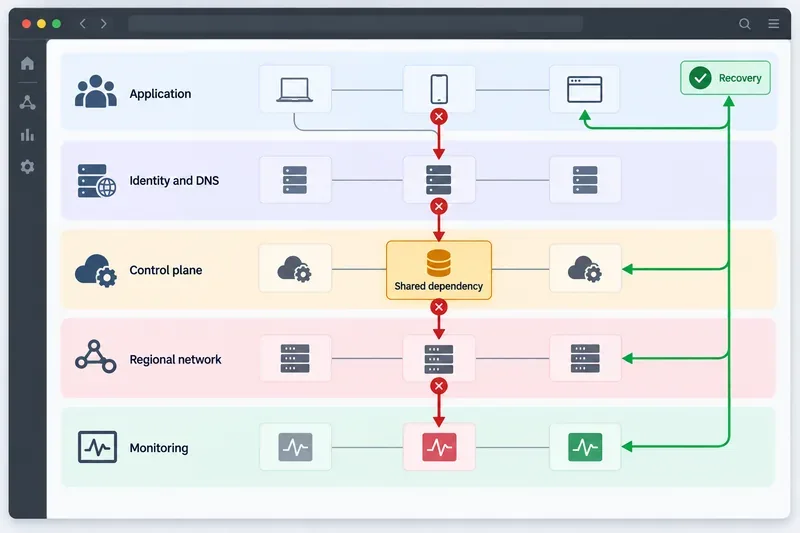
Saatavuus tarkoittaa, pystyykö palvelu vastaamaan pyyntöön onnistuneesti. Suorituskyvyn heikkeneminen tarkoittaa, että se vastaa, mutta liian hitaasti tai korkeilla virheprosenteilla. Laaja häiriö voi vaikuttaa datatasoon – järjestelmiin, jotka palvelevat sovellusliikennettä – tai ohjaustasoon – API-rajapintoihin ja sisäisiin järjestelmiin, joita käytetään resurssien luomiseen, konfigurointiin, todentamiseen ja hallintaan. Ohjaustason käyttökatkos voi estää käyttöönoton tai skaalauksen, vaikka jo käynnissä olevat työkuormat jatkaisivat jonkin liikenteen palvelemista.
Jaettu riippuvuus on palvelu, johon useat tuotteet tai pyyntöpolut ovat riippuvaisia. Yleisiä esimerkkejä ovat DNS, identiteetin ja pääsynhallinta, varmenteiden validointi, reititys, metatiedot, kiintiöt ja havaittavuus. Jos riippuvuus on keskitetty tai sillä on yhteinen vikaantumistila, pienellä vialla voi olla paljon laajempi vaikutusalue – joukko asiakkaita, alueita tai palveluita, joihin yksi vika vaikuttaa.
Muutokset ovat merkittävä suurten häiriöiden lähde, koska ne voivat olla oikeita yhdessä kontekstissa mutta vaarallisia alustatasolla. Käyttöoikeuksien muokkaus, reitityssääntö, ominaisuusmerkintä, rakenteen muutos tai automatisoitu kapasiteettitoiminto voi koskea kaikkia alueita tai kaikkia asiakkaita kohtaavia koneita. Automaatio voi vahvistaa tuloksen ennen kuin ihminen näkee sen.
Cloudflaren virallinen jälkianalyysi 18. marraskuuta 2025 havainnollistaa tätä virheluokkaa. Tietokannan käyttöoikeuksien muutos aiheutti kaksoisrivejä Bot Management -ominaisuustiedostossa. Tiedostosta tuli noin kaksinkertaisen kokoinen, se levisi koneille maailmanlaajuisesti ja ylitti reititysohjelmiston rajan. Cloudflaren mukaan tapausta ei aiheuttanut kyberhyökkäys; vika johtui kokoonpanon ja ohjelmiston vuorovaikutuksesta. Yritys lopetti leviämisen ja otti käyttöön tunnetusti toimivan tiedoston. Lue Cloudflaren 18. marraskuuta 2025 julkaisema käyttökatkoksen jälkianalyysi saadaksesi yksityiskohtaisen selvityksen palveluntarjoajasta.
Peruspalvelut sijaitsevat usein useiden näennäisesti toisiinsa liittymättömien tuotteiden alla. Identiteetti, valtuutus, sisäinen DNS, valvonta, metadata ja resurssien tarjoamiseen käytettävät API:t voivat olla yleinen vikaantumiskohta. Asiakkaan kohtaamat oireet voivat näyttää erilaisilta – kirjautumisvirheet, käyttöönottovirheet, aikakatkaisut tai puuttuvat mittarit – mutta taustalla oleva riippuvuus voi olla sama.
AWS kuvaili 7. joulukuuta 2021 julkaisemassaan US-EAST-1-tapahtuman jälkeisessä yhteenvedossa odottamatonta vuorovaikutusta, johon liittyi automatisoitua skaalaustoimintaa ja sisäisiä verkkolaitteita. AWS:n mukaan kyseinen verkko isännöi peruspalveluita, kuten valvontaa, sisäistä DNS:ää, valtuutuspalveluita ja osia EC2-ohjaustasosta. Yhteysyritykset ja uudelleenyritykset aiheuttivat sitten ruuhkaa. AWS raportoi myös, että sen tukipalvelukeskus ja osat sen palvelun tilan viestintäpolusta olivat kärsineet. AWS:n tapahtuman jälkeinen yhteenveto on hyödyllinen esimerkki siitä, miksi palveluntarjoajalla voi olla vaikeuksia sekä palveluiden palauttamisessa että niiden diagnosoinnissa samanaikaisesti.
Kun pyyntö epäonnistuu, asiakkaat yrittävät usein uudelleen. Uudelleenyritysmyrsky syntyy , kun useat asiakkaat yrittävät uudelleen samanaikaisesti, varsinkin ilman eksponentiaalista peruutusta – strategiaa, joka lisää odotusaikaa yritysten välillä – ja jitteriä, joka lisää pienen satunnaisen viiveen. Nämä uudelleenyritykset kuluttavat samaa niukkaa kapasiteettia ja voivat muuttaa osittaisen epäonnistumisen laajemmaksi katkokseksi.
Muita kuormituskertoimia ovat liian usein suoritettavat terveystarkastukset, automaattinen vikasietoisuus, joka lähettää liikenteen jo ennestään vilkkaalle alueelle, jonot, jotka vapauttavat ruuhkan kerralla, ja automaattisen skaalauksen käytännöt, jotka reagoivat oireisiin syiden sijaan. Palvelu voi siis kaatua, vaikka sen palvelimet eivät olisi fyysisesti rikki. Tärkeä kysymys ei ole vain "Voiko palveluntarjoaja lisätä kapasiteettia?", vaan myös "Lisäävätkö asiakkaamme ja automaatiomme työtä vikaantumispolulle?".
Pilvialustat ovat edelleen riippuvaisia fyysisistä datakeskuksista, sähköjärjestelmistä, jäähdytyksestä, kuituyhteyksistä, reitittimistä, tallennuslaitteista ja alueellisista verkkopoluista. Redundanssi pienentää riskiä, mutta se ei tee jokaisesta häiriöstä näkymätöntä. Jaettu laitos, saatavuusvyöhyke, alueiden välinen yhteys tai reititysraja voi vaikuttaa useisiin palveluihin samanaikaisesti.
Myös alueellinen toipuminen voi olla epätasaista. Google Cloud raportoi 12. kesäkuuta 2025 julkaisemassaan tapausraportissa, että useissa tuotteissa oli API-ongelmia, jotka liittyivät taustalla olevaan riippuvuuteen, ja toipuminen vaihteli sijainnin mukaan. Raportissa mainittiin erityisesti hitaampi toipuminen us-central1-palveluissa sekä Yhdysvaltojen ja usean alueen palveluissa. Google Cloud Service Healthin tapausraportti osoittaa, miksi yhden alueen tai yhden tuotteen tarkistaminen ei riitä koko ongelman ymmärtämiseen.
Alusta voi olla toimiva, kunnes se vastaanottaa odottamattoman syötteen: tiedoston, joka on suurempi kuin jäsentimen raja, kaksoiskappaleen, epätavallisen API-vastauksen tai datan siirron, joka paljastaa vanhemman koodin oletuksen. Nämä virheet ovat erityisen vaarallisia, kun sama julkaisu tai kokoonpano jaetaan maailmanlaajuisesti.
Kovat rajoitukset eivät aina ole ilmeisiä normaalissa testauksessa. Konfiguraatiotiedosto voi olla kelvollinen, mutta liian suuri alavirran komponentille. Pyyntöjen määrä voi olla hyväksyttävä yhdellä alueella, mutta ylittää kiintiön vikasietoisuuden jälkeen. Palautustyö voi olla kerran turvallinen, mutta toistettaessa se voi luoda päällekkäistä työtä. Testauksen tulisi kattaa virheelliset tiedot, osittaisen riippuvuuden epäonnistumisen, alueellisen evakuoinnin ja toistuvan suorituksen – ei pelkästään onnellista polkua.
Hajautetut palvelunestohyökkäykset, varastetut tunnistetiedot, väärinkäyttö ja haitalliset määritysmuutokset voivat aiheuttaa käyttökatkoksia. Liikenteen piikki tai todennusvirhe ei kuitenkaan ole todiste hyökkäyksestä. Jokaisen tapahtuman käsitteleminen tietoturvatapahtumana voi lähettää vastauksen väärään suuntaan ja viivästyttää määritysten palauttamista.
Käytä todisteita: vertaile pyyntömalleja, todennuslokeja, muutostietueita, palveluntarjoajien tilapäivityksiä ja riippumattomia selvityksiä. Pidä tietoturvan eskalointi saatavilla, mutta erota "mitä tiedämme" "mitä epäilemme". Cloudflaren vuoden 2025 jälkianalyysi on konkreettinen muistutus siitä, että käyttökatkos voi aluksi näyttää hyökkäykseltä ja sillä voi silti olla eri perimmäinen syy.
Katkoksen hallinta vaikeutuu, kun valvontajärjestelmä on riippuvainen samasta vikaantumispolusta kuin sovellus. Kojelauta voi näyttää, että virtuaalikone on käynnissä, vaikka asiakkaat eivät pysty suorittamaan tapahtumaa. Google Cloudin ohjeistus asiakaskeskeisistä SLO:ista ja mukautetuista mittareista selittää tämän eron: infrastruktuurin käyttöaika ei ole sama asia kuin onnistunut asiakkaan toiminto.
Käytä vähintään yhtä riippumatonta synteettistä tarkistusta – ajoitettua testiä, joka suorittaa turvallisen, asiakkaan kaltaisen tapahtuman – kyseessä olevan ympäristön ulkopuolelta. Pidä toinen tapa päästä käsiksi tapahtumapäivityksiin ja tallenna palveluntarjoajan tilasivut, sisäiset hälytykset ja asiakasraportit yhdelle aikajanalle. Älä oleta, että tilasivu on erehtymätön: Cloudflare raportoi, että sen oma tilasivu ei myöskään ollut käytettävissä marraskuun 2025 tapahtuman aikana, vaikka se sijaitsi Cloudflaren infrastruktuurin ulkopuolella.
Aloita yksinkertaisella riippuvuuskartalla. Sisällytä DNS, identiteetti, salaisuudet, varmenteet, jonot, tietokannat, objektien tallennustila, kolmannen osapuolen API:t, sisällön toimitus, valvonta ja palveluntarjoajan alue. Merkitse, mitkä komponentit ovat pakollisia kullekin pyynnölle ja mitkä voidaan heikentää tai ohittaa. Tämä harjoitus paljastaa usein, että kahdella "itsenäisellä" alueella on edelleen yhteinen identiteetti, DNS, käyttöönottotyökalut tai yksi ulkoinen toimittaja.
Määritä RTO (palautumisaikatavoite, palvelun palauttamisen tavoiteaika) ja RPO (palautumispistetavoite, ajassa mitattu hyväksyttävä tietohävikin määrä). Valitse sitten liiketoiminnan tarpeita vastaavat hallintalaitteet. Pieni sisäinen hallintapaneeli voi hyväksyä manuaalisen palautuksen. Maksu- tai hätätyönkulku saattaa vaatia monialuepalvelua, testattua tietojen replikointia ja dokumentoitua vikasietoisuuden omistajaa.
| Varhainen vihje | Todennäköinen syy | Valmistelu tai valvonta |
|---|---|---|
| Virheet alkavat heti käyttöönoton tai käytäntömuutoksen jälkeen | Kokoonpano- tai ohjelmistomuutos | Canaryn julkaisut, hyväksynnät, versionhallinta ja nopea palautus |
| Useat tuotteet eivät tunnista tai ratkaise nimiä | Jaettu identiteetti, valtuutus tai DNS-riippuvuus | Riippuvuuskartoitus ja itsenäinen pääsypolku |
| Latenssi kasvaa uudelleenyritysten lisääntyessä | Ylikuormitus- tai uudelleenyritysmyrsky | Takaisku, jitter, katkaisijat ja kuormanpudotus |
| Yksi alue toipuu, kun taas toinen pysyy heikentyneenä | Alueellinen kapasiteetti- tai riippuvuusero | Testattu usean alueen vikasietoisuus ja alueelliset runbookit |
| Infrastruktuuri näyttää terveeltä, mutta transaktiot epäonnistuvat | Havaittavuusero tai alavirran riippuvuus | Asiakastason SLO:t ja synteettiset tapahtumatarkistukset |
Laajalle levinneiden pilvipalveluiden käyttökatkosten pääasialliset syyt ovat vuorovaikutuksessa olevat järjestelmät: vaaralliset muutokset, jaetut riippuvuudet, ylikuormitus ja uudelleenyritykset, alueelliset infrastruktuuriviat, ohjelmistojen ja datan muotovirheet, tietoturva- tai liikennetapahtumat sekä havaitsemisen katvealueet. Et voi poistaa kaikkia palveluntarjoajan käyttökatkoksia, mutta voit rajoittaa niiden vaikutusaluetta. Kartoita riippuvuudet, mittaa asiakkaiden tuloksia, tee uudelleenyrityksistä kohteliaita, pidä muutokset palautuvissa, testaa vikasietoisuutta ja ylläpidä tapahtumarekisteriä, joka erottaa faktat hypoteeseista.
Lähdehuomautus: Tämä artikkeli on tarkistettu 16. syyskuuta 2026. Palveluntarjoajien tapaukset ovat dokumentoituja esimerkkejä, eivätkä ne ole tyhjentävä luettelo, eivätkä palveluntarjoajien jälkitarkastukset välttämättä paljasta kaikkia sisäisiä yksityiskohtia. Tuotenimet, arkkitehtuurit, tilasivut ja palautumiskäytännöt voivat muuttua ajan myötä.
Tunnista valkoposkihanhi valkoisista kasvoista ja mustasta kaulasta. Lue, missä se elää, mitä se syö ja miten erotat sen kanadanhanhesta.
Influenssan oireita ovat äkillinen kuume, lihassärky ja yskä. Lue, miten tauti eroaa flunssasta, milloin kotihoito riittää ja milloin pitää hakea apua.
Näin haet HIFK:n uutiset Yle Urheilusta, erotat jääkiekon ja jalkapallon sekä tarkistat ottelutulokset Liigan ja seuran virallisista lähteistä.
Katso ampumahiihdon maailmancupin 2026–2027 kilpailukalenteri, viralliset tulokset ja pistetilanteet sekä Kontiolahden avauksen ajat Suomessa.
Fleetwood Town yllätti Arsenalin liigacupissa 27.10.2026. Katso tulos, rangaistuspotkukilpailun ratkaisu, otteluaika Suomen ajassa ja jatkopaikan merkitys.
Israelin vaalit 2026 järjestettiin 27. lokakuuta. Näin 120 paikkaa jaetaan, mitä 3,25 prosentin äänikynnys merkitsee ja miten uusi hallitus muodostetaan.
Olkiluoto 1 on Eurajoen kiehutusvesireaktori. Tutustu OL1:n toimintaperiaatteeseen, 890 MW:n tehoon, vuosihuoltoihin ja merkitykseen Suomen sähköntuotannossa.
Jos velkaa on liikaa, aloita velkalistasta ja realistisesta budjetista. Katso, miten sovit maksuista ja haet maksutonta velkaneuvontaa Suomessa.
Tuskan 2027 päivät ja artistien esiintymispäivät on julkaistu. Vertaa lippuvaihtoehtoja, hintoja, ikärajaa, palautusehtoja ja käytännön järjestelyjä ennen ostoa.
Tuska 2027 järjestetään 2.–4.7. Suvilahdessa Helsingissä. Katso, mistä tarkistat päiväkohtaisen ohjelman, lippujen hinnat ja viralliset esiintyjäuutiset.