Hjem
» New Trends
»
Næste generations halvledere til AI og supercomputing: Hvad der betyder noget ud over FLOPS
Næste generations halvledere til AI og supercomputing: Hvad der betyder noget ud over FLOPS
I 2026 er den vigtigste ændring inden for AI og supercomputerhardware ikke en enkelt ny transistorknude eller accelerator. Det er skiftet mod at designe hele computersystemet som én halvlederplatform: logik, hukommelse med høj båndbredde, chiplets, pakke, opskaleringslinks, netværksstruktur, strømforsyning, køling og software skal alle optimeres sammen. NVIDIA siger, at deres Vera Rubin-platform nu er i fuld produktion, AMD lancerede sin Instinct MI400-familie i juli 2026, Micron leverer HBM4 i store mængder, og TSMC siger, at N2 begyndte at producere store mængder i slutningen af 2025, mens N2P og A16 er planlagt til masseproduktion i andet halvår af 2026. Disse udviklinger gør én lektie klar: at vælge næste generations halvledere betyder nu at vælge en systemarkitektur, ikke bare en chip.
Det er vigtigt, fordi den "bedste" halvleder i høj grad afhænger af arbejdsbyrden. En træningsklynge i frontlinjen, et nationalt supercomputercenter, en cloud-inferenstjeneste og en AI-implementering i virksomheder kan alle favorisere forskellige afvejninger. Peak FLOPS alene er en dårlig købsregel. Hukommelseskapacitet, hukommelsesbåndbredde, sammenkoblingstopologi, understøttede numeriske formater, softwaremodenhed, kølekrav, tilgængelighed og samlede systemomkostninger kan have lige så stor betydning.
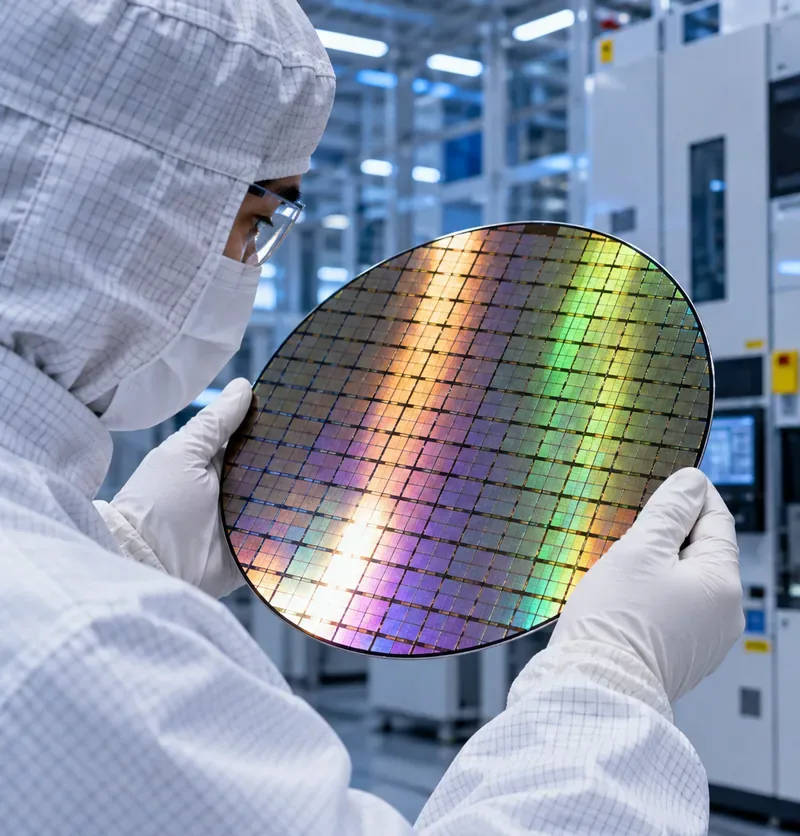
En renrumstekniker inspicerer en mønstret siliciumwafer, der illustrerer den præcisionsfremstilling, der ligger bag avancerede processorer, der anvendes i AI og højtydende databehandling.
Skiftet i 2026: hukommelse og sammenkobling er nu førsteklasses designbegrænsninger
Moderne AI-acceleratorer kan udføre aritmetik hurtigere, end data altid kan leveres til dem. Det gør hukommelsesbåndbredde og databevægelse centralt for ydeevne i den virkelige verden. Micron oplyser, at deres HBM4 36GB 12-high-produkt er i stor produktion og leverer mere end 2,8 TB/s båndbredde pr. stak ved hjælp af en 2.048-bit grænseflade med mere end 20 % bedre strømeffektivitet end deres sammenlignelige HBM3E-produkt. Se Microns HBM4-produktinformation og deres HBM4-produktionsmeddelelse fra marts 2026 .
Ulempen er, at HBM er dyrt og pakkeintensivt. Flere stakke øger kapacitet og båndbredde, men de forstørrer også pakken, komplicerer routing og strømforsyning, øger termisk tæthed og lægger mere pres på pakkeudbyttet. For hukommelsesbundet inferens, store anbefalingsmodeller, langkontekst LLM-servering og videnskabelige arbejdsbelastninger med høj datagenbrug kan det give mening at betale for mere HBM. For mindre modeller med lavt hukommelsestryk kan den præmie være spildt.
Mulighed 1: integrerede GPU-racksystemer for maksimal AI-skalering
NVIDIAs Vera Rubin NVL72 illustrerer den systemorienterede tilgang. NVIDIA udgiver en konfiguration med 72 Rubin GPU'er og 36 Vera CPU'er med 20,7 TB HBM4 på tværs af racket. En enkelt Rubin GPU er angivet med 288 GB HBM4, mens NVLink 6 leverer op til 3,6 TB/s opskaleringsbåndbredde pr. GPU. Platformen er designet til prætræning, posttræning, skalering i testfasen og storstilet agentisk inferens. Aktuelle specifikationer er tilgængelige på NVIDIA Vera Rubin NVL72-siden .
Fordelen er integration. Beregning, CPU-GPU-kohærens, scale-up fabric, netværk, systemadministration og software er konstrueret sammen. Det kan reducere risikoen ved at sammensætte en stor klynge fra uafhængigt optimerede komponenter. Det er især attraktivt, når time-to-implementation og et modent GPU-softwareøkosystem betyder mere end arkitektonisk åbenhed.
Afvejningen er en forpligtelse til en tæt integreret platform. Store rack-systemer kræver også betydelig facilitetsplanlægning, herunder væskekøling, elektrisk distribution og netværksdesign. Købere bør sammenligne den leverede applikationsgennemstrømning pr. rack og pr. megawatt, ikke kun acceleratorspecifikationer. Leverandøroffentliggjorte tal for peak performance er teoretiske eller arbejdsbelastningsspecifikke og bør valideres med den faktiske model, batchstørrelse, sekvenslængde, numerisk præcision og kommunikationsmønster, der vil køre i produktionen.
Mulighed 2: Chiplet-tunge GPU-systemer med en mere åben infrastrukturstrategi
AMDs Instinct MI400-serie tager en anden vej, men forfølger det samme mål på systemniveau. MI455X kombinerer chiplets, HBM4, avanceret pakning og Infinity Fabric. AMD lister op til 432 GB HBM4 og op til 23,3 TB/s peak teoretisk hukommelsesbåndbredde pr. MI455X GPU. Helios rack-skala referencedesign kombinerer 72 MI455X GPU'er og er bygget op omkring åbne infrastrukturstandarder. AMD siger, at volumenudrulninger baseret på Helios forventes i andet halvår af 2026. Se siden om AMD Instinct MI400-serien .
Denne tilgang er tiltalende, når hukommelseskapacitet, chiplet-modularitet, ROCm og åbne rack- eller interconnect-standarder er strategiske prioriteter. Mere lokal HBM kan reducere modelpartitioneringspresset og kan hjælpe med at udlede arbejdsbelastninger med store KV-caches eller arbejdsbelastninger, der ellers ville spilde data på tværs af acceleratorer.
Afvejningen er softwarevalidering. En platform kan have stærke siliciumspecifikationer, men stadig kræve ingeniørarbejde, hvis et kritisk framework, en kerne, et kollektivt kommunikationsmønster eller en brugerdefineret operator er bedre optimeret et andet sted. Organisationer, der overvejer AMD, bør benchmarke deres egne trænings- og inferenspipelines under ROCm i stedet for at antage, at portabilitet automatisk betyder lige ydeevne.
Mulighed 3: specialiserede AI ASIC'er, når arbejdsbelastningstilpasning er vigtigere end generalitet
Googles TPU7x, også kendt som Ironwood, viser fordelene ved en domænespecifik accelerator. Google Cloud har 192 GB HBM pr. chip, omkring 7,38 TB/s HBM-båndbredde, 1,2 TB/s tovejs interchip-forbindelsesbåndbredde og store pod-konfigurationer. Arkitekturen er bygget op omkring tensor og sparse computing i stedet for at forsøge at betjene alle mulige accelerator-use cases. Tekniske detaljer er tilgængelige i Google Cloud TPU7x-dokumentationen .
En specialiseret accelerator kan være et stærkt valg, når målmodellerne knytter sig tydeligt til dens compiler, numeriske formater, hukommelseshierarki og understøttede frameworks. Cloud-levering kan også fjerne en stor del af den facilitetsbyrde, der er forbundet med at eje en stor AI-klynge.
Afvejningen er portabilitet og arbejdsbyrdebredde. Hvis en organisation er afhængig af lavniveau CUDA-specifik kode, usædvanlige kerner, nichebaserede videnskabelige biblioteker eller applikationer uden for acceleratorens optimale potentiale, kan migreringsomkostningerne opveje hardwareeffektiviteten. Den korrekte sammenligning er derfor end-to-end time-to-result og cost-to-result for den faktiske softwarestak.
Avanceret pakning bliver lige så vigtig som transistorskalering
De førende AI-processorer er for komplekse til at behandle pakning som et passivt sidste trin. TSMCs CoWoS-platform integrerer logik og HBM ved hjælp af store interposere, mens dens SoIC-teknologi understøtter 3D-chipstacking med die-to-die-forbindelser med høj densitet. TSMC oplyser, at dens 3nm SoIC-stacking trådte i volumenproduktion i 2025. Dens CoWoS-L-teknologi er også skaleret ud over konventionelle begrænsninger for retiklestørrelse for store AI- og HPC-pakker. Se TSMCs officielle CoWoS- og SoIC- teknologisider.
Intel Foundry forfølger et lignende mål med EMIB og Foveros. EMIB bruger indlejrede siliciumbroer til at forbinde dies med høj tæthed uden at kræve en fuld siliciuminterposer på tværs af hele pakken. Foveros tilføjer lodret stabling, mens Foveros Direct bruger kobber-til-kobber hybridbinding til meget fine die-til-die-forbindelser. Intel beskriver disse teknologier på sin side om avanceret pakning .
Det tekniske valg er ikke blot "2,5D versus 3D". Designere skal afbalancere forbindelsestæthed, pakkestørrelse, termisk opførsel, known-good-die-strategi, udbytte, samlingskompleksitet og omkostninger. En 3D-stak kan forkorte links og forbedre båndbreddetætheden, men vertikal stabling af hot compute-dies kan gøre varmeafledning vanskeligere. En 2,5D-arkitektur kan være lettere at køle og teste, men kan kræve et større fodaftryk og længere forbindelser.
Avancerede procesnoder er stadig vigtige – men af specifikke årsager
Transistorskalering er fortsat vigtig, fordi AI- og HPC-systemer er effektbegrænsede. TSMC siger, at deres N2-teknologi startede i volumenproduktion i fjerde kvartal af 2025 ved hjælp af nanosheet-transistorer, og at N2P og A16 er planlagt til volumenproduktion i andet halvår af 2026. A16 tilføjer backside-strømforsyning, som flytter strømforsyningsrouting væk fra frontside-signallagene og er rettet mod krævende HPC-designs med tætte strømnetværk. Se TSMC A16-teknologisiden .
Intels 18A-node kombinerer ligeledes en gate-all-around transistorarkitektur, mærket RibbonFET, med backside-strømforsyning, mærket PowerVia. Intel meddelte i juni 2026, at 18A var gået i produktion i 2025, og at 18A-P var gået i risikoproduktion. Se Intel Foundrys procesopdatering for 2026 .
Afvejningen er modenhed versus maksimal effektivitet. En ny node kan forbedre ydeevne, tæthed eller effekt, men modne noder tilbyder ofte bedre udbytte, lavere omkostninger og et mere etableret designøkosystem. Chiplet-arkitekturer gør dette valg mindre binært: beregningsfliser kan bruge den nyeste node, mens I/O-, cache-, analog- eller interface-dies forbliver på ældre, billigere processer.
Åbne chiplet-standarder kan reducere lock-in, men interoperabilitet er ikke automatisk
UCIe er designet til at standardisere højhastigheds die-to-die-kommunikation mellem chiplets. UCIe 3.0 understøtter datahastigheder på 48 GT/s og 64 GT/s, hvilket fordobler den maksimale datahastighed for UCIe 2.0, samtidig med at bagudkompatibilitet opretholdes. Den udvider også administrations- og strømbesparende funktioner. Specifikationsoversigten er tilgængelig fra UCIe Consortium .
For halvlederdesignere kan UCIe gøre det nemmere at kombinere chiplets fra forskellige teams, processer eller i sidste ende leverandører. For systemkøbere omsættes en åben die-to-die-standard dog ikke umiddelbart til udskiftelige acceleratormoduler. Emballage, strømforsyning, firmware, hukommelsesgrænseflader, termisk design, sikkerhed, validering og software skal stadig stemme overens. UCIe bør derfor ses som en vigtig byggesten til modulært design snarere end en garanti for plug-and-play-silicium.
Hvad skal du vælge til forskellige behov inden for AI og supercomputere?
Brugerdefineret silicium- eller suveræn infrastruktur
Chiplet-fleksibilitet, adgang til støberier, emballageøkosystem, åbne forbindelser
Heterogene chiplets med avanceret 2,5D/3D-pakning
NRE-omkostninger, valideringstid, pakningskapacitet og udbytte
Sådan evaluerer du en næste generations halvlederplatform uden at blive vildledt af overordnede specifikationer
Start med arbejdsbyrden, ikke chippen. Mål modelstørrelse, antal aktive parametre, kontekstlængde, batchstørrelse, kommunikationsintensitet, præcisionskrav, kontrolpunktsadfærd og forventet udnyttelse. Evaluer derefter hardwaren i forhold til disse begrænsninger.
For beregningsbundne arbejdsbelastninger: sammenlign vedvarende kerneydelse med den præcision, du rent faktisk vil bruge, ikke kun de maksimale FP4- eller FP8-tal.
For hukommelsesbundne arbejdsbelastninger: prioritér effektiv HBM-båndbredde, kapacitet, cacheadfærd og dataflytningsoverhead.
For distribueret træning: mål kollektive operationer såsom all-reduce og all-to-all ved det tilsigtede antal noder.
Til inferens: testtokens pr. sekund, tid til første token, latenstid mellem tokens, samtidighed og energi pr. anmodning ved hjælp af realistiske kontekstlængder.
For HPC: verificér FP64, vektorydeevne, hukommelsesadfærd, compilerkvalitet, MPI-skalering og de præcise videnskabelige biblioteker, der er i brug.
Til planlægning af faciliteter: inkluder rackstrøm, køleteknologi, gulvbelastning, netværksoptik, servicevenlighed og reservekapacitet.
Dette er især vigtigt i 2026, fordi leverandørarkitekturerne er forskellige. NVIDIAs Rubin-platform lægger vægt på tæt integreret rack-skala beregning og netværk; AMDs MI400-familie kombinerer stor HBM4-kapacitet med chiplets og en åben infrastrukturstrategi; Google TPU7x er rettet mod tensor-centriske arbejdsbelastninger gennem en cloud-leveret ASIC; TSMC, Intel, hukommelsesleverandører og standardiseringsorganer ændrer samtidig de fysiske byggesten under dem alle.
Den praktiske konklusion: optimer hele datastien
Den næste generation af halvledere vil drive AI og supercomputing, ikke fordi én enhed vinder alle benchmarks, men fordi industrien lærer at flytte data mere effektivt fra lagring til CPU, fra CPU til accelerator, mellem acceleratorer og mellem stablede dies og HBM. HBM4, chiplets, 2,5D- og 3D-pakning, strømforsyning på bagsiden, hurtige opskaleringslinks og åbne die-to-die-standarder er alle svar på den samme begrænsning: aritmetik er kun nyttig, når data ankommer hurtigt nok og inden for det tilgængelige strømbudget.
For organisationer, der køber infrastruktur i dag, er den sikreste anbefaling arbejdsbelastningsspecifik. Vælg en integreret GPU-platform, når økosystemets modenhed og hurtig skalering er prioriteten. Overvej en åben GPU-platform, når hukommelseskapacitet, infrastrukturfleksibilitet og softwareportabilitet er strategiske. Brug en specialiseret ASIC, når arbejdsbelastningen er præcist knyttet til den, og cloud- eller platformafhængighed er acceptabel. For brugerdefineret silicium, invester i chiplets og avanceret pakning, når ydelses- og produktvolumenforbedringer retfærdiggør den ekstra design- og valideringskompleksitet.
Vigtigst af alt, benchmark komplette systemer under produktionsforhold. Den halvleder, der ser hurtigst ud på et specifikationsark, er måske ikke den, der leverer den laveste pris, den korteste tid til resultat eller den bedste ydeevne pr. watt til din arbejdsbyrde.