Начало
» New Trends
»
Полупроводници от следващо поколение за изкуствен интелект и суперкомпютри: Какво е важно отвъд FLOPS
Полупроводници от следващо поколение за изкуствен интелект и суперкомпютри: Какво е важно отвъд FLOPS
През 2026 г. най-важната промяна в хардуера на изкуствения интелект и суперкомпютрите не е нито един нов транзисторен възел или ускорител. Това е преминаването към проектиране на цялата изчислителна система като една полупроводникова платформа: логика, високоскоростна памет, чиплети, корпус, мащабируеми връзки, мрежова структура, захранване, охлаждане и софтуер – всички те трябва да бъдат ко-оптимизирани. NVIDIA казва, че платформата Vera Rubin вече е в пълно производство, AMD пусна семейството си Instinct MI400 през юли 2026 г., Micron доставя HBM4 в големи количества, а TSMC казва, че N2 е навлязъл в масово производство в края на 2025 г., докато N2P и A16 са планирани за масово производство през втората половина на 2026 г. Тези развития ясно показват един урок: изборът на полупроводници от следващо поколение сега означава избор на системна архитектура, а не просто на чип.
Това е важно, защото „най-добрият“ полупроводник зависи силно от работното натоварване. Клъстер за обучение на граничен модел, национален център за суперкомпютри, услуга за облачен инференциален анализ и внедряване на корпоративен изкуствен интелект могат да благоприятстват различни компромиси. Само пиковите FLOPS са лошо правило за покупка. Капацитетът на паметта, пропускателната способност на паметта, топологията на взаимовръзките, поддържаните числови формати, зрялостта на софтуера, изискванията за охлаждане, наличността и общата системна цена могат да имат също толкова значение.
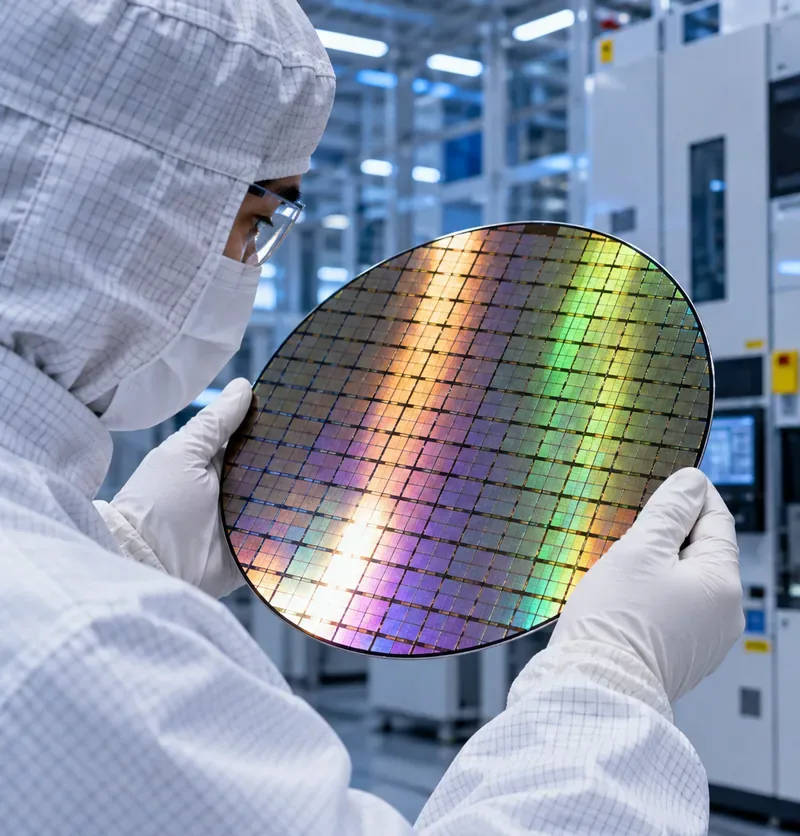
Техник в чиста стая проверява шарена силициева пластина, илюстрирайки прецизното производство зад усъвършенстваните процесори, използвани в изкуствения интелект и високопроизводителните изчисления.
Промяната през 2026 г.: паметта и взаимосвързването вече са първокласни дизайнерски ограничения
Съвременните ускорители с изкуствен интелект могат да извършват аритметични операции по-бързо, отколкото данните винаги могат да им бъдат предоставени. Това прави пропускателната способност на паметта и движението на данни от основно значение за производителността в реалния свят. Micron заявява, че неговият продукт HBM4 36GB 12-high е в масово производство и осигурява над 2,8 TB/s пропускателна способност на стек, използвайки 2048-битов интерфейс, с над 20% по-добра енергийна ефективност от сравнимия си продукт HBM3E. Вижте информацията за продукта HBM4 на Micron и съобщението за производството на HBM4 от март 2026 г.
Компромисът е, че HBM е скъп и изисква интензивно пакетиране. Повече стекове увеличават капацитета и честотната лента, но също така уголемяват пакета, усложняват маршрутизирането и захранването, увеличават топлинната плътност и оказват по-голям натиск върху добива на пакетиране. За изводи, свързани с паметта, големи модели с препоръки, обслужване на LLM с дълъг контекст и научни натоварвания с високо повторно използване на данни, плащането за повече HBM може да има смисъл. За по-малки модели с ниско натоварване на паметта тази премия може да бъде пропиляна.
Вариант 1: интегрирани GPU rack системи за максимален мащаб на AI
NVIDIA Vera Rubin NVL72 илюстрира подхода, ориентиран към системата. NVIDIA публикува конфигурация от 72 графични процесора Rubin и 36 процесора Vera, с 20,7 TB HBM4 в целия шкаф. Един графичен процесор Rubin е посочен с 288 GB HBM4, докато NVLink 6 осигурява до 3,6 TB/s мащабируема честотна лента на графичен процесор. Платформата е проектирана за предварително обучение, последващо обучение, мащабиране по време на тестване и мащабиране на агентен извод в голям мащаб. Актуалните спецификации са налични на страницата на NVIDIA Vera Rubin NVL72 .
Предимството е интеграцията. Изчисленията, съгласуваността между процесора и графичния процесор (CPU), мащабируемата структура, работата в мрежа, управлението на системата и софтуерът са проектирани заедно. Това може да намали риска от сглобяване на голям клъстер от независимо оптимизирани компоненти. Това е особено привлекателно, когато времето за внедряване и зрялата екосистема от GPU софтуер са по-важни от архитектурната отвореност.
Компромисът е ангажиментът към тясно интегрирана платформа. Големите системи за шкафове също изискват значително планиране на съоръженията, включително течно охлаждане, електрическо разпределение и мрежов дизайн. Купувачите трябва да сравняват доставяната пропускателна способност на приложенията за шкаф и за мегават, не само спецификациите на ускорителя. Публикуваните от доставчиците стойности за пикова производителност са теоретични или специфични за работното натоварване и трябва да бъдат валидирани с действителния модел, размера на партидата, дължината на последователността, числената точност и модела на комуникация, който ще работи в производствена среда.
Вариант 2: GPU системи с по-голямо количество чиплети и по-отворена инфраструктурна стратегия
Серията Instinct MI400 на AMD поема по различен път, като същевременно преследва същата цел на системно ниво. MI455X комбинира чиплети, HBM4, усъвършенствана опаковка и Infinity Fabric. AMD посочва до 432 GB HBM4 и до 23,3 TB/s пикова теоретична пропускателна способност на паметта на графичен процесор MI455X. Референтният дизайн на Helios за шкафове комбинира 72 графични процесора MI455X и е изграден около стандарти за отворена инфраструктура. AMD казва, че масово внедряване, базирано на Helios, се очаква през втората половина на 2026 г. Вижте страницата за серията AMD Instinct MI400 .
Този подход е привлекателен, когато капацитетът на паметта, модулността на чиплетите, ROCm и стандартите за отворени стелажи или взаимосвързване са стратегически приоритети. По-локалната HBM може да намали натиска върху разделянето на модела и може да помогне за работни натоварвания при извеждане на данни с големи KV кешове или работни натоварвания, които иначе биха разпръсквали данни между ускорителите.
Компромисът е валидирането на софтуера. Една платформа може да има силни силициеви спецификации, но все пак да изисква инженерна работа, ако критична рамка, ядро, модел на колективна комуникация или персонализиран оператор са по-добре оптимизирани другаде. Организациите, които обмислят AMD, трябва да сравняват собствените си тръбопроводи за обучение и извод в ROCm, вместо да приемат, че преносимостта автоматично означава еднаква производителност.
Вариант 3: специализирани AI ASIC чипове, когато съответствието на работното натоварване е по-важно от общоприетостта
TPU7x на Google, известен още като Ironwood, показва предимствата на ускорител, специфичен за домейна. Google Cloud посочва 192 GB HBM на чип, около 7,38 TB/s HBM честотна лента, 1,2 TB/s двупосочна междучипова взаимовръзка и големи pod конфигурации. Архитектурата е изградена около тензорни и разредени изчисления, вместо да се опитва да обслужва всеки възможен случай на употреба на ускорителя. Технически подробности са налични в документацията на Google Cloud TPU7x .
Специализиран ускорител може да бъде силен избор, когато целевите модели се съпоставят ясно с неговия компилатор, числови формати, йерархия на паметта и поддържани рамки. Облачната доставка може също така да премахне голяма част от натоварването на съоръженията, свързано с притежаването на голям клъстер с изкуствен интелект.
Компромисът е преносимостта и обхватът на работното натоварване. Ако една организация разчита на ниско ниво CUDA-специфичен код, необичайни ядра, нишови научни библиотеки или приложения извън „сладката зона“ на ускорителя, разходите за миграция могат да надхвърлят ефективността на хардуера. Следователно правилното сравнение е време до постигане на резултат и съотношение цена-резултат за действителния софтуерен стек.
Усъвършенстваното опаковане става също толкова важно, колкото и мащабирането на транзисторите
Водещите AI процесори са твърде сложни, за да се третират пакетирането като пасивна последна стъпка. Платформата CoWoS на TSMC интегрира логика и HBM, използвайки големи интерпозери, докато SoIC технологията поддържа 3D подреждане на чипове с високоплътни междучипови връзки. TSMC заявява, че 3nm SoIC подреждането е навлязло в масово производство през 2025 г. Технологията CoWoS-L също е надхвърлила конвенционалните ограничения за размера на решетката за големи AI и HPC пакети. Вижте официалните страници на TSMC за технологиите CoWoS и SoIC .
Intel Foundry преследва подобна цел с EMIB и Foveros. EMIB използва вградени силициеви мостове за свързване на кристали с висока плътност, без да е необходим пълен силициев интерпозер в целия корпус. Foveros добавя вертикално подреждане, докато Foveros Direct използва хибридно свързване мед-към-мед за много фини връзки между кристали. Intel описва тези технологии на страницата си за усъвършенствани корпуси .
Инженерният избор не е просто „2.5D срещу 3D“. Дизайнерите трябва да балансират плътността на взаимовръзките, размера на корпуса, термичното поведение, стратегията за известните добри кристали, добив, сложността на сглобяване и цената. 3D стекът може да скъси връзките и да подобри плътността на честотната лента, но вертикалното подреждане на горещи изчислителни кристали може да затрудни отвеждането на топлината. 2.5D архитектурата може да бъде по-лесна за охлаждане и тестване, но може да изисква по-голям размер и по-дълги взаимовръзки.
Възлите на водещите процеси все още имат значение, но по специфични причини
Мащабирането на транзисторите остава важно, тъй като системите с изкуствен интелект и високопроизводителни изчисления (HPC) са с ограничена мощност. TSMC съобщава, че технологията N2 е навлязла в масово производство през четвъртото тримесечие на 2025 г., използвайки нанолистови транзистори, а N2P и A16 са планирани за масово производство през втората половина на 2026 г. A16 добавя захранване отзад, което измества насочването на захранването далеч от сигналните слоеве отпред и е насочено към взискателни HPC проекти с гъсти захранващи мрежи. Вижте страницата за технологията на TSMC A16 .
18A възелът на Intel по подобен начин комбинира архитектура с транзистор с гейт-авъртане, наречена RibbonFET, със захранване отзад, наречено PowerVia. През юни 2026 г. Intel заяви, че 18A е влязъл в производство през 2025 г. и че 18A-P е влязъл в рисково производство. Вижте актуализацията на процеса на Intel Foundry за 2026 г.
Компромисът е между зрялост и максимална ефективност. Нов възел може да подобри производителността, плътността или мощността, но зрелите възли често предлагат по-добър добив, по-ниска цена и по-утвърдена екосистема от дизайнерски решения. Чиплетните архитектури правят този избор по-малко двоичен: изчислителните плочки могат да използват най-новия възел, докато входно/изходните, кеш, аналогови или интерфейсни чипове остават на по-стари, по-евтини процеси.
Отворените чиплетни стандарти могат да намалят зависимостта, но оперативната съвместимост не е автоматична
UCIe е проектиран да стандартизира високоскоростната комуникация между чиплети. UCIe 3.0 поддържа скорости на данни от 48 GT/s и 64 GT/s, удвоявайки максималната скорост на данни на UCIe 2.0, като същевременно запазва обратна съвместимост. Той също така разширява функциите за управление и пестене на енергия. Прегледът на спецификациите е наличен от UCIe Consortium .
За дизайнерите на полупроводници, UCIe може да улесни комбинирането на чиплети от различни екипи, процеси или евентуално доставчици. За купувачите на системи обаче, отвореният стандарт „чип-към-чип“ не се превръща веднага във взаимозаменяеми ускорителни модули. Корпусът, захранването, фърмуерът, интерфейсите на паметта, термичният дизайн, сигурността, валидирането и софтуерът все още трябва да се съгласуват. Следователно UCIe трябва да се разглежда като важен градивен елемент за модулния дизайн, а не като гаранция за plug-and-play силиций.
Какво трябва да изберете за различните нужди на изкуствения интелект и суперкомпютрите?
Основна нужда
Какво да се приоритизира
Вероятна архитектурна посока
Основен компромис за проверка
Обучение по модела Frontier
Увеличаване на честотната лента, капацитет на HBM, колективна производителност, зрялост на софтуера
Интегрирани GPU системи за шкафове
Захранване, охлаждане, работа в мрежа и обща цена на клъстера
Високообемни LLM изводи
Капацитет на паметта, пропускателна способност на паметта, пропускателна способност с ниска прецизност, цена на токен
GPU стелажи или специализирани AI ускорители
Латентност при целево паралелизъм и съответствие на модела
Научно високопроизводително изчисление (HPC)
Производителност на FP64, пропускателна способност на паметта, MPI/комуникационен стек, валидирани библиотеки
HPC-фокусирани графични процесори плюс високопроизводителни процесори и мрежова структура
Преносимост на приложенията и числени изисквания
Облачен изкуствен интелект със стандартизирани модели
Осигурена пропускателна способност, управлявано мащабиране, поддръжка на компилатор, оперативна простота
Облачен графичен процесор или облачен изкуствен интелект ASIC
Преносимост и дългосрочна зависимост от платформата
Персонализирана силициева или суверенна инфраструктура
Гъвкавост на чиплетите, достъп до леярна, екосистема за пакетиране, отворени взаимовръзки
Хетерогенни чиплети с усъвършенствана 2.5D/3D опаковка
Цена на NRE, време за валидиране, капацитет на опаковката и добив
Как да оценим полупроводникова платформа от следващо поколение, без да бъдем подвеждани от водещите спецификации
Започнете с работното натоварване, а не с чипа. Измерете размера на модела, броя на активните параметри, дължината на контекста, размера на партидата, интензитета на комуникация, изискванията за точност, поведението при контролни точки и очакваното използване. След това оценете хардуера спрямо тези ограничения.
За натоварвания, свързани с изчисления: сравнете устойчивата производителност на ядрото с точността, която действително ще използвате, не само пиковите стойности на FP4 или FP8.
За работни натоварвания, ограничени от паметта: приоритизирайте ефективната пропускателна способност на HBM, капацитета, поведението на кеша и разходите за движение на данни.
За разпределено обучение: измервайте колективни операции като „all-reduce“ и „all-to-all“ при желания брой възли.
За извод: тестови токени в секунда, време до първия токен, латентност между токените, едновременност и енергия на заявка, използвайки реалистични дължини на контекста.
За HPC: проверете FP64, производителността на векторите, поведението на паметта, качеството на компилатора, MPI мащабирането и точните научни библиотеки, които се използват.
За планиране на съоръжения: включете захранване на стелажи, технология за охлаждане, натоварване на пода, мрежова оптика, обслужваемост и свободен капацитет.
Това е особено важно през 2026 г., защото архитектурите на доставчиците се различават. Платформата Rubin на NVIDIA набляга на тясно интегрирани изчисления и мрежи в шкафове; семейството MI400 на AMD комбинира голям HBM4 капацитет с чиплети и стратегия за отворена инфраструктура; Google TPU7x е насочен към тензорно-центрирани натоварвания чрез облачно доставяна ASIC; TSMC, Intel, доставчиците на памет и организациите по стандартизация едновременно променят физическите градивни елементи под всички тях.
Практическото заключение: оптимизирайте целия път на данните
Следващото поколение полупроводници ще захранва изкуствения интелект и суперкомпютрите не защото едно устройство печели всеки бенчмарк, а защото индустрията се учи да премества данни по-ефективно от хранилището към процесора, от процесора към ускорителя, между ускорителите и между подредени кристали и HBM. HBM4, чиплетите, 2.5D и 3D опаковките, захранването отзад, бързите мащабируеми връзки и отворените стандарти от кристал до кристал са все отговори на едно и също ограничение: аритметиката е полезна само когато данните пристигат достатъчно бързо и в рамките на наличния енергиен бюджет.
За организациите, които купуват инфраструктура днес, най-безопасната препоръка е специфична за работното натоварване. Изберете интегрирана GPU платформа, когато зрялостта на екосистемата и бързото мащабиране са приоритет. Помислете за отворена GPU платформа, когато капацитетът на паметта, гъвкавостта на инфраструктурата и преносимостта на софтуера са стратегически. Използвайте специализиран ASIC, когато работното натоварване е ясно свързано с него и зависимостта от облака или платформата е приемлива. За персонализиран силициев диоксид, инвестирайте в чиплети и усъвършенствани конфигурации, когато печалбите от производителност и обем на продукта оправдават допълнителната сложност на дизайна и валидирането.
Най-важното е да сравнявате цялостни системи в производствени условия. Полупроводникът, който изглежда най-бърз в спецификацията, може да не е този, който предлага най-ниската цена, най-краткото време за постигане на резултат или най-добрата производителност на ват за вашето работно натоварване.